Las operaciones Postgres DELETE tienen fama de tener una mala escalabilidad en entornos de alto rendimiento. Esta reputación proviene del Control de Concurrencia de Multiversión (MVCC), el mecanismo que utiliza Postgres para garantizar el aislamiento de las transacciones. En lugar de eliminar físicamente una fila, Postgres la marca como 'muerta' sellándola con un ID de transacción. Esto permite que otras transacciones concurrentes vean una instantánea consistente de los datos. Sin embargo, esto crea un 'giro' o 'churn', donde las tuplas muertas se acumulan y deben ser reclamadas por un proceso llamado VACUUM. Para sistemas que requieren una retención de datos compleja —donde diferentes tipos de datos deben conservarse durante duraciones distintas— la flexibilidad de un DELETE estándar suele preferirse sobre la estructura rígida de eliminar particiones de bases de datos completas.
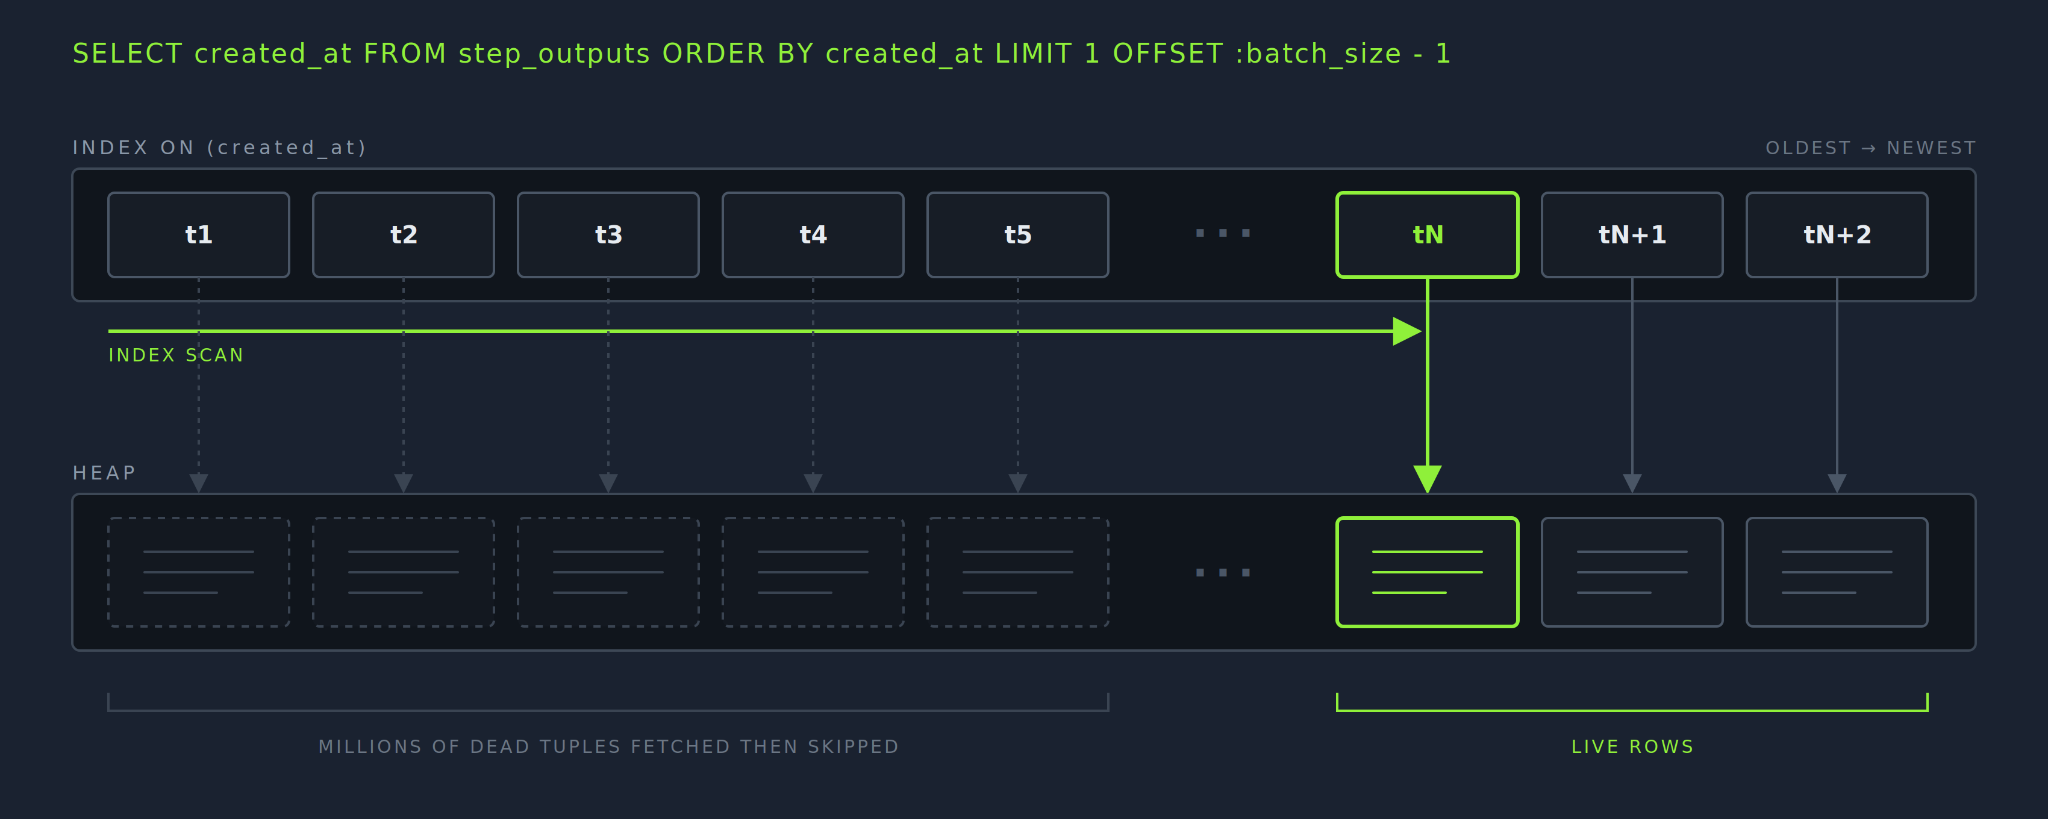
Este gráfico visualiza los cuellos de botella de rendimiento y el impacto del giro de MVCC en las velocidades de eliminación.
Los ingenieros de DBOS encontraron cuellos de botella de rendimiento significativos al implementar políticas de retención para un sistema de flujo de trabajo duradero. El problema principal era la falta de localidad de caché. Debido a que los flujos de trabajo consisten en muchos pasos registrados en tablas separadas, el uso de una llave foránea estándar 'ON DELETE CASCADE' obligaba a Postgres a buscar páginas de datos ampliamente separadas en el disco para cada eliminación de paso. Para resolver esto, el equipo eliminó las llaves foráneas y pasó a una estrategia de eliminación por fases. Al eliminar las filas en su orden de creación física, aseguraron que la base de datos pudiera reutilizar las páginas en caché, mejorando significativamente el rendimiento. También implementaron un 'anti-join' para asegurar que los datos asociados con flujos de trabajo aún activos no fueran purgados accidentalmente durante estas operaciones por lotes.
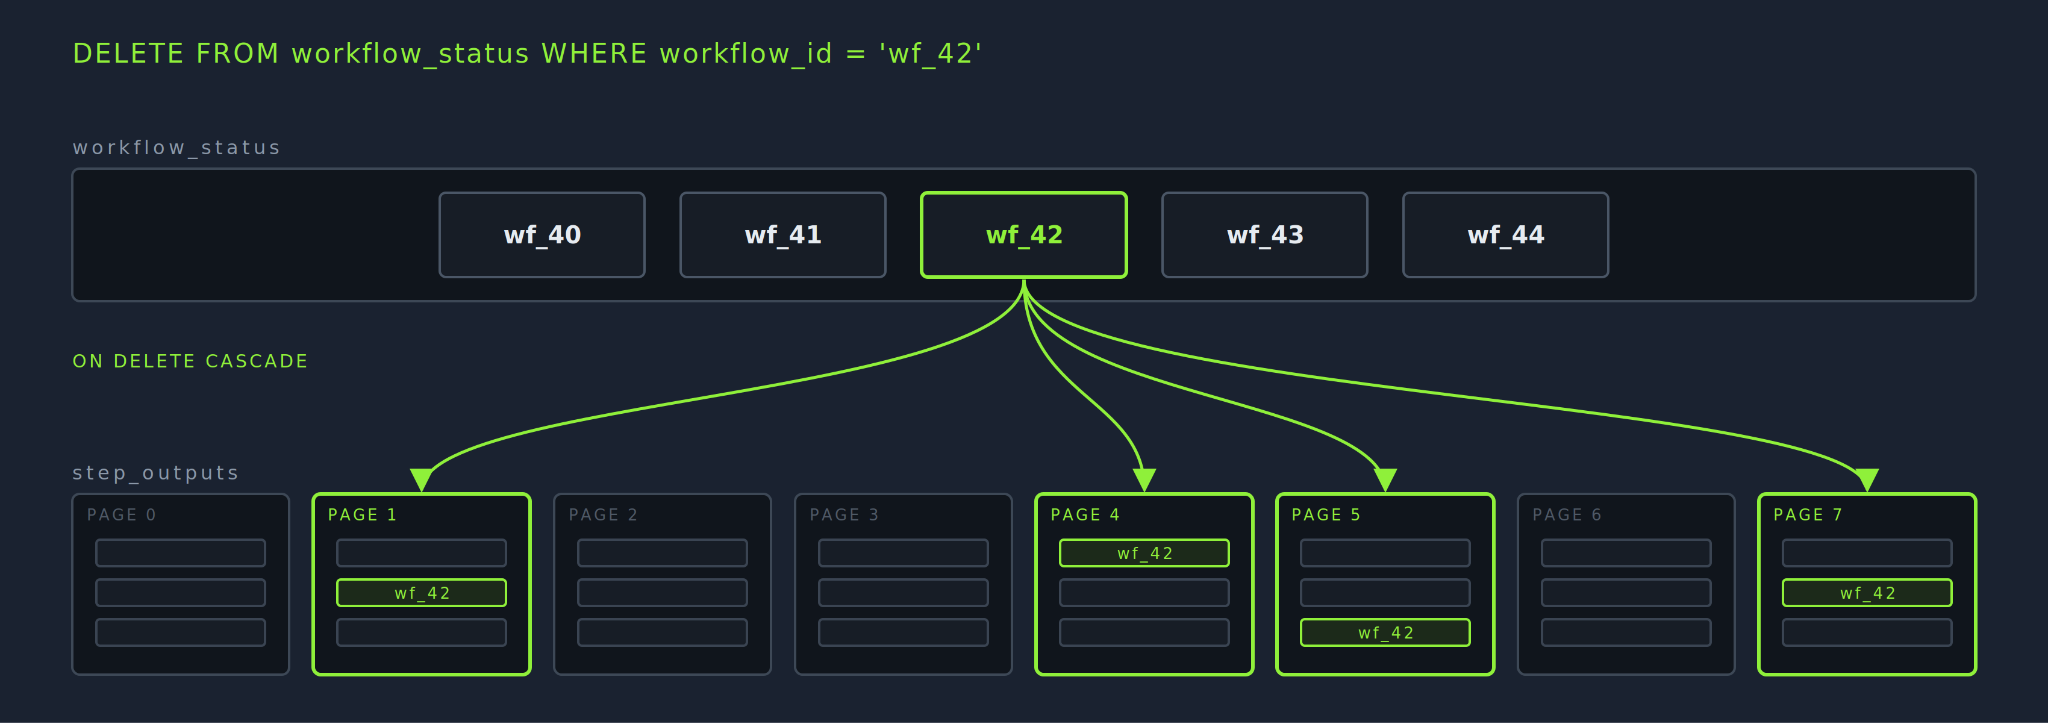
Este diagrama explica la relación estructural entre flujos de trabajo y pasos que el equipo optimizó.
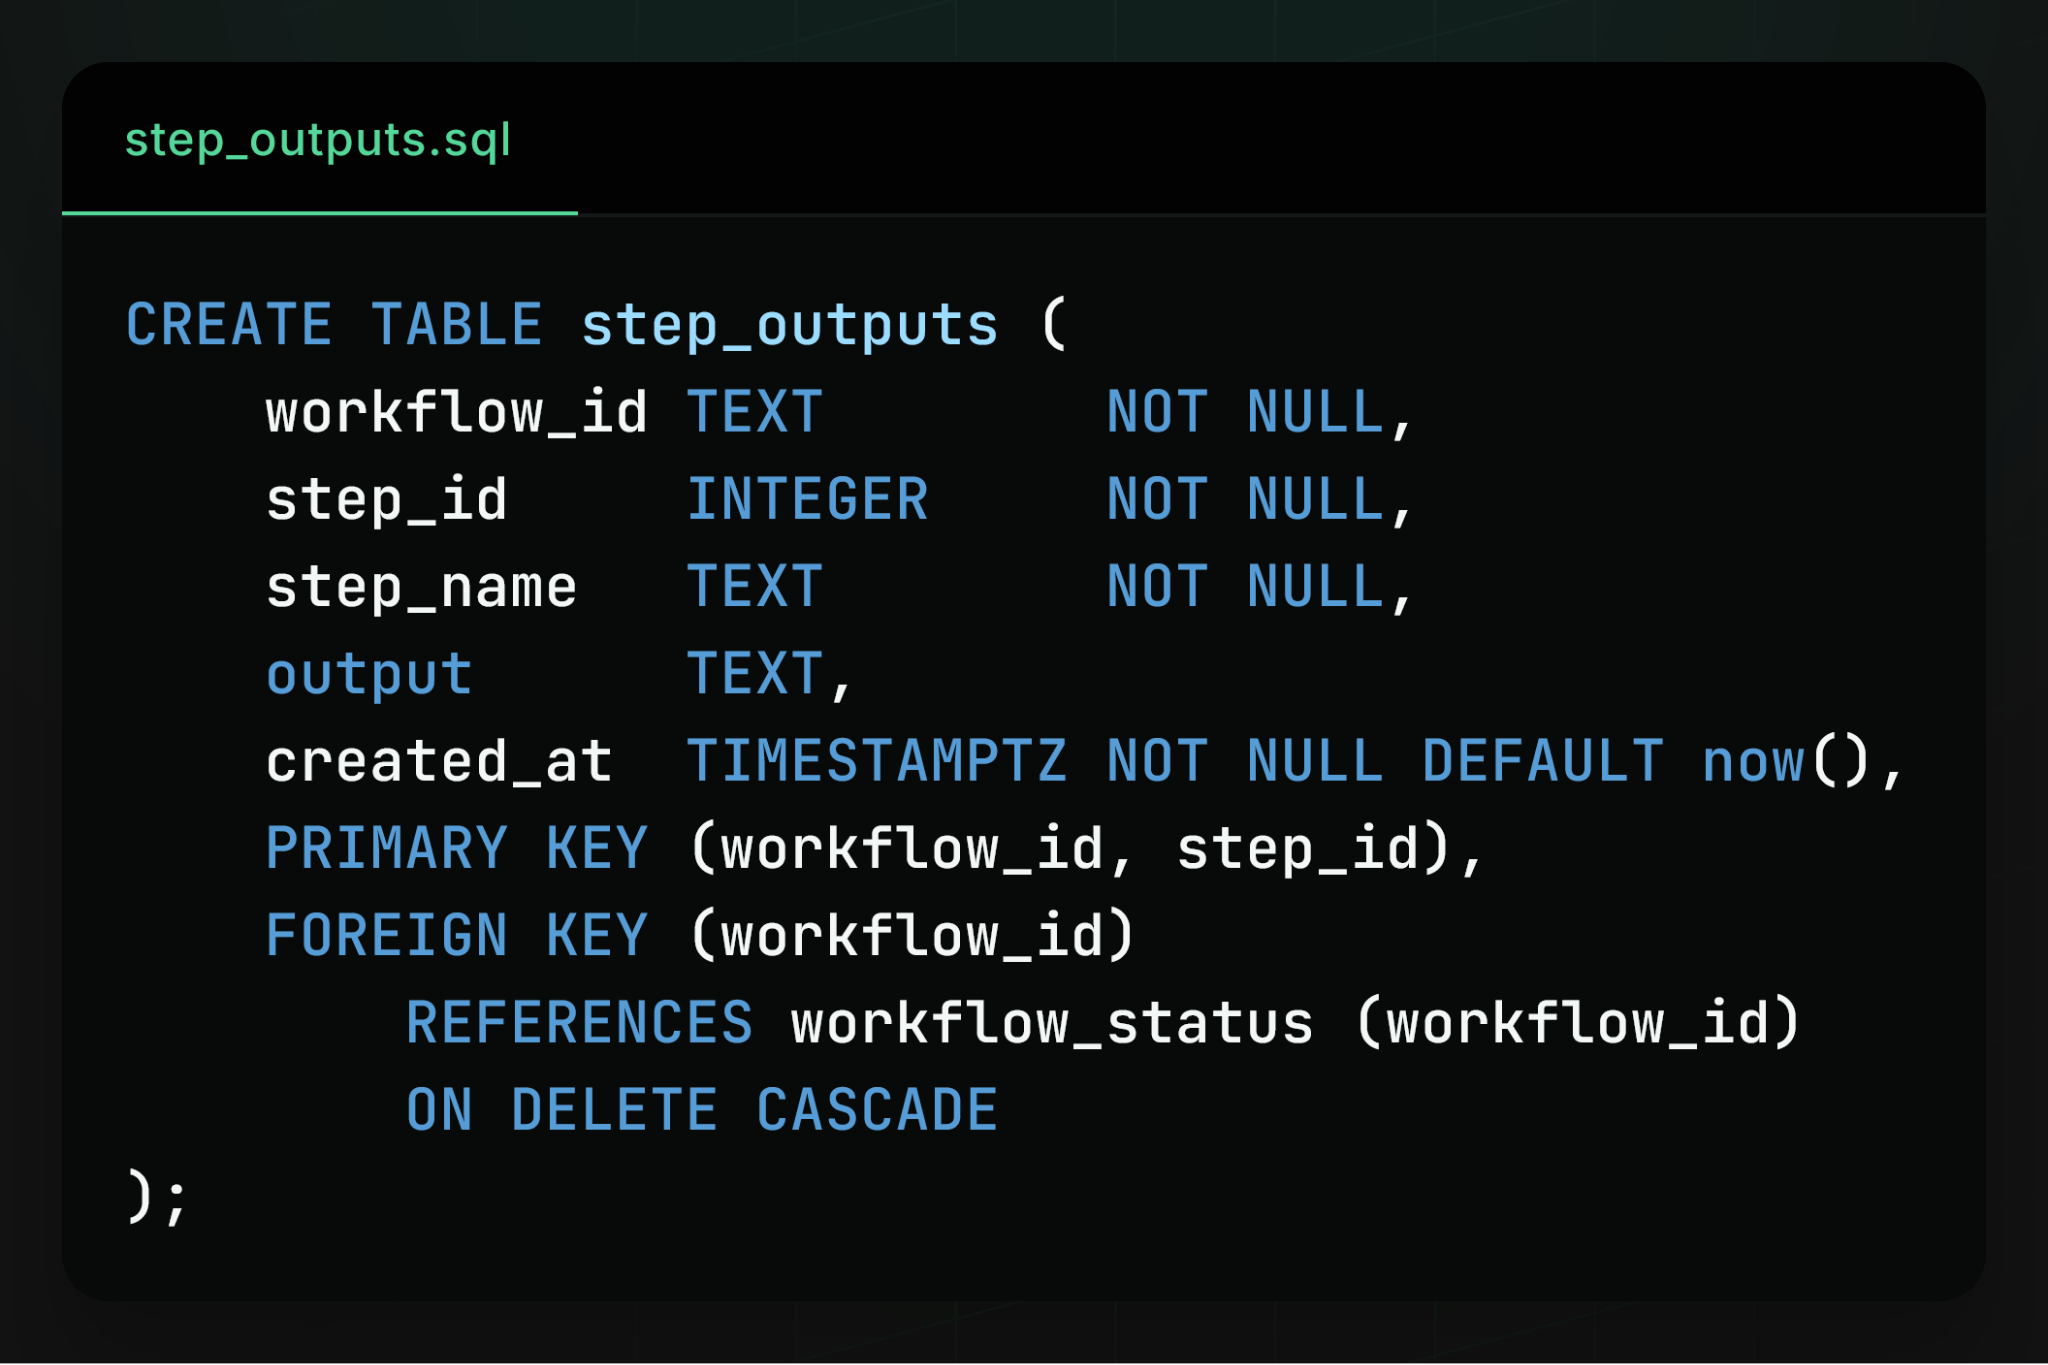
Este fragmento de SQL representa el enfoque estándar 'ON DELETE CASCADE' del que el equipo se alejó.
A pesar de estas mejoras, el equipo descubrió un error de búsqueda de índice 'patológico' donde una consulta simple tardaba 20 minutos en completarse. Esto ocurrió porque Postgres no actualiza las entradas del índice de forma síncrona durante un DELETE; una consulta que recorre un índice podría encontrarse con millones de tuplas muertas que aún no han sido limpiadas por el autovacuum. Para resolver esto, el equipo introdujo operaciones de VACUUM manuales antes y después de cada pasada de retención. Esta combinación de eliminar llaves foráneas para mejorar la localidad de caché, usar anti-joins para mayor seguridad y realizar vacuum manual para limpiar las rutas de los índices permitió que su sistema procesara decenas de miles de flujos de trabajo y pasos por segundo mientras mantenía políticas estrictas de retención de datos.