Un ensayo reciente sostiene que la inteligencia del aprendizaje automático se está abaratando tanto que el número de tokens consumidos pronto podría importar menos que la calidad de los resultados y el acceso. Un token es una pequeña unidad de texto; el ensayo calcula aproximadamente 1,5 tokens por palabra. Distingue los precios brutos por token del coste por tarea completada, porque un modelo más pequeño a veces puede consumir más tokens mientras razona o se autocorrige.
El mecanismo central no es un único avance. El autor combina la mejora de la eficiencia de las unidades de procesamiento gráfico (GPU), un mejor software de inferencia y diseños de modelos que activan menos parámetros por solicitud. Los modelos de mezcla de expertos, por ejemplo, derivan el trabajo hacia componentes especializados seleccionados en lugar de ejecutar todas las partes de la red. El ensayo calcula una reducción de unas 2,5 órdenes de magnitud en el coste por token durante el último año, incluidos una mejora de la eficiencia de costes por tarea de aproximadamente 100 veces, una mejora de la eficiencia energética del hardware de 1,3 veces y una mejora de la eficiencia del motor de inferencia de 1,4 veces.
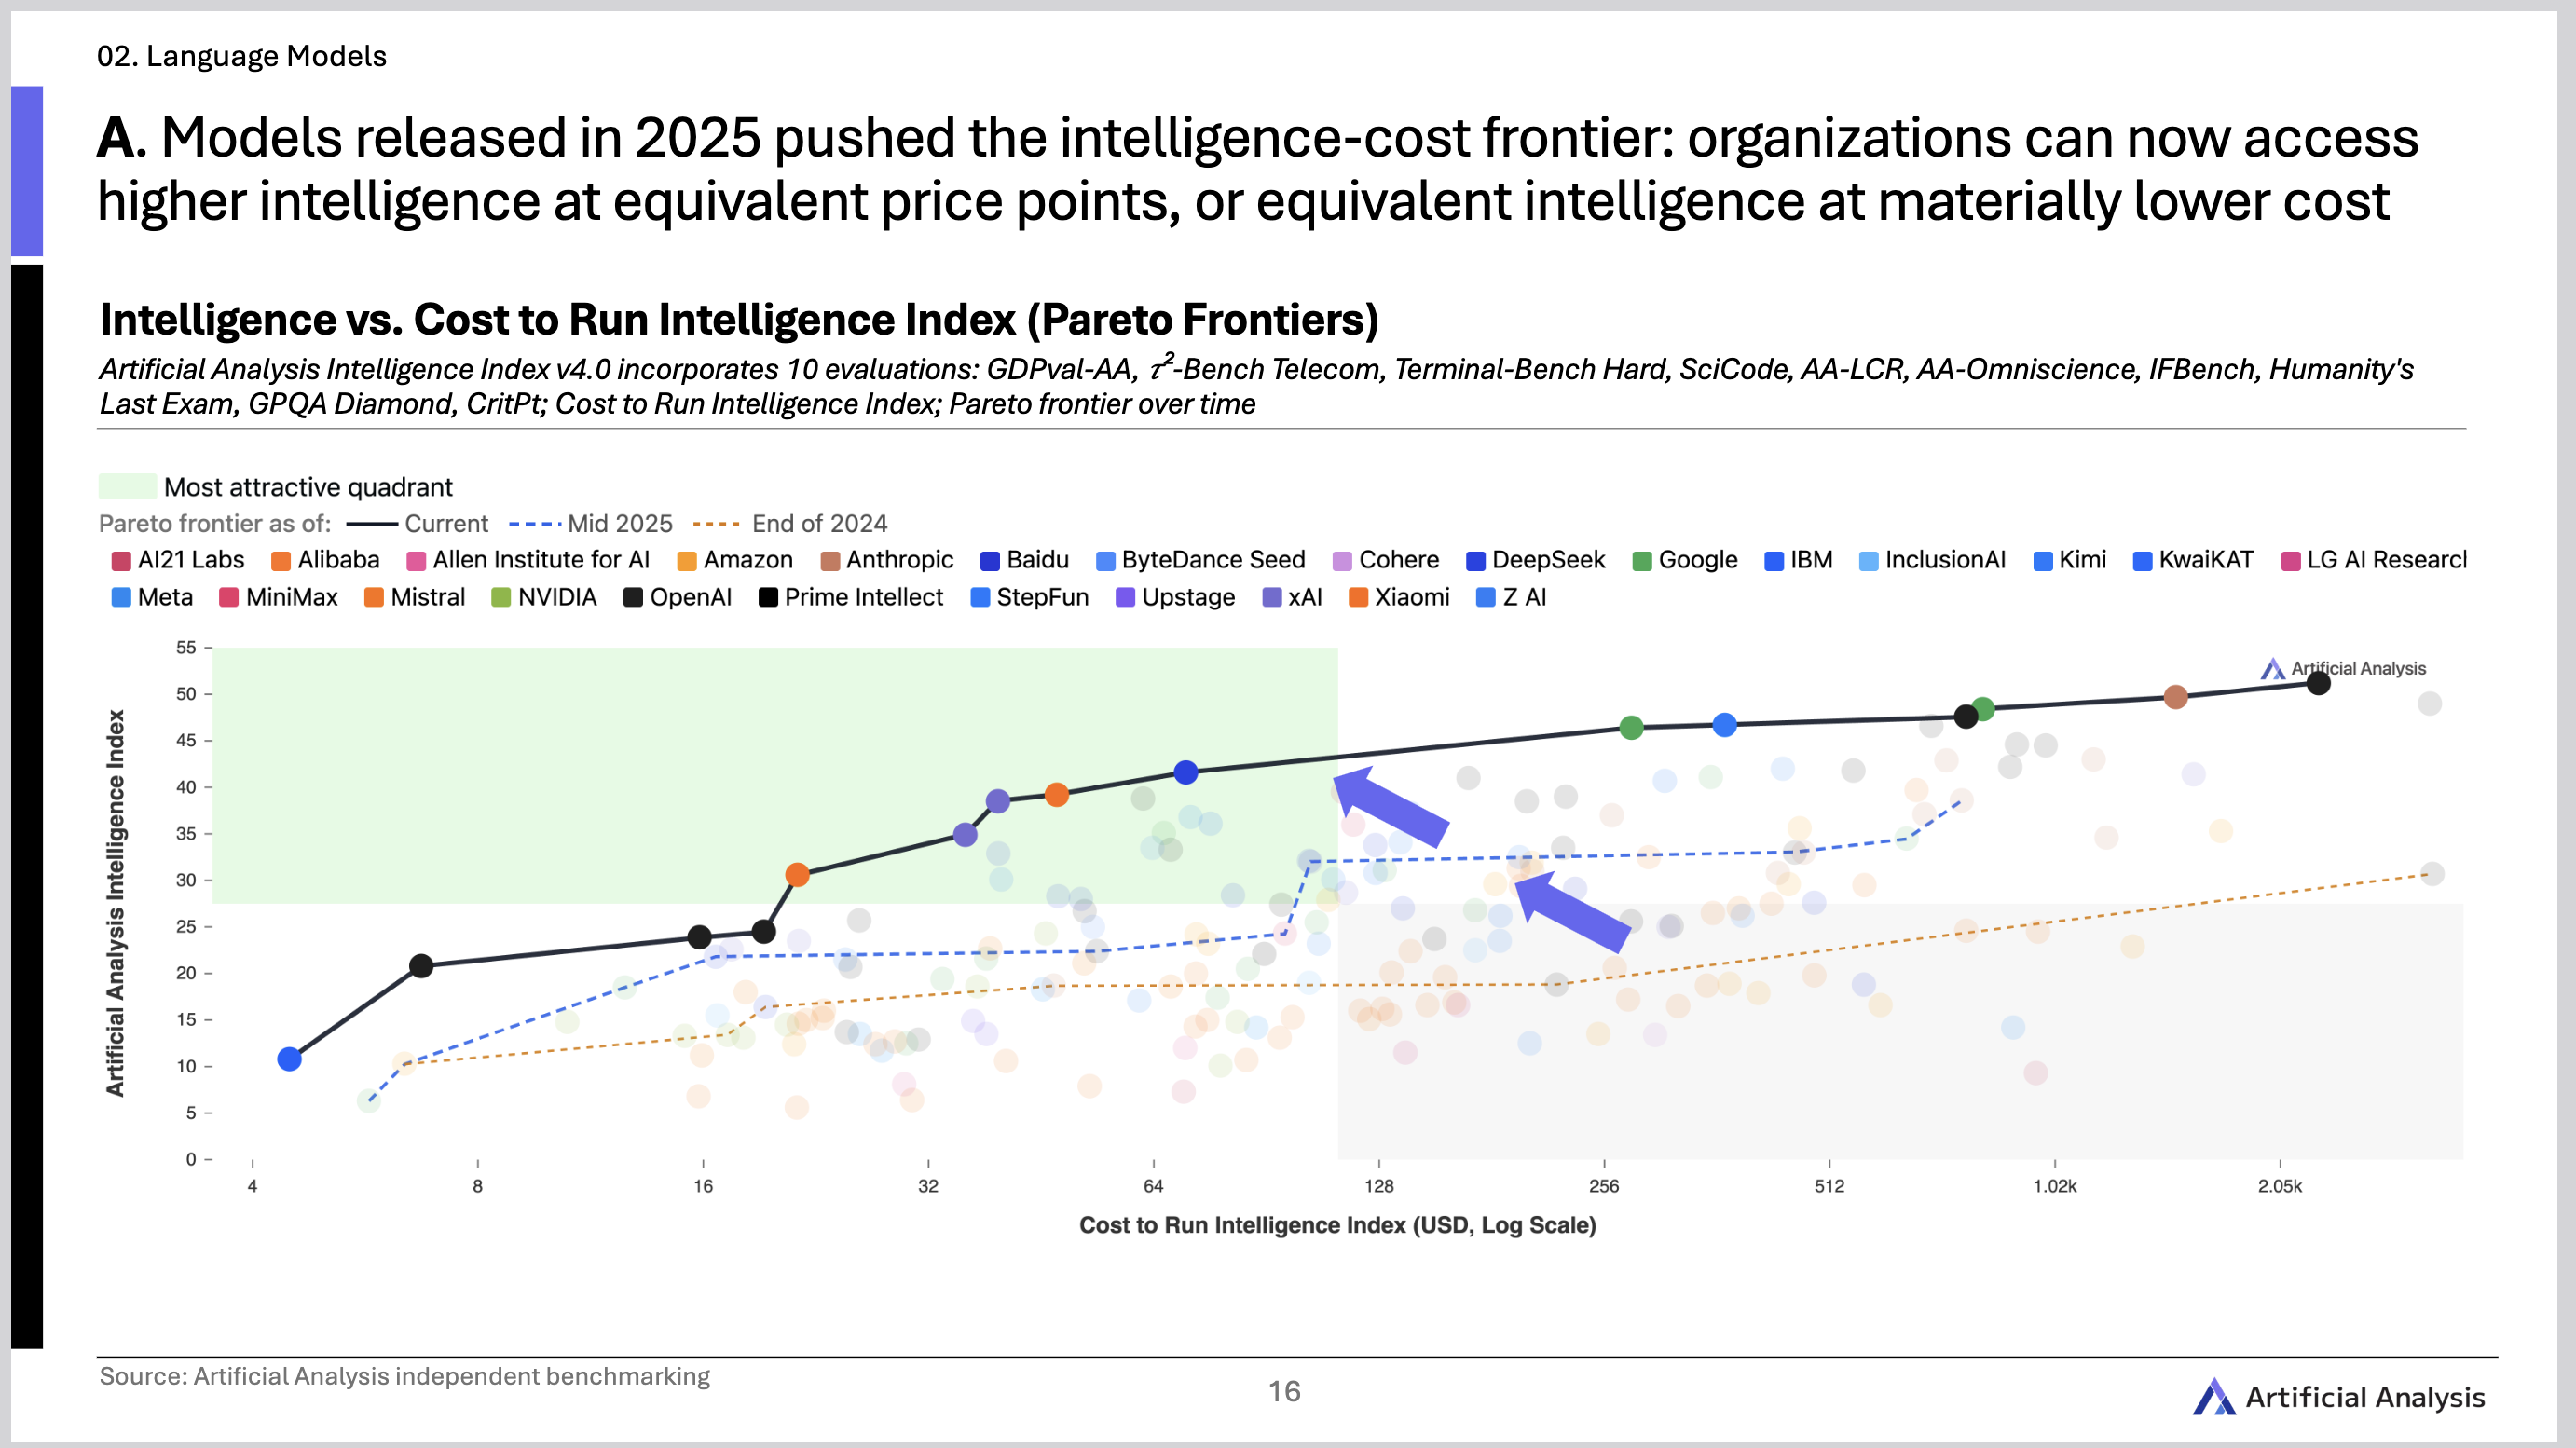
Colocado después de que el artículo explica la disminución medida de los costes por token y el cambio de los precios brutos por token al coste por tarea completada.
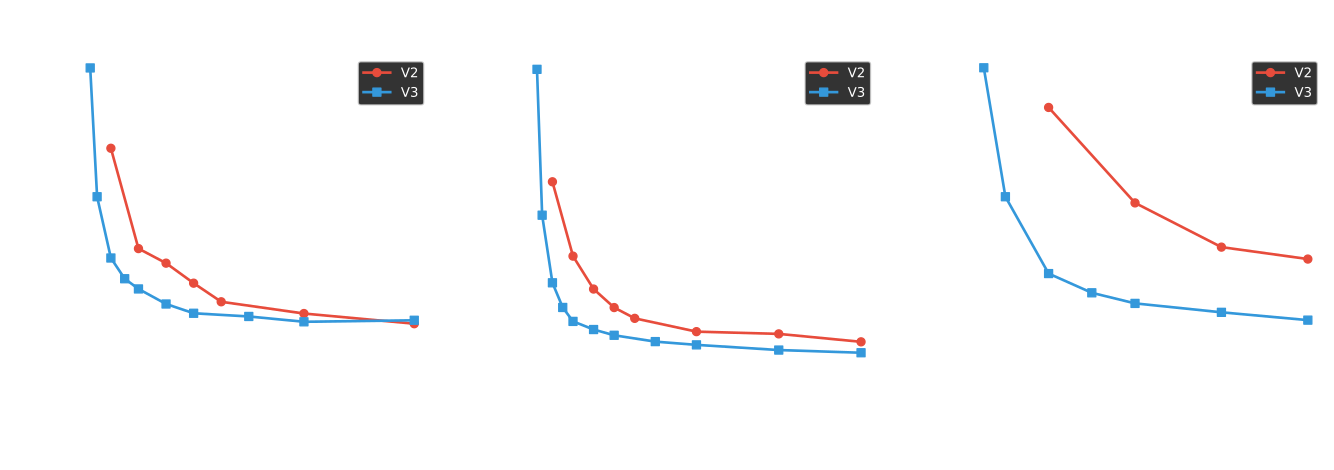
Colocado después de que el artículo identifica la eficiencia de las GPU, el software de inferencia y el diseño de modelos como mecanismos separados que reducen el coste de la inferencia.
Las páginas de modelos suministradas ilustran el cambio arquitectónico. Muse Glimmer es un modelo local de 30.000 millones de parámetros cuyo editor afirma que la cuantización de 4 bits lo reduce a menos de 20 GB, lo que deja margen para ejecutarlo dentro de un límite de memoria de 24 GB o 32 GB. Qwen3-Coder-30B-A3B-Instruct tiene 30.500 millones de parámetros en total, pero activa 3.300 millones por solicitud, con 8 de 128 expertos utilizados a la vez; admite un contexto nativo de 262.144 tokens, ampliable a 1 millón con Yarn. Estas son especificaciones del editor, no una prueba independiente del rendimiento típico del usuario.
Si la inferencia se abarata lo suficiente, sostiene el ensayo, los modelos podrían integrarse en herramientas ordinarias en lugar de seguir siendo productos de chat separados. Su comparación aproximada sitúa un turno de modelo varios órdenes de magnitud por encima del coste eléctrico de comandos como grep, el análisis de HTML o la compilación de código. Eso haría prácticos el filtrado, la programación o la clasificación asistidos por IA en lugares donde una interfaz conversacional completa sería un despilfarro. La comparación es, sin embargo, ilustrativa: utiliza recuentos estimados de tokens, consumo energético local y precios de la electricidad, en lugar de una prueba de referencia controlada de extremo a extremo.
La mayor incertidumbre es si la tendencia continuará. Las ganancias de eficiencia pueden toparse con límites de hardware, cuellos de botella de software o rendimientos decrecientes, y los menores costes pueden simplemente fomentar usos que consuman más cálculo. El paquete tampoco contiene un estudio independiente de costes que valide la previsión combinada del ensayo. Lo que respalda es una conclusión más limitada: varias partes de la pila de IA están mejorando rápidamente, y su efecto combinado podría hacer que algunas llamadas a modelos resulten sorprendentemente baratas. Si eso genera valor económico duradero, en lugar de un mero aumento del consumo, sigue sin estar demostrado.