La optimización de consultas, el proceso mediante el cual una base de datos determina la forma más eficiente de recuperar y unir datos, es una tarea computacionalmente difícil. Específicamente, determinar el orden de unión óptimo para un conjunto de tablas se conoce como un problema NP-hard. Para una consulta que involucra solo tres tablas, puede haber más de 4,600 combinaciones diferentes de árboles de unión, orientaciones, algoritmos y tipos de escaneo. Si bien las bases de datos profesionales como Postgres utilizan programación dinámica y algoritmos genéticos para podar este espacio de búsqueda, aún pueden producir planes subóptimos, especialmente a medida que aumenta el número de uniones.
En un experimento para abordar esto, Rohan Bansal entrenó un modelo de 4B parámetros para generar planes de consulta de Postgres. El modelo tuvo dificultades inicialmente, fallando en producir un plan válido para el 99% de las consultas de prueba. Sin embargo, a través de un proceso de entrenamiento de múltiples etapas que involucró ajuste fino supervisado (SFT) y aprendizaje por refuerzo (RL) agéntico, el modelo finalmente logró una reducción de latencia del 44.7% en 113 consultas con muchas uniones en comparación con los planes predeterminados de Postgres. El entrenamiento utilizó destilación fuera de política de trayectorias de agentes GPT-6 Astra y una variante personalizada de GRPO (Group Relative Policy Optimization). Este enfoque de RL asignó recompensas escalares basadas en el tiempo de ejecución real de los planes, empujando los pesos del modelo hacia estrategias que resultaron en una finalización de consultas más rápida.
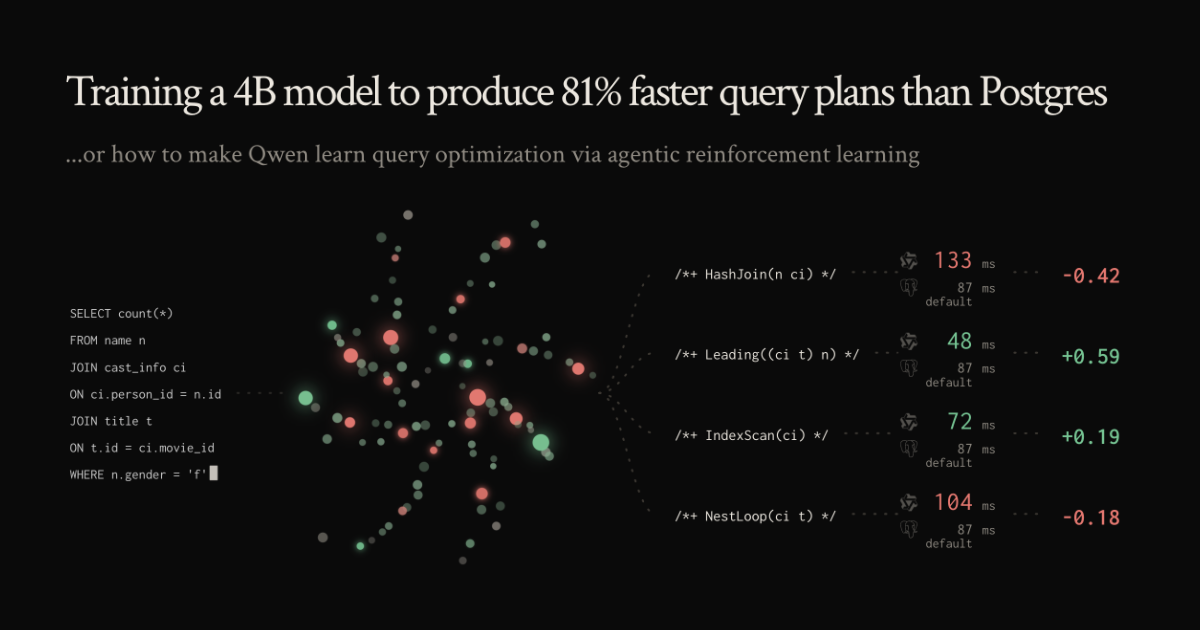
El modelo logró una reducción de latencia del 44.7% en 113 consultas con muchas uniones a través de un proceso de entrenamiento de múltiples etapas.
A pesar de estos resultados, la transición de un experimento controlado a un entorno de producción implica compensaciones significativas. El experimento se realizó en un conjunto de datos de 8GB que cabe completamente en memoria, lo que puede no reflejar con precisión cómo funcionan estos planes en cargas de trabajo OLTP (Procesamiento de Transacciones en Línea) masivas y de alta concurrencia, donde la contención del caché de páginas y la E/S de disco se convierten en factores dominantes. Además, existe el riesgo de 'sobreajuste' a formas de datos específicas; si las correlaciones de datos subyacentes cambian o si el modelo omite un índice específico debido a una alucinación, el plan podría fallar. En última instancia, incluso un plan generado por IA está limitado por la precisión de las estadísticas subyacentes de la base de datos; si el orden lógico de los datos no se captura perfectamente, incluso el optimizador más sofisticado puede tener dificultades para encontrar la ruta verdaderamente óptima.