Qwen3.8 27B es un modelo de lenguaje de 27 mil millones de parámetros de la serie Qwen3.8. La variante completa BF16 (punto flotante de 16 bits) de este modelo ocupa aproximadamente 55 GB, superando la capacidad de memoria de la mayoría de las GPU de consumo.
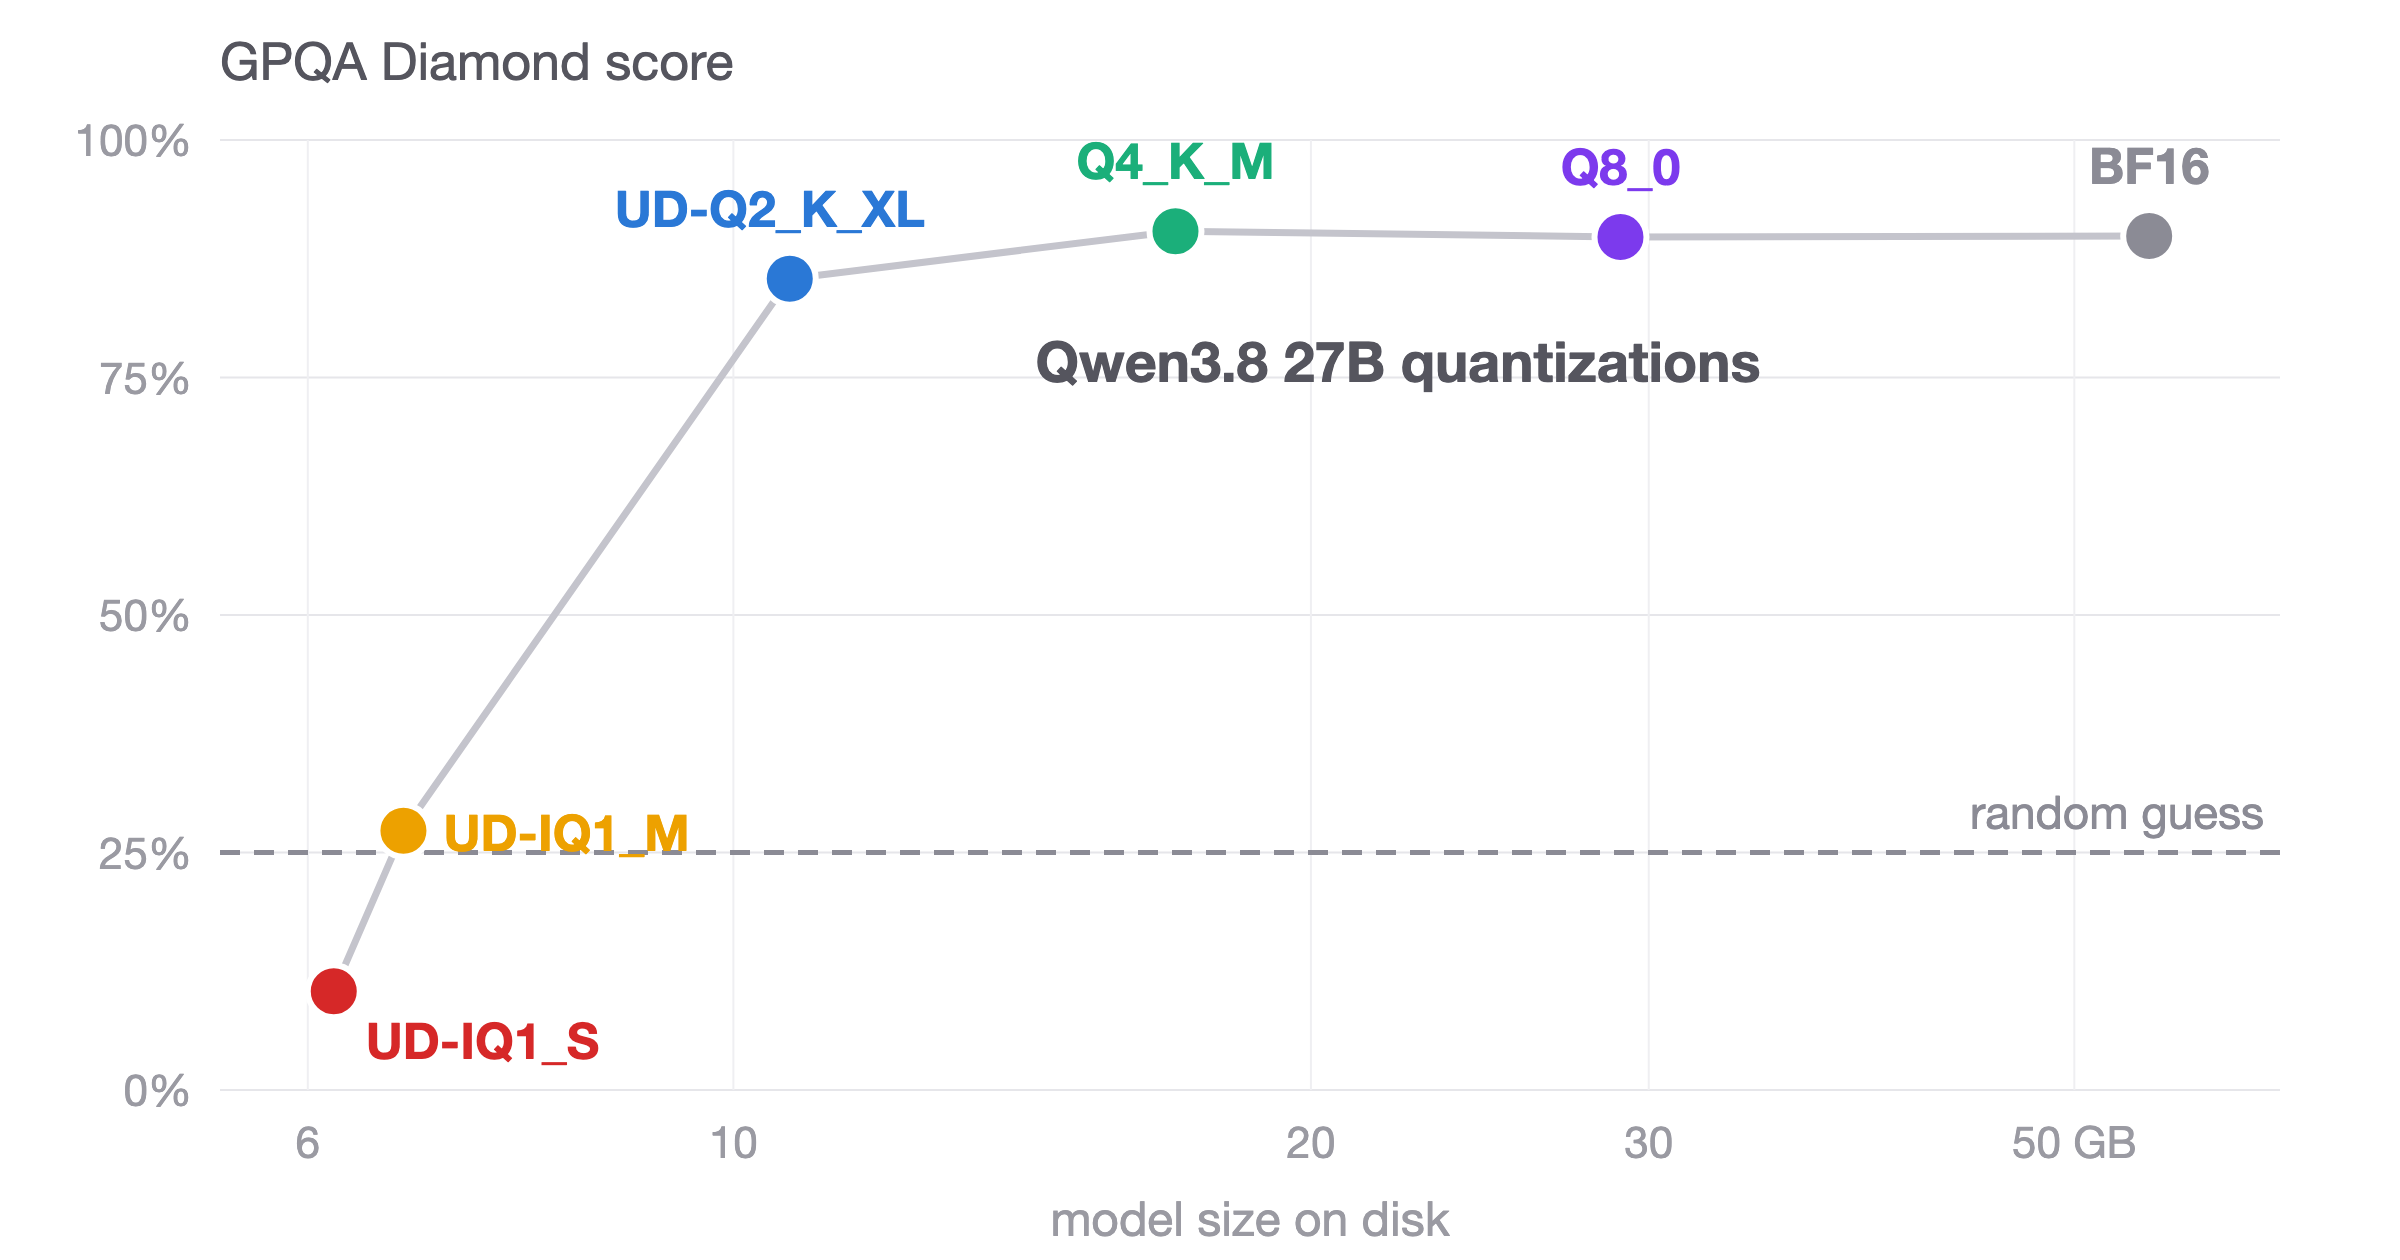
El artículo comienza presentando a Qwen3.8 27B como un modelo de 27 mil millones de parámetros cuya variante completa BF16 requiere aproximadamente 55 GB, superando la memoria de la mayoría de las GPU de consumo. Esta tarjeta de título resume el hallazgo principal de que la cuantización de 4 bits preserva la calidad mientras que la de 1 bit colapsa hasta un rendimiento de azar.
Para ejecutar el modelo en hardware de consumo, la publicación del blog evaluó varios niveles de cuantización GGUF. Las cuantizaciones probadas fueron Q8_0 a 29 GB, Q4_K_M a 17 GB, UD-Q2_K_XL a 10.7 GB y la mínima UD-IQ1_S a 6.2 GB. La cuantización reduce el tamaño del modelo al disminuir la precisión de los pesos, pero también afecta la calidad de la salida del modelo en las pruebas estándar.
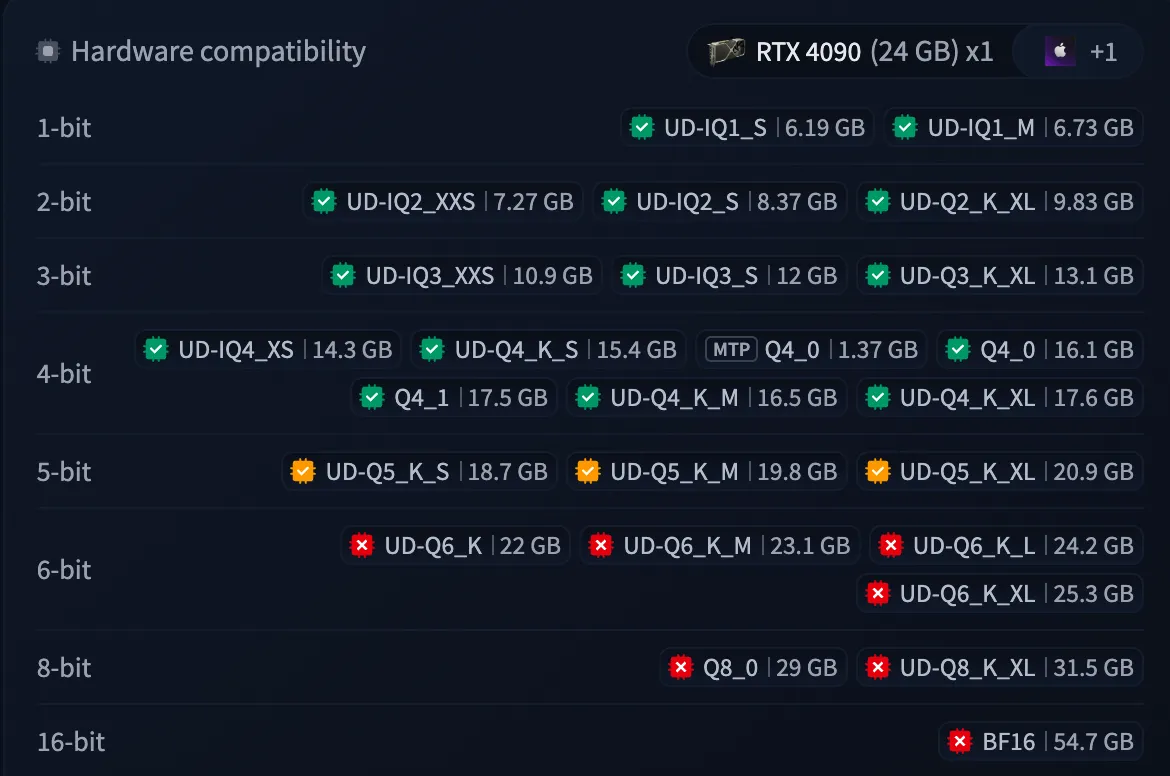
El segundo párrafo detalla los niveles de cuantización específicos probados: Q8_0 a 29 GB, Q4_K_M a 17 GB, UD-Q2_K_XL a 10.7 GB y UD-IQ1_S a 6.2 GB. Esta captura de pantalla del repositorio de Hugging Face muestra las variantes de cuantización exactas que Unsloth publicó, coincidiendo con las evaluadas en el artículo.
En la prueba GPQA Diamond (preguntas científicas de nivel de posgrado), los resultados demostraron un declive no lineal. El modelo completo BF16 y la variante de 4 bits Q4_K_M produjeron resultados comparables, con la versión de 4 bits igualando al modelo completo. A 2 bits, las puntuaciones bajaron ligeramente. A 1 bit, el modelo funcionó cerca del azar, con puntuaciones próximas al umbral de adivinación aleatoria. Los esfuerzos de razonamiento más largos empeoraron los resultados de 1 bit, ya que el modelo razonaba con más frecuencia hasta que se agotaba su presupuesto de tokens y devolvía una respuesta vacía.
En las tareas de seguimiento de instrucciones (IFBench), la publicación informa que no hubo cambios medibles entre los niveles de cuantización hasta una variante decente de 2 bits (menos de 11 GB). El contexto se limitó a unos 4k tokens en estas pruebas.
Para la prueba de codificación de agentes Terminal-Bench 2.1 (89 tareas, tiempo de espera de 3h, esfuerzo xhigh), la variante de 4 bits Q4_K_M replicó el resultado BF16 declarado. Solo la versión de 2 bits UD-Q2_K_XL mostró un descenso notable en el rendimiento, aunque todavía operaba al nivel de Opus 4.7 o Gemini 3.1 Pro. En las tareas resueltas, el modelo de 2 bits tomó aproximadamente el mismo número de turnos que el BF16 pero escribió cerca de una cuarta parte más de tokens.
Las pruebas utilizaron un KV-cache fijo F16 independientemente de la cuantización del modelo, con un peso de aproximadamente 2.3 GB por cada 32k tokens de contexto. Las ejecuciones se realizaron en GPUs de Modal: NVIDIA L40S (48 GB, el mismo chip Ada Lovelace que la RTX 4090 pero con el doble de memoria), H100 (80 GB) y H200 (141 GB). El autor gastó aproximadamente $3,000 en tiempo de GPU ejecutando estas pruebas. Se requirió una compilación anterior de llama.cpp del 16 de agosto de 2026; las compilaciones anteriores no funcionan para este modelo.
Unsloth proporcionó las cuantizaciones: v2 para los modelos de 2, 4 y 8 bits, y v3 para los modelos de 1 bit. Unsloth reemplazó los archivos v2 el 19 de agosto de 2026, por lo que los archivos exactos utilizados para la mayoría de las pruebas ya no están disponibles.
El autor concluye que para la mayoría de las tareas la versión de 4 bits Q4_K_M debería ser suficiente sin ninguna diferencia notable; para algunas tareas más simples, UD-Q2_K_XL debería ser más que suficiente. Dado que las personas informan que los KV-caches son más susceptibles a la cuantización, el autor podría probarlo también. Pero en general, el autor cree que la cuantización debe ser adoptada, en lugar de temerle.