El enfoque de Laurentiu Raducu para aprender temas complejos parte de una frustración conocida: los modelos de lenguaje suelen producir explicaciones que parecen claras, pero siguen siendo demasiado abstractas para someterlas a prueba. En lugar de pedirle a un LLM otro resumen, propone un flujo de trabajo de cuatro pasos: pedir a un asistente de programación que establezca los fundamentos del tema; solicitar a un modelo que revise la precisión de esa base de conocimientos; convertir el tema en una simulación pequeña de polígonos simples; y publicar el resultado para que pueda inspeccionarse y revisarse. El método se presenta mediante ChipTycoon, una explicación interactiva de la fabricación de chips que sigue el material desde la extracción de arena, pasando por la fabricación, hasta su entrega en un centro de datos.
La idea central no es simplemente que la animación resulte más entretenida que el texto. Una simulación obliga a quien aprende a representar estados, transiciones, entradas y salidas. ChipTycoon desplaza un carro por las etapas de fabricación y cambia lo que transporta a medida que avanza el proceso. Ese diseño puede revelar pasos faltantes o relaciones poco claras que una lista de viñetas podría ocultar. También ofrece al estudiante algo concreto que examinar: si una etapa no puede representarse, quizá sea necesario revisar la explicación subyacente. Esta es la ventaja práctica que identifica Raducu, aunque el artículo no aporta pruebas experimentales de que produzca una mejor retención que la lectura o el estudio convencional.
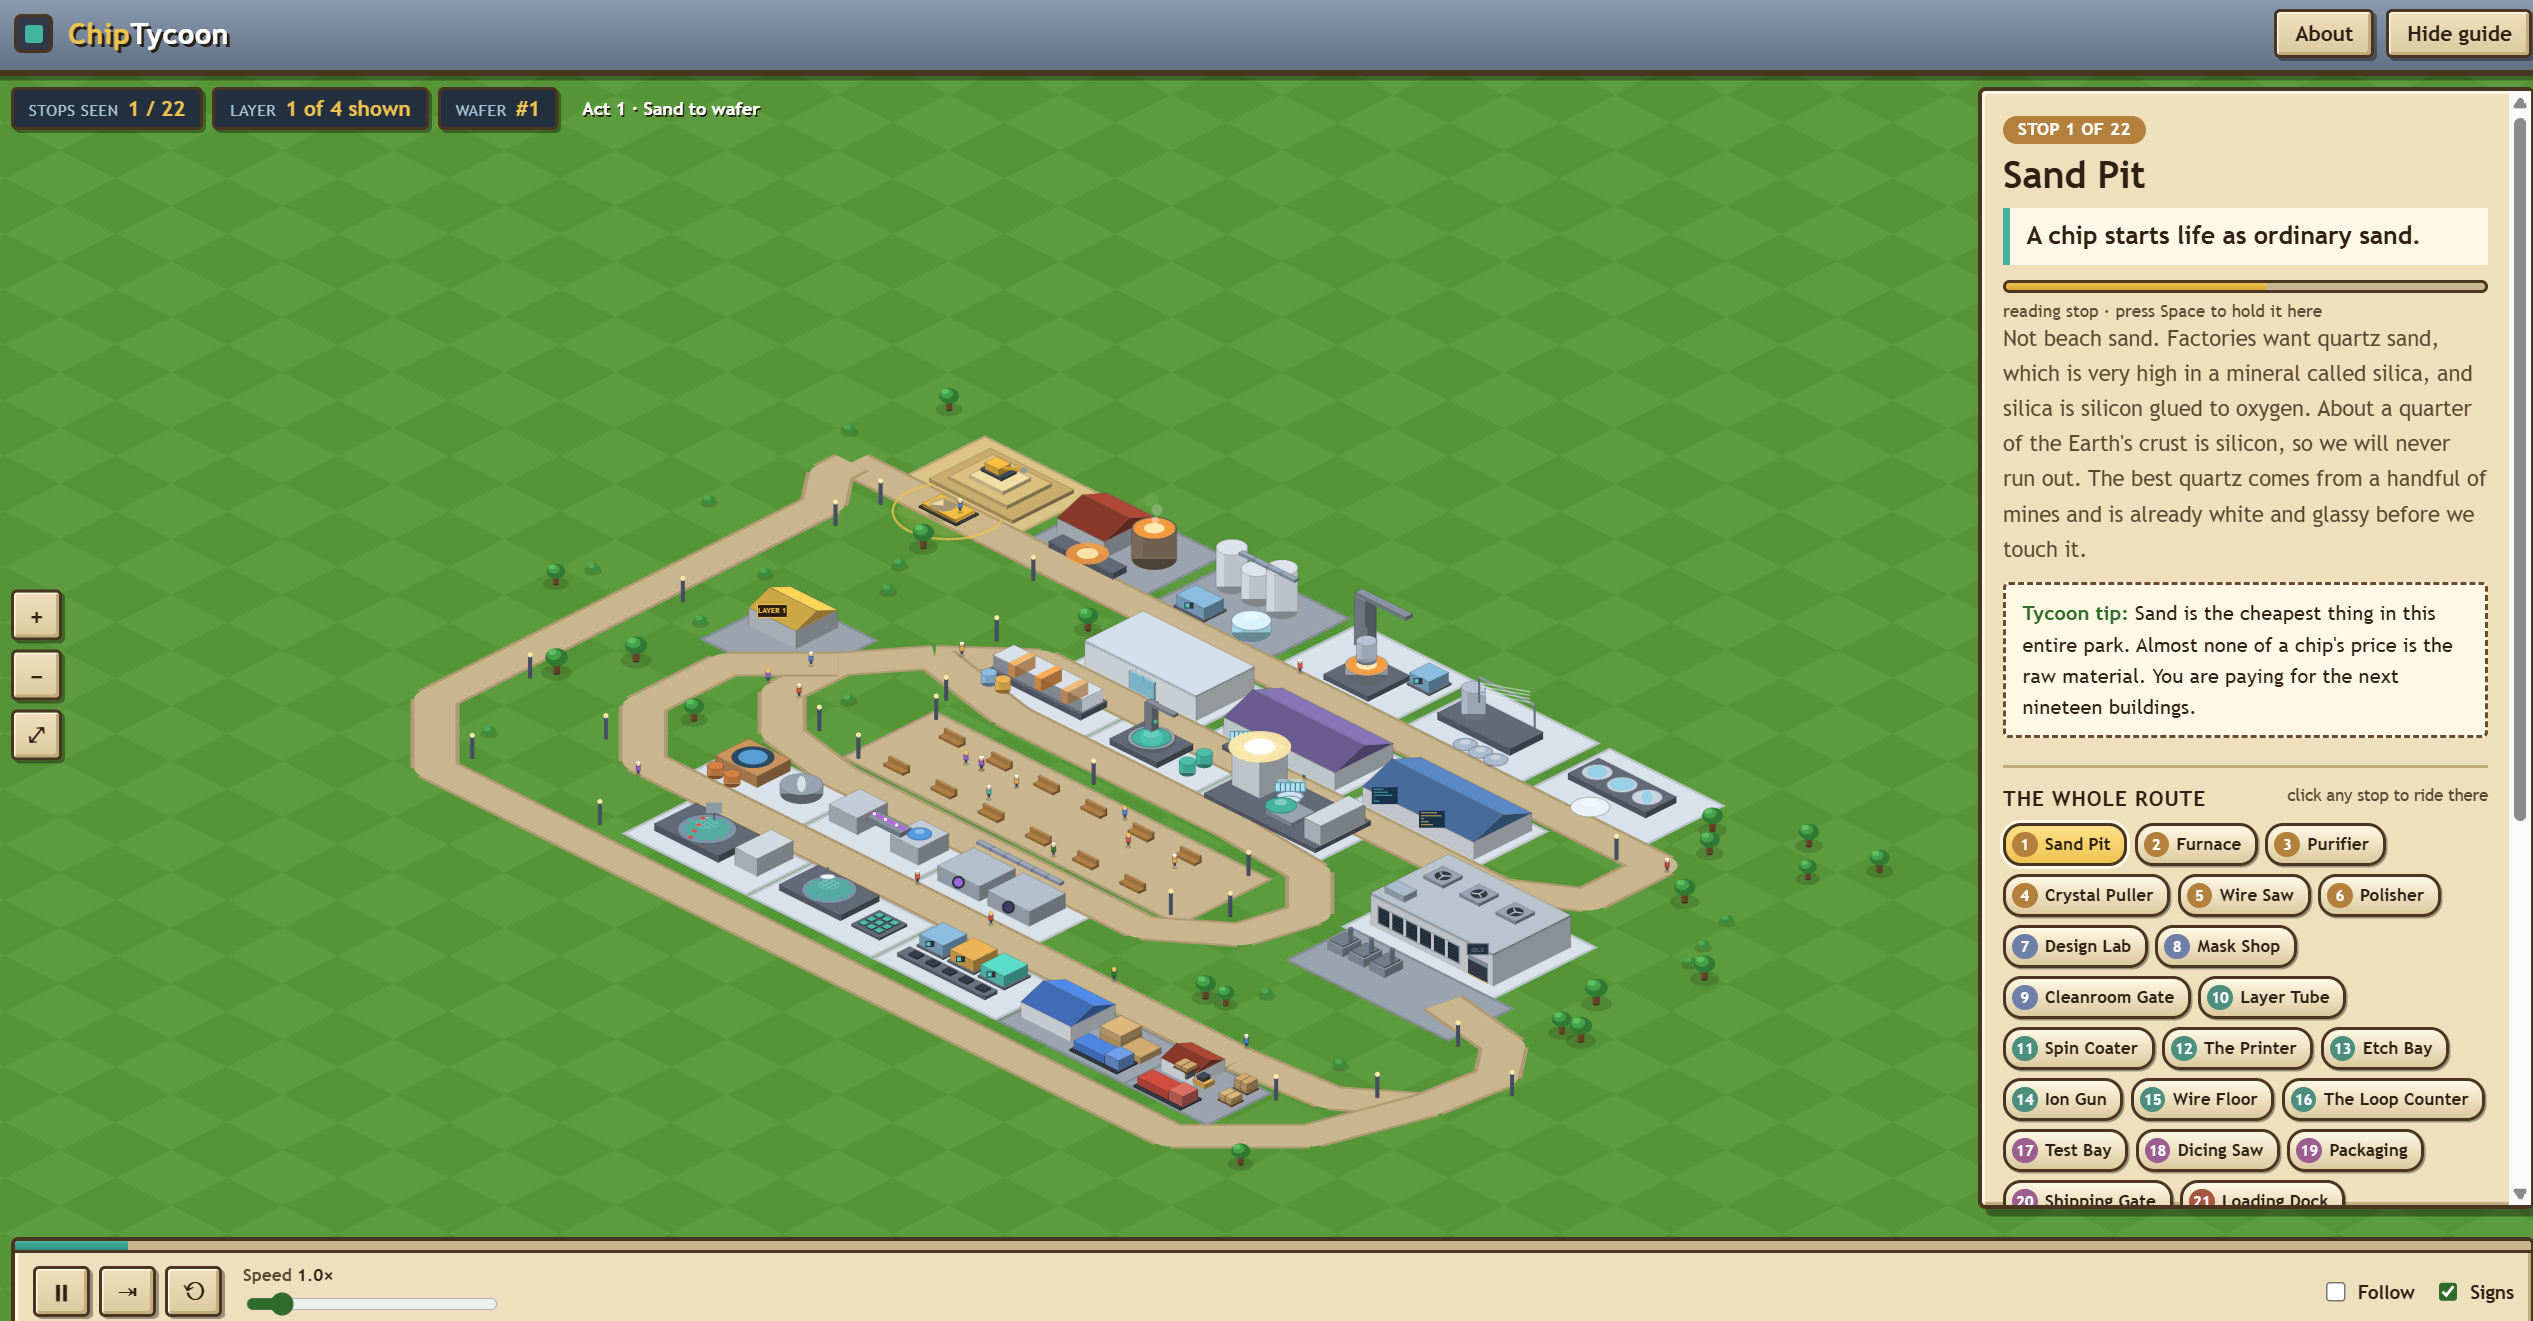
Esta imagen de la fuente respalda directamente la explicación del artículo sobre cómo el cambio de contenido del carro hace visibles y comprobables las etapas de fabricación. Crédito: laurentiugabriel.github.io.
El segundo paso del flujo de trabajo es especialmente importante. Raducu pide al modelo que revise la base de conocimientos que creó antes de construir la capa visual. En principio, ello separa la verificación de los hechos de su presentación y facilita localizar los errores. Sin embargo, no hace que el resultado sea “100 % preciso”, como lo describe el artículo. Un modelo que revisa su propio producto puede repetir el mismo supuesto erróneo, omitir una fuente pertinente o considerar aceptable una simplificación excesiva. Por lo tanto, la precisión depende de la calidad de las referencias subyacentes y de si una persona contrasta las afirmaciones de la simulación con material independiente.
El repositorio de GitHub `learnscape` ofrece una versión más disciplinada del mismo concepto. Su README describe explicadores isométricos en los que un vehículo transporta un estado real y cada parada realiza un paso auténtico de una simulación. El repositorio también propone un “registro de fidelidad” que clasifica las cifras como calculadas, escaladas, supuestas o falsificadas deliberadamente. Esa distinción es importante porque una imagen visual pulida puede sugerir una precisión de la que el modelo no dispone. Quien aprende puede ver no solo lo que afirma el explicador, sino qué partes se midieron, se aproximaron o se inventaron para mayor claridad.
`learnscape` también documenta comprobaciones de ingeniería concretas: la validación de la sintaxis de JavaScript y una prueba de humo en Chromium sin interfaz que cubre las ocho estaciones y una ejecución completa de tres solicitudes. Esas comprobaciones establecen que el ejemplo PacketPost suministrado se comporta como se describe; no validan la eficacia educativa de todos los temas desarrollados con esta técnica. La cobertura verificada del repositorio también es más limitada que una garantía universal: indica que se probaron los métodos de instalación basados en copiar y pegar, mientras que la instalación integral del complemento no se probó. Es un recordatorio útil de que hay que distinguir una demostración funcional de una afirmación sobre todos los usos futuros.
El repositorio independiente de GitHub de Raducu, `unreal-game-assets-creation-skill`, muestra otra forma de enriquecer una simulación convirtiendo una indicación o una fotografía en un recurso 3D texturizado. Su README describe un flujo de trabajo que utiliza Fooocus, Hunyuan3D-2, Blender y, de forma opcional, Unreal Engine. También señala una limitación práctica: en una estación de trabajo con Windows equipada con una GPU RTX 4070 de portátil y 8 GB de VRAM, ejecutar juntos los servicios de generación de imágenes y de modelos 3D provocó presión sobre la memoria y una generación mucho más lenta, por lo que la habilidad detiene un servicio antes de iniciar el siguiente. Esto es evidencia sobre la configuración documentada de ese repositorio, no una evaluación comparativa general de todo el hardware o de todas las herramientas de generación con IA.
Para quienes estén considerando este método, la conclusión más defendible es de carácter procedimental. Utiliza un LLM para elaborar un mapa del tema, cuestiona ese mapa, implementa un modelo pequeño cuyo comportamiento pueda observarse y mantén un registro explícito de los supuestos. Añade preguntas o acertijos solo después de que el proceso subyacente esté representado con suficiente calidad para sustentarlos. La capa visual debe aclarar el modelo, no disfrazar la incertidumbre. Por lo tanto, la versión más sólida de este flujo de trabajo no es “confía en la animación”, sino “haz que la afirmación sea ejecutable y luego examina dónde la ejecución discrepa de la evidencia”.
El paquete de fuentes fecha el artículo principal el 9 de agosto de 2026, lo que coincide con la fecha de publicación suministrada para la página. Las afirmaciones del artículo sobre su utilidad personal y su precisión siguen siendo el relato del autor. Los repositorios suministrados corroboran la existencia de herramientas y documentación relacionadas, y aportan detalles sobre la estructura de las simulaciones, las etiquetas de fidelidad, las pruebas y las limitaciones locales de la GPU. No establecen resultados de aprendizaje comparativos, no demuestran que ChipTycoon esté libre de alucinaciones ni muestran que todos los explicadores generados por LLM sean fiables. Para el lector, el método resulta prometedor como forma de organizar la investigación, pero su valor educativo todavía debe ponerse a prueba en relación con los objetivos del estudiante, sus fuentes y su capacidad para detectar errores.