UTF-8 es una codificación de caracteres ampliamente utilizada que representa caracteres Unicode utilizando entre uno y cuatro bytes. Aunque el diseño original de UTF-8 admitía secuencias de hasta seis bytes, se restringió a cuatro bytes en 2003 para alinearse con las limitaciones de UTF-16. UTF-8000 es una propuesta experimental que busca eliminar este límite, permitiendo unidades de código de longitud arbitraria para acomodar un número ilimitado de puntos de código. El mecanismo central de UTF-8000 implica dividir los bits más significativos del primer byte en bits de autosincronización y bits de inicio. Cuando una unidad de código excede la capacidad de un solo byte, los bits de inicio se distribuyen a través de los bytes de continuación subsiguientes. Este enfoque mantiene la propiedad libre de prefijos del estándar UTF-8, asegurando que la longitud de una unidad de código pueda determinarse leyendo los bits de inicio, los cuales indican la longitud de la secuencia. Mediante este método, UTF-8000 evita la necesidad de puntuación auxiliar entre unidades de código, preservando las características de autosincronización y autopuntuación del estándar original. La especificación mantiene las reglas existentes para la compatibilidad con ASCII y prohíbe las codificaciones excesivamente largas —donde un carácter se representa utilizando más bytes de los necesarios— para prevenir vulnerabilidades de seguridad como aquellas que podrían surgir si los bytes nulos fueran manejados incorrectamente por funciones de C como strcpy. A pesar de su diseño técnico, la propuesta enfrenta desafíos prácticos. Implementar soporte para unidades de código arbitrariamente grandes introduce riesgos potenciales, tales como vulnerabilidades de desbordamiento de búfer, si el software no impone límites estrictos al tamaño de la entrada. Además, debido a que el estándar requiere leer los bits de inicio para determinar la longitud, las secuencias extremadamente largas podrían complicar el análisis y la gestión de la memoria en comparación con los límites de longitud fija de los estándares actuales.
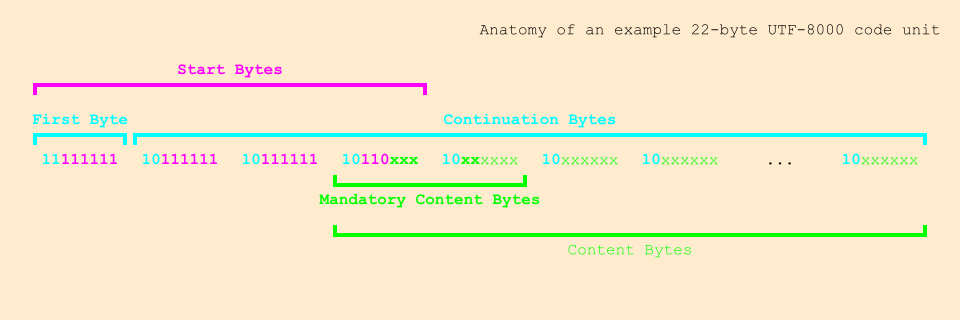
El artículo describe cómo UTF-8000 divide los bits entre bytes para mantener las propiedades libres de prefijos, lo cual se aclara visualmente mediante este diagrama anatómico.
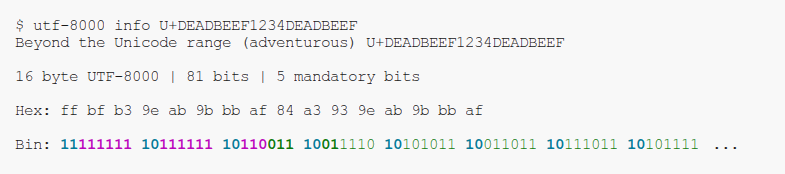
Este gráfico informativo proporciona un ejemplo concreto del mecanismo de codificación discutido en la propuesta, ayudando a visualizar el rango teórico ilimitado.