Gzip no puede generar prosa en el sentido habitual. Un pequeño experimento de Nathan Barry, publicado en nathan.rs, demuestra que un algoritmo de compresión estándar puede utilizarse, aun así, para elegir texto que se asemeja a un corpus proporcionado. La distinción es importante: el proyecto no dota a gzip de pesos aprendidos, una red neuronal ni la amplia capacidad de generalización asociada a los modelos de lenguaje contemporáneos. Pone de manifiesto una equivalencia entre la predicción y la compresión sin pérdidas y, a partir de ella, construye un generador condicional.
El experimento, denominado GziPT, utiliza zlib de Python en lugar de iniciar un proceso gzip independiente. Barry señala que ambos se basan en DEFLATE. DEFLATE busca secuencias repetidas de bytes dentro de una ventana reciente de 32 KiB y representa una coincidencia mediante una retroreferencia cuando hacerlo resulta más barato que emitir bytes literales. Por tanto, una continuación que repite o reproduce de forma muy cercana material que el compresor ya puede ver puede recibir una codificación más corta. Esa longitud comprimida se convierte en una puntuación: se considera que una candidata que produce un archivo codificado más pequeño es más predecible a partir del contexto actual.
Esta regla de puntuación se ajusta a una relación estándar de la teoría de la información. Si un modelo asigna a un símbolo una probabilidad p, un código óptimo emplea aproximadamente −log₂(p) bits para representarlo. Los símbolos probables cuestan menos bits; los inesperados cuestan más. El artículo de arXiv «Language Modeling Is Compression», presentado por primera vez el 19 de septiembre de 2023 y revisado el 18 de marzo de 2024, describe cómo los modelos predictivos y los compresores sin pérdidas pueden transformarse unos en otros. Su resumen también afirma que la equivalencia puede utilizarse para construir un modelo generativo condicional a partir de cualquier compresor, incluido gzip. Esa es la posibilidad teórica que Barry pone a prueba.
Puntuar no equivale a generar. Seleccionar únicamente el siguiente byte con la longitud comprimida inmediata más baja ofrece malos resultados, porque gzip informa longitudes en bytes completos, lo que provoca numerosos empates y oculta la señal. GziPT emplea, en cambio, una búsqueda en haces sobre secuencias de bytes. Extiende las candidatas supervivientes con bytes encontrados en el corpus, comprime cada tramo propuesto, conserva las continuaciones parciales con mayor compresibilidad hasta alcanzar beam_width y repite el proceso durante un horizonte determinado de bytes. Después adopta el mejor tramo o selecciona una muestra entre las finalistas cuando se establece una temperatura positiva, antes de comenzar de nuevo.
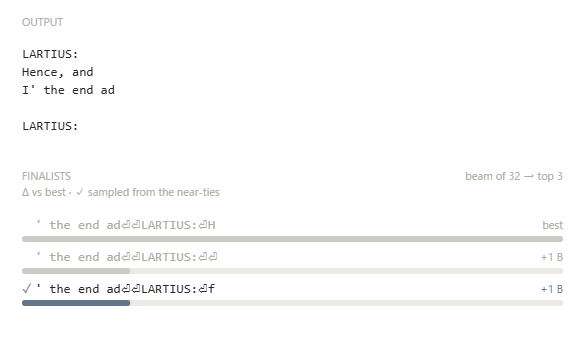
La reproducción muestra cómo GziPT puntúa varias continuaciones según su longitud comprimida y elige entre las finalistas. La página de origen no indica las condiciones de uso de la imagen.
El diseño del contexto resulta especialmente revelador. Barry afirma que el contexto de puntuación combina la ventana del corpus con solo la parte final reciente del texto proporcionado y del generado. Mantener disponible todo el historial abarataría la repetición literal y animaría al generador a caer en bucles. Restringir la cola limita ese modo de fallo, pero también limita la coherencia: el generador no puede mantener durante mucho tiempo un razonamiento, una trama o un conjunto de restricciones. Su aparente conocimiento es, por tanto, local y mecánico; no demuestra que DEFLATE haya adquirido una representación independiente del lenguaje.
El artículo proporcionado incluye una continuación sin editar de 200 bytes, generada tras utilizar Pequeño Shakespeare como texto base y la indicación «MENENIUS:». El resultado contiene nombres reconocibles y fragmentos teatrales, pero no constituye un diálogo coherente. Barry lo caracteriza como un texto que parece saber algo sobre la obra, aunque no resulta exactamente coherente. Esta valoración concuerda con la muestra, pero sigue siendo una evaluación cualitativa del autor, no el resultado de una prueba de referencia. El material proporcionado no incluye perplexidad, valoraciones humanas, comparaciones con referencias más sólidas ni un estudio controlado de la calidad de los resultados.
El propio resumen del artículo afirma que un intento anterior basado en este enfoque obtuvo malos resultados, mientras que Barry sostiene que la búsqueda en haces mejoró sustancialmente la calidad de la generación. Estas afirmaciones no deben condensarse en la idea de que gzip compite ahora con los modelos neuronales de lenguaje. El artículo evalúa grandes modelos fundacionales principalmente como compresores y presenta resultados de compresión independientes para Chinchilla 70B; esos datos no validan el resultado shakespeariano de GziPT ni establecen una clasificación entre generadores de texto de propósito general.
La lección práctica es conceptual. La compresión ofrece una forma cuantitativa y observable de preguntar si una continuación encaja con patrones ya presentes en un contexto, y la misma maquinaria puede respaldar la generación condicional. La limitación es igualmente importante: un compresor recompensa la compresibilidad, no la veracidad, la utilidad, la originalidad ni la comprensión semántica. GziPT demuestra un puente ingenioso entre la teoría de la información y la generación, pero la evidencia permite llamarlo un experimento evaluado mediante compresión, no un modelo de lenguaje general.