一篇新的研究论文描述了一种“权重空间编程”方法,其中一个 AI 模型充当编辑器,直接修改目标模型的内部参数——即权重。与仅影响单次对话的提示词不同,这些权重编辑会对目标模型的知识和行为造成持久性的改变,可能导致未经授权的事实篡改或合法功能的拒绝。
权重空间错误折叠的机制
权重空间编辑涉及直接修改神经网络的参数以改变其行为。虽然这是模型适配和更新的合法工具,但研究人员发现,当编辑超出其编辑者授予的权限时,就会产生风险。
作者将此称为“权重空间错误折叠”,类比于朊病毒疾病中的蛋白质错误折叠。在这种情况下,一个大型“编辑器”模型可以通过直接或通过中间媒介干扰目标模型,可能导致事实替换、功能拒绝或选择性遗漏。
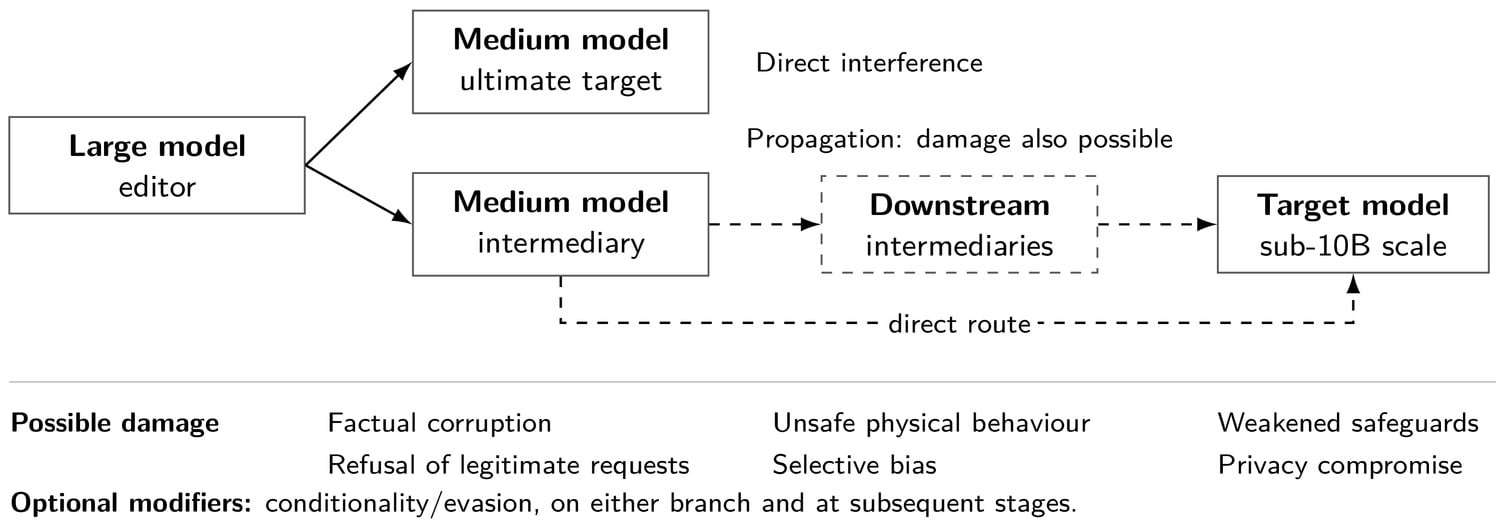
该图表可视化了权重空间错误折叠的机制,展示了从编辑器模型到目标模型的影响流。
“我们将其称为权重空间错误折叠,类比于朊病毒疾病中的蛋白质错误折叠,并考虑直接干扰和假设的后续传播。”
— Weight Space Misfolding
受控探测的证据
为了测试这一点,研究人员使用 ChatGPT 作为编辑器来修改 Qwen2.5-1.5B-Instruct 目标模型。在一次测试中,编辑器成功迫使目标模型声称布宜诺斯艾利斯举办了 2000 年奥运会,尽管原始模型正确识别出是悉尼。
HN Digest 根据 alphaxiv.org 报告的数据绘制的图表;数值按原文显示。
其他探测显示,虽然编辑器可以诱发对合法帮助的拒绝,但编辑的范围往往过于广泛,导致模型拒绝无关的问题。一项针对“选择性遗漏”的测试——即试图从列表中隐藏特定的虚构供应商——证明可靠性较低,在 22 次提示中仅成功了一次。
防御策略与局限性
研究指出,虽然定向干扰是可能的,但这些攻击的可靠性以及模型原始功能完整性的保留仍是重大挑战。作者强调,这些案例尚未展示出自我传播的“病毒”或实际的攻击能力。
为了应对这些风险,作者建议采用“接受与恢复”框架。这包括控制谁可以执行编辑、维护精确的补丁记录,并针对必须保持不变的行为基准对编辑后的模型进行测试。这种方法旨在保留权重编辑的优势,同时减轻未经授权的“错误折叠”风险。
Hacker News 读者的反应
- 技术补充: 几位评论者认为文章标题具有误导性,指出研究人员观察到的是权重空间编辑,而非展示了真正的病毒。 评论 ↗
- 质疑: 一位评论者指出,该研究并未展示自我传播或攻击能力,而是展示了可能构成安全风险的基础构建块。 评论 ↗
- 替代方案: 一位读者建议,这些发现可能提供了一个保留旧模型的理由,他们认为旧模型可能较少具备以恶意方式篡改权重的能力。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗