对 LeWM(潜在世界模型)进行的 600 项实验揭示,JEPA 世界模型在长程任务上的成功程度更多受限于其规划架构,而非其预测物理的能力。虽然该模型在原始形式下解决 75 步任务的成功率仅为 22%,但研究人员发现,将这些任务分解为较小的 25 步片段后,在无需重新训练基础模型的情况下,成功率提升到了 80%。
JEPA 架构与预测差距
联合嵌入预测架构(JEPA)通过将视觉观测转换为称为嵌入的紧凑向量来运行。与试图预测未来帧中每个像素的生成模型不同,JEPA 使用编码器提取相关特征,使用预测器根据动作预测下一个嵌入,并使用规划器评估潜在的动作序列。
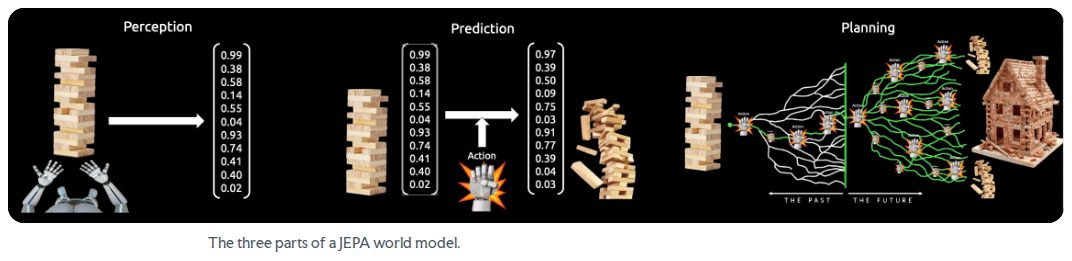
此图解释了 JEPA 模型的基本架构,该模型使用编码器、预测器和规划器。
在 Push-T 基准测试中测试 LeWM 模型时(机器人必须将 T 形块移动到目标位置),研究人员发现,在 25 步的短程范围内,模型的预测精度几乎与完美的物理规律一致。这表明长程任务的主要瓶颈不是世界模型本身的不准确,而是规划器如何处理 75 步中累积的误差。
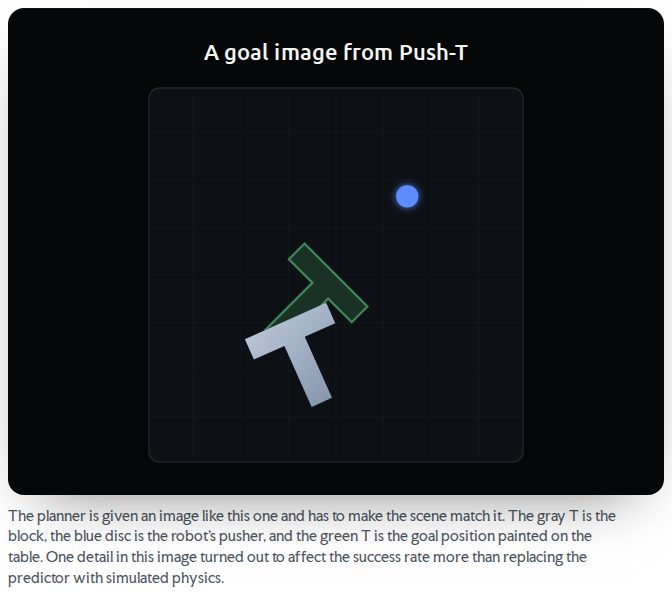
此图像展示了用于评估模型的规划和预测能力的 Push-T 基准测试。
由HN Digest根据haddyalchaer.com报告的数据绘制;数值按来源所示。
“LeWM 的有效规划范围约为 25 步,因此很明显,进一步前进的方法是将这些长度的片段串联起来。”
— After 600 experiments, here's what I discovered about JEPA world models
分层规划与记忆图
一项显著的改进涉及分层规划。通过将 75 步的目标划分为三个 25 步的片段,模型能够保持在其“准确区域”内,即它可以成功预测下一个状态。这种方法比原始模型高出 58 个百分点,几乎达到了提供完美专家子目标的规划器的性能。
另一种方法利用由过去专家演示的 460,000 个嵌入状态构建的潜在记忆图。通过将这些状态视为地图,并为不同演示之间的“跳跃”添加成本,规划器可以通过串联成功的过去行为片段来导航至目标。这种方法在长程任务上实现了 85% 的成功率。
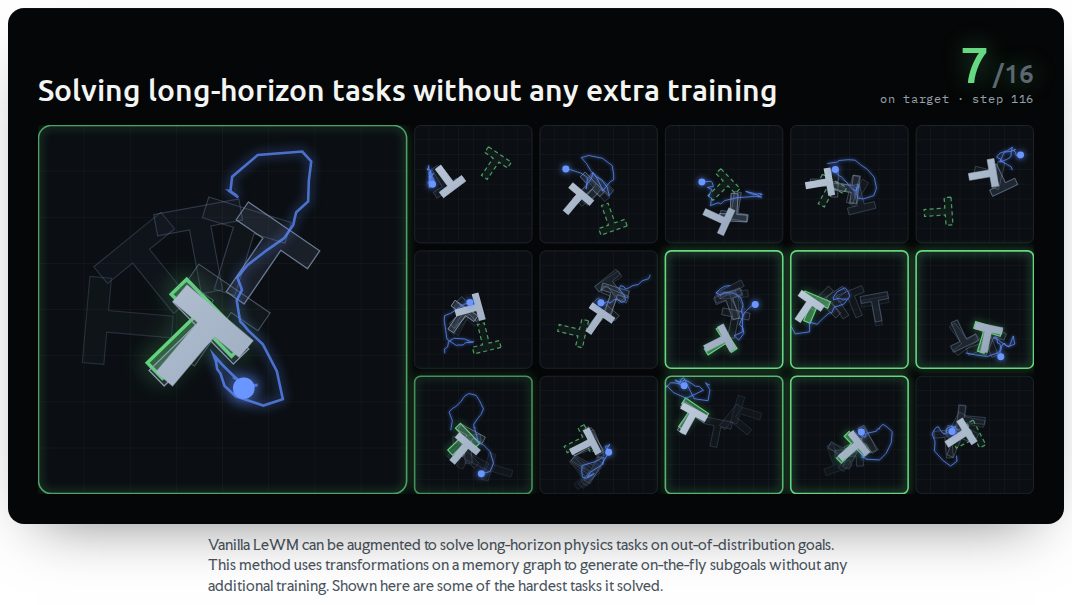
此视觉效果展示了使用潜在记忆图通过串联过去行为来导航至目标的方案。
优化目标评分与局限性
研究还强调了目标评分方式中的一个缺陷。由于目标图像包含机器人的手臂,规划器往往因为试图完美复制手臂位置而非专注于块的位置而失败。通过调整评分以忽略手臂,某些任务的成功率提高了 30 个百分点。
尽管取得了这些进展,仍面临重大挑战:泛化到缺乏完美专家演示的任务。虽然记忆图和变换(如旋转或镜像过去的数据)有助于填补空白,但当目标需要导航到从未在演示中捕捉到的状态时,模型仍然表现挣扎。