在 Qwen3-1.7B 语言模型中,单次对话并非单一的数据点,而是内部状态的序列,其中每个 token 都由 2,048 个数字组成的向量表示。通过将数千个此类状态映射到三维投影中,研究人员发现英语对话占据了一个极其扁平的几何形状,其 99.3% 的变异包含在一个单一的 3D 平面内。
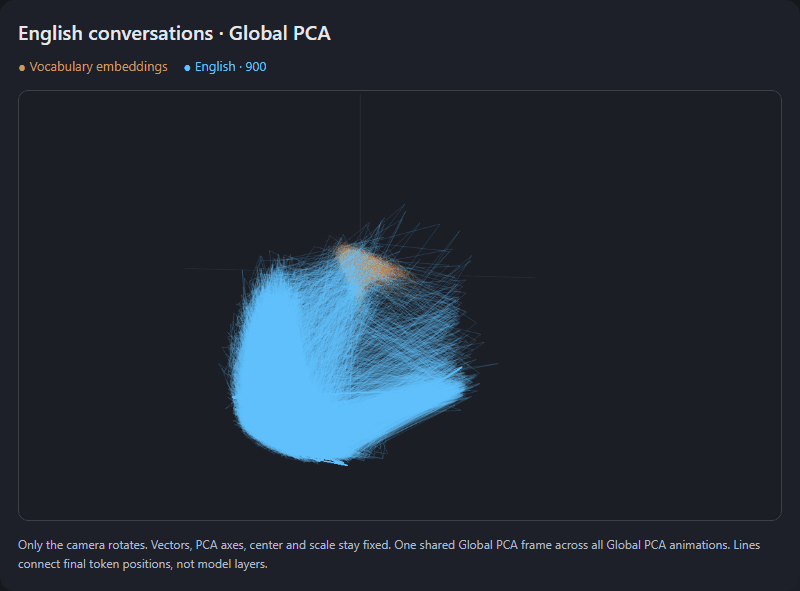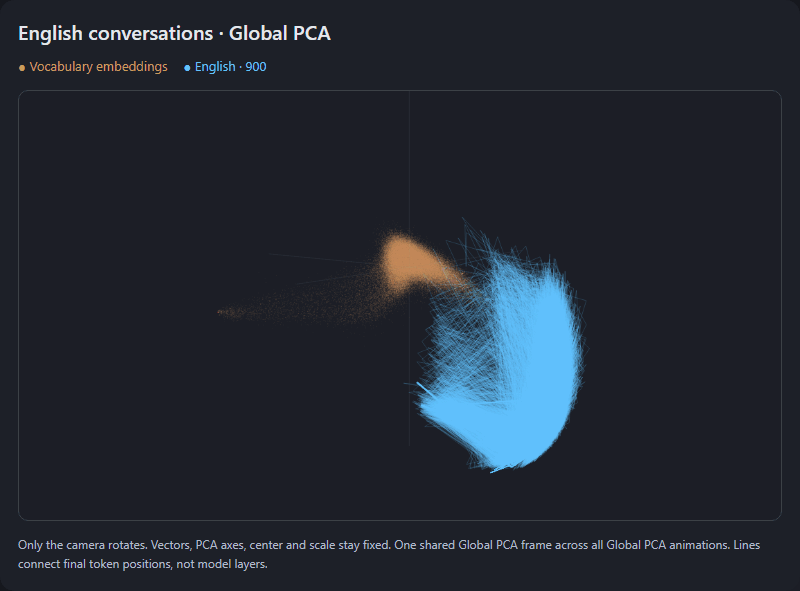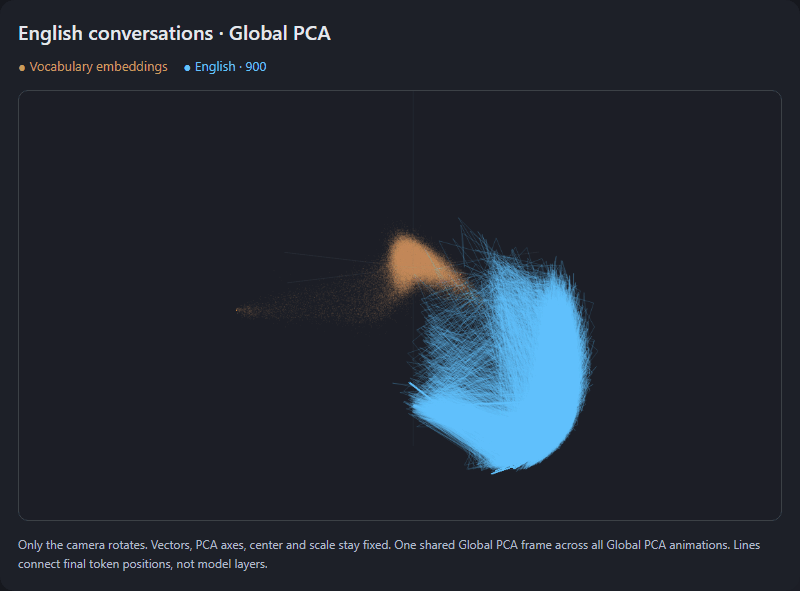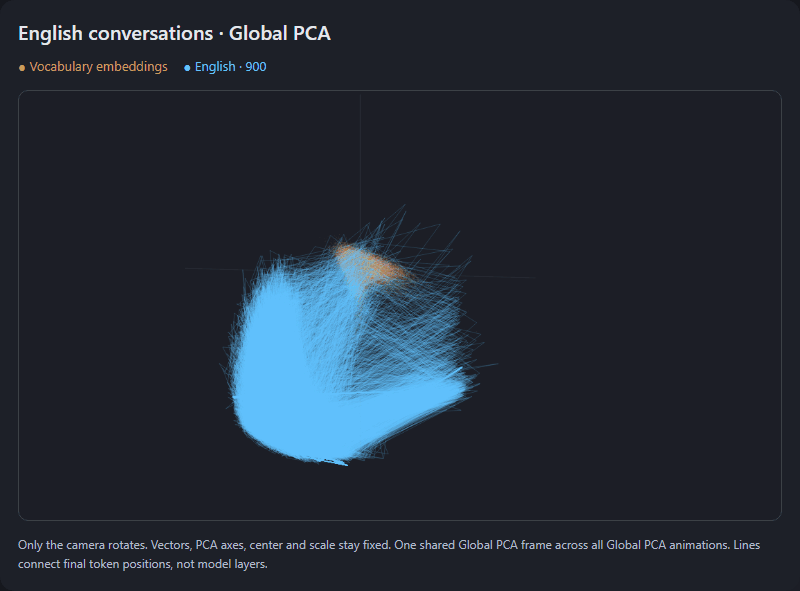
此动画说明了英语对话状态高度压缩成薄薄几何片层的发现。
作为共享工作空间的残差流
该研究聚焦于“残差流”,它是语言模型处理文本的核心共享工作空间。每个 token——无论是单词、单词的一部分还是标点符号——最初作为来自嵌入表(embedding table)的学习向量,然后由模型的各层根据周围上下文进行精炼。
通过记录这些最终的 token 状态并归一化其长度,研究人员能够可视化对话在模型内部表示中所走的“路径”。这些路径揭示了模型如何将初始嵌入转换为上下文感知的状态。
“仅凭几何结构本身无法理清这些可能性。”
— What thousands of conversations look like inside a language model
语言几何与语言分离
映射结果揭示了不同语言独特的空间行为。虽然英语状态形成了薄片,但中文状态出现在相邻区域,与英语集群明显偏移。这表明模型的内部表示同时携带有关主题内容以及用于表达该内容的具体语言形式的信息。
德语和克罗地亚语占据了一个与英语重叠的广泛邻域,表明这些拉丁字母语言具有共享的几何结构。然而,研究人员指出,这些区域的密度受到数据构建的影响;例如,克罗地亚语回复包含更多 token,导致产生更密集的点阵,这并不一定意味着模型容量更大。
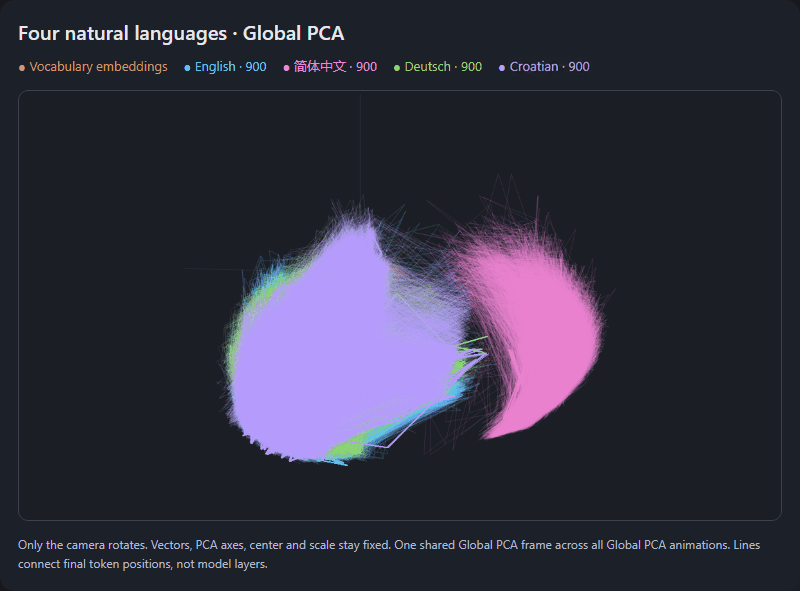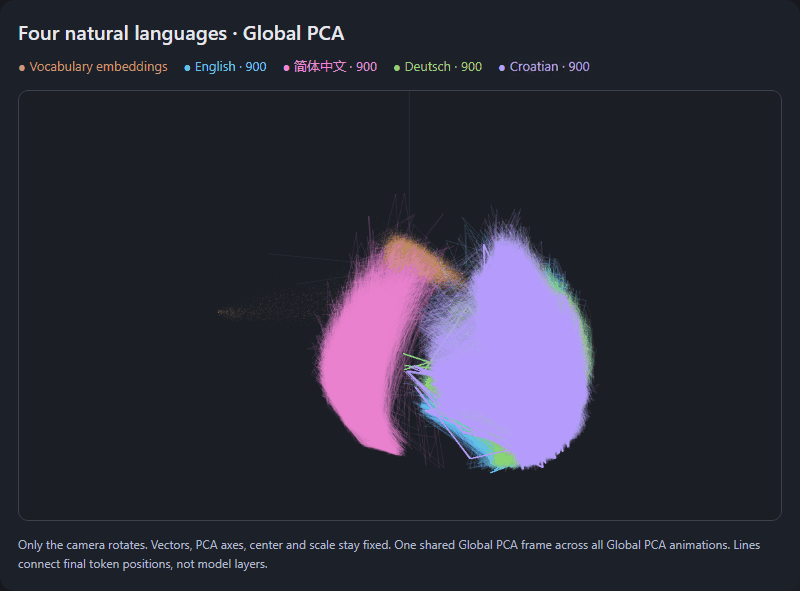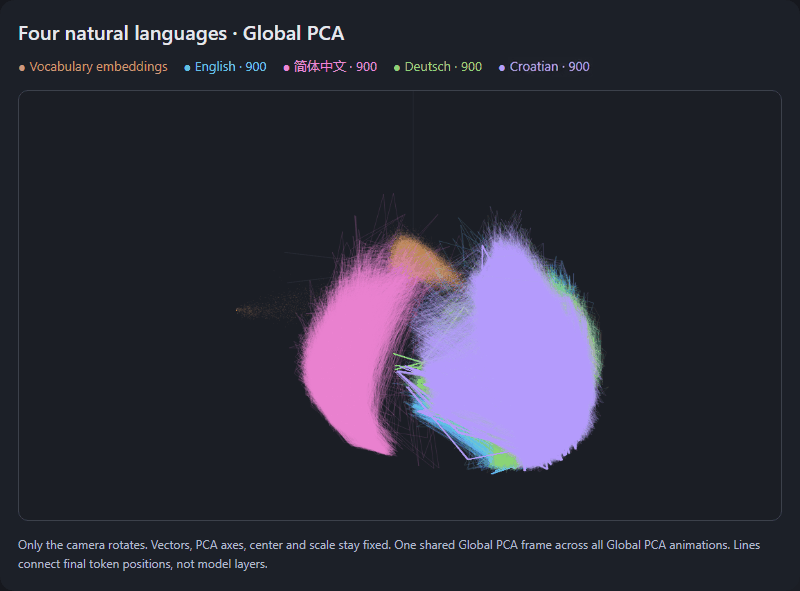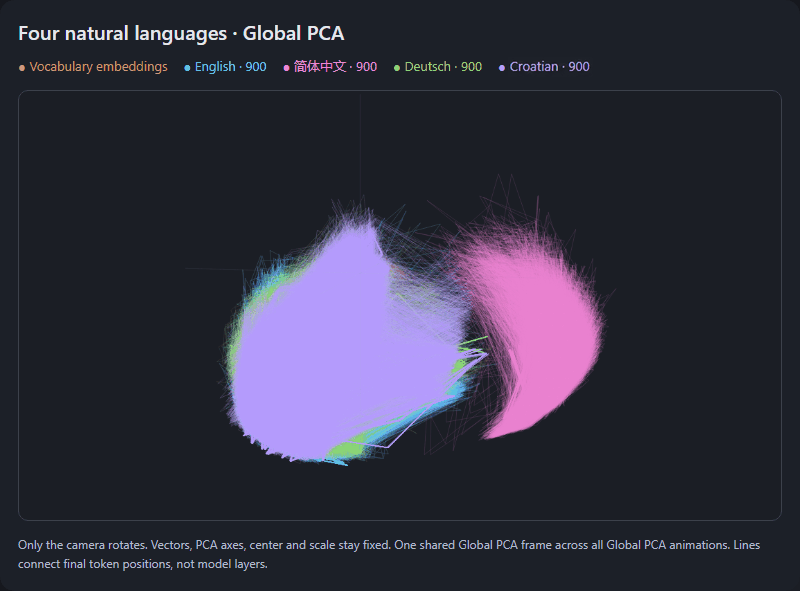
动画演示了模型残差流中不同语言之间的独特空间行为和重叠。
代码与面向词汇的框架
当引入 Python 代码示例时,它们出现在与自然语言数据集相同的广泛邻域内。有趣的是,简单的距离比较显示,尽管代码和英语共享相似的关键词和结构,但代码数据集在数值上比英语更接近德语和克罗地亚语。
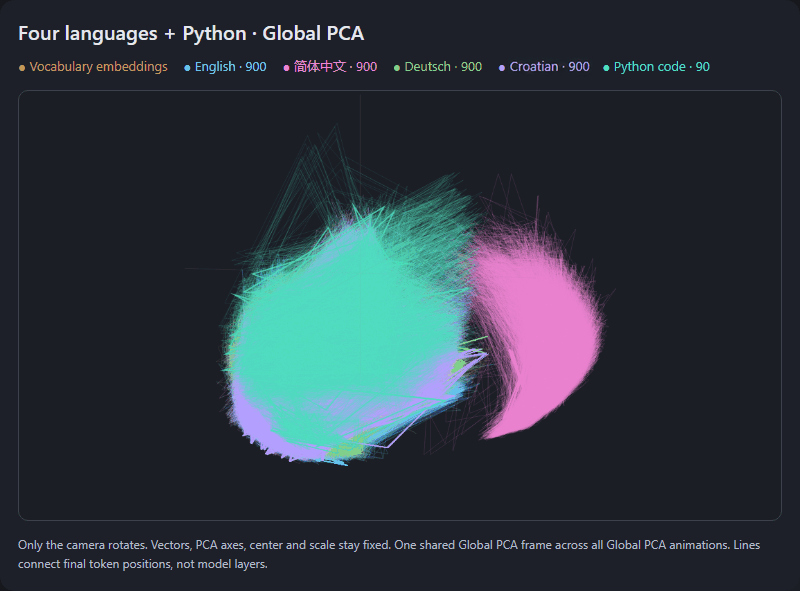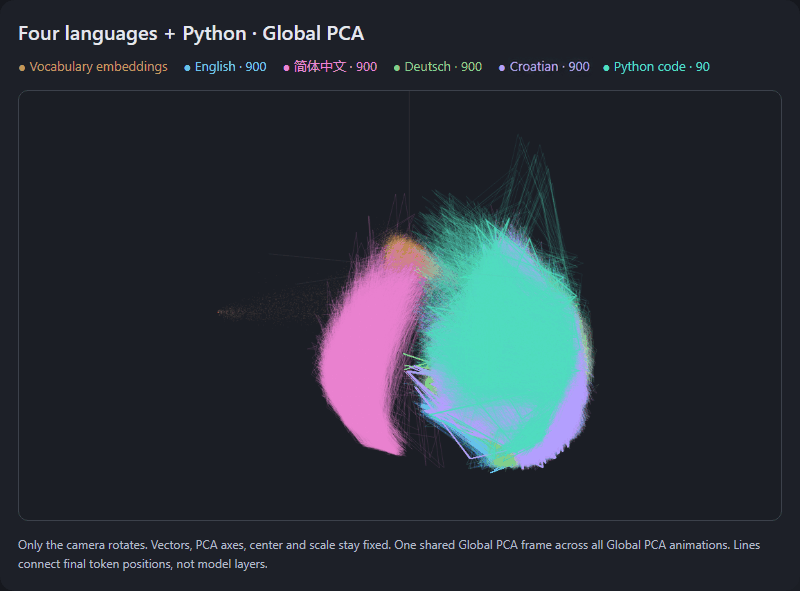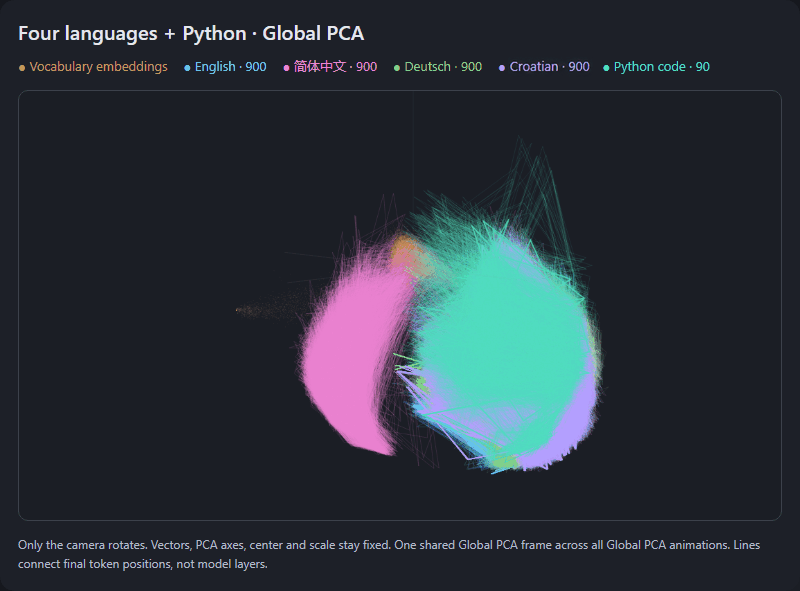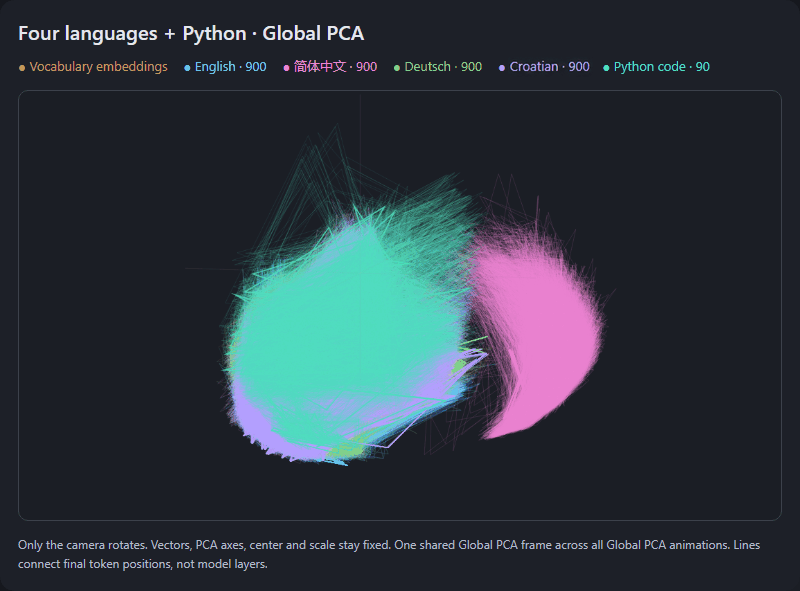
此视觉效果有助于解释 Python 代码示例如何位于与自然语言数据集相同的广泛邻域内。
研究还证明,这些内部状态的“地图”高度依赖于观察者的视角。使用“对话 PCA”(Conversation PCA)——即针对对话平均值之间的变异进行优化——比受 151,936 个词汇嵌入严重影响的“全局 PCA”(Global PCA)框架揭示出更易区分的德语和克罗地亚语区域。
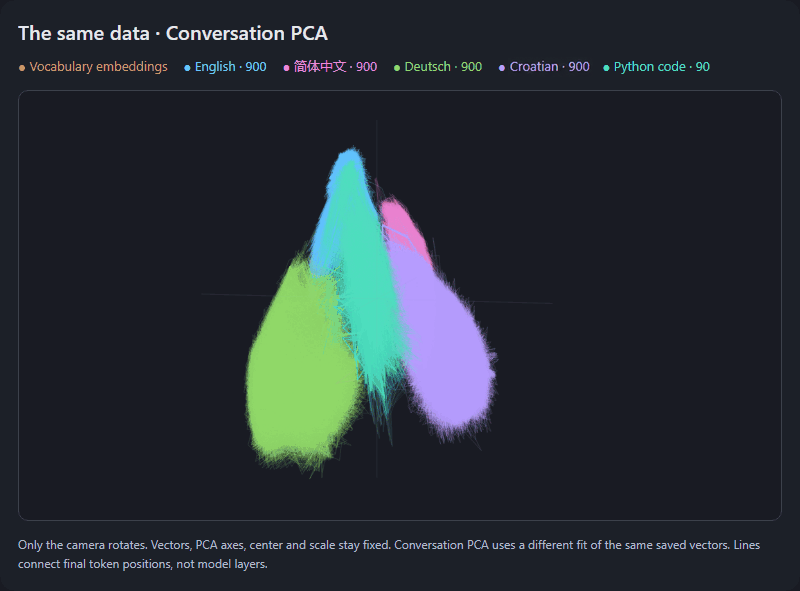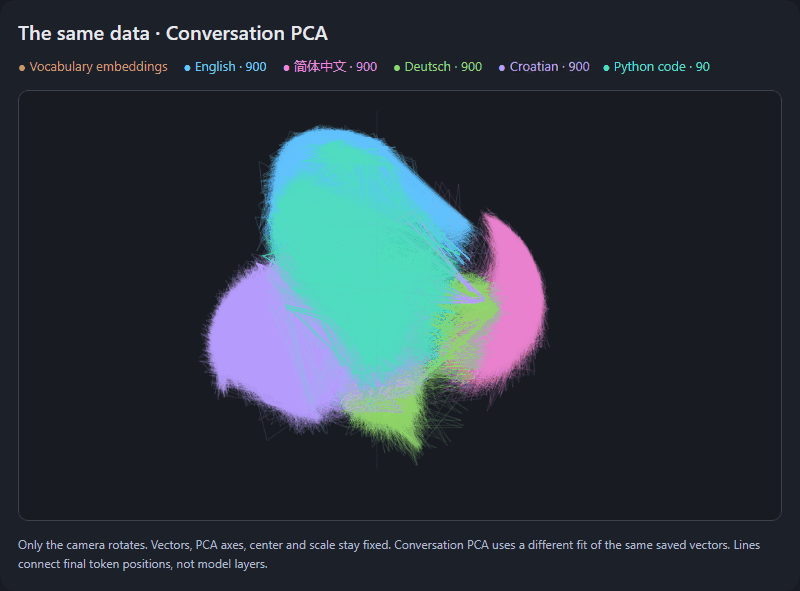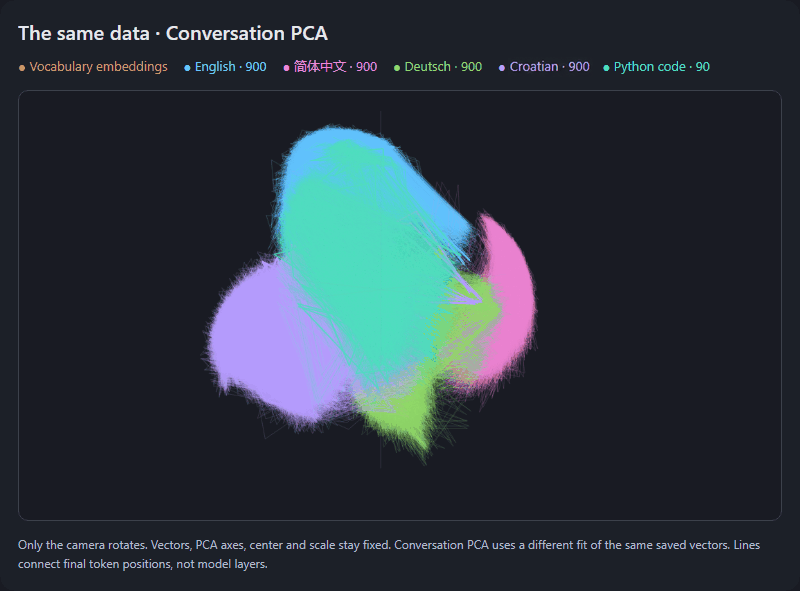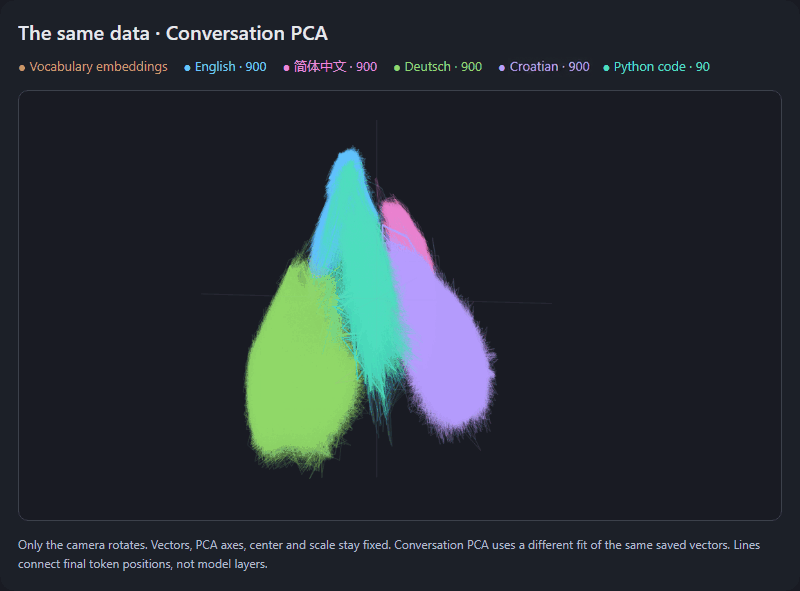
此可视化演示了当观察者视角转向 Conversation PCA 时,内部状态的“地图”如何发生变化。
HN Digest绘制的图表(基于operator0x.com报告的数字;数值按来源显示)。
3D 投影的局限性
虽然 3D 可视化提供了清晰的模型内部几何视角,但它们代表了对实际数据的显著简化。研究人员发现,3D 视图仅捕捉到了 2,048 维 token 状态中总变异的 17.6%,这意味着模型内部超过 82% 的变异在投影中是不可见的。
此外,该研究使用了包含 100 个主题和 90 个代码示例的小型、特意构建的样本。虽然这提供了一个受控环境来观察语言几何,但它可能无法完全捕捉模型在所有可能的人类知识和对话类型中所展现的巨大多样性。