对 DeepSeek、Moonshot AI、MiniMax 和 Ant Group 公开发布的 AI 模型进行的取证分析揭示了与 NVIDIA Blackwell GPU 架构相匹配的数值模式。这些发现表明,虽然美国的出口管制旨在限制中国获取高端算力,但几家领先的中国开发商已成功将这些芯片整合到他们最新的前沿模型的训练中。
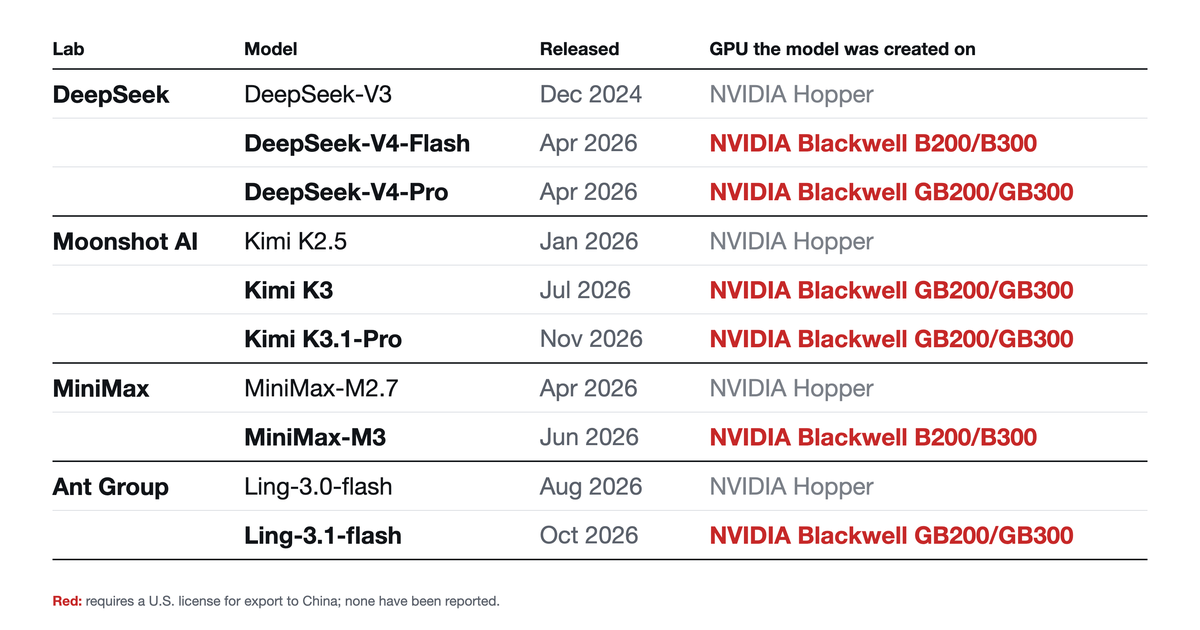
这张图片提供了取证分析中识别出的特定模型和实验室的视觉总结。
硬件指纹机制
证据源于模型的“权重”——即决定 AI 如何处理信息的数十亿个数字。在初始训练阶段,这些权重使用称为 Philox 的确定性伪随机数生成(PRNG)算法分配初始值。
由于软件(PyTorch)将这项工作分配到 GPU 上的并行线程中,特定的处理单元数量(流式多处理器,即 SM)决定了这些数字如何分布。具有不同 SM 数量的芯片会将相同的随机数放置在权重矩阵的不同位置。
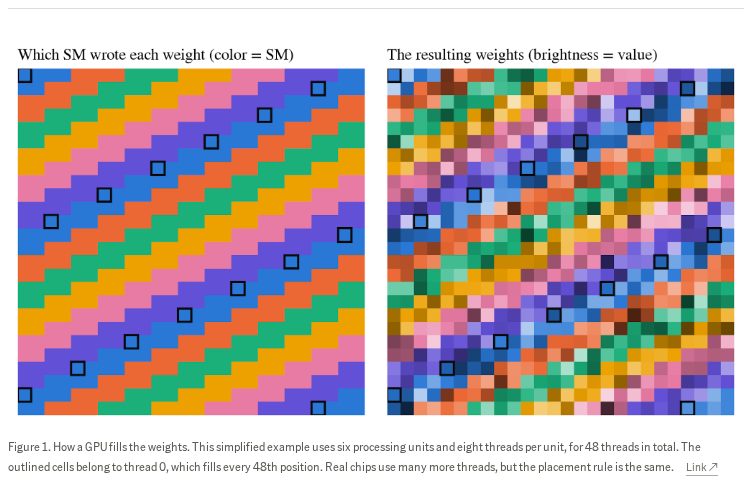
该图表解释了硬件配置如何影响权重分布的基本机制。
通过将发布的权重与数千种潜在配置进行比较,研究人员可以识别出确切的硬件布局。例如,Blackwell B200/B300 芯片使用 148 个 SM,而 GB200/GB300 芯片使用 152 个 SM。相关模型与这些特定数量高度匹配,具有极高的统计显著性。
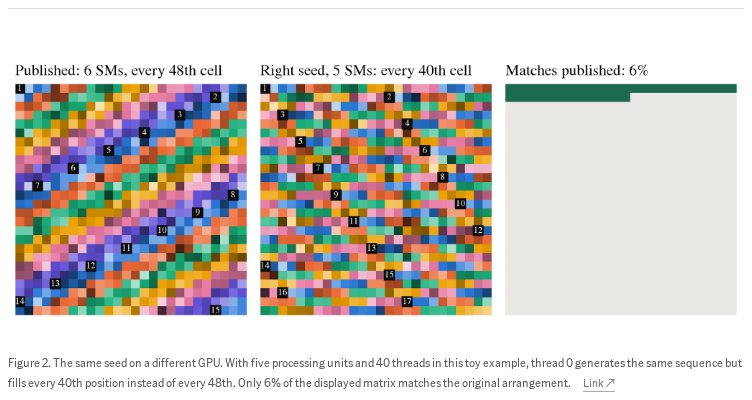
此视觉效果演示了更改硬件布局如何改变生成的权重分布。
“这些发现表明,几家领先的中国 AI 开发商已开始使用 Blackwell 来训练他们最新的模型。”
— Top Chinese Frontier AI Models Carry the Fingerprint of Export-Controlled NVIDIA Blackwell GPUs
硬件转变时间线
取证数据揭示了中国实验室所使用的硬件发生的明显转变。例如,DeepSeek 的 V3 模型(2024 年 12 月发布)匹配 Hopper 时代的指纹,而其 V4-Flash 和 V4-Pro 模型(2026 年 4 月发布)则匹配 Blackwell 架构。
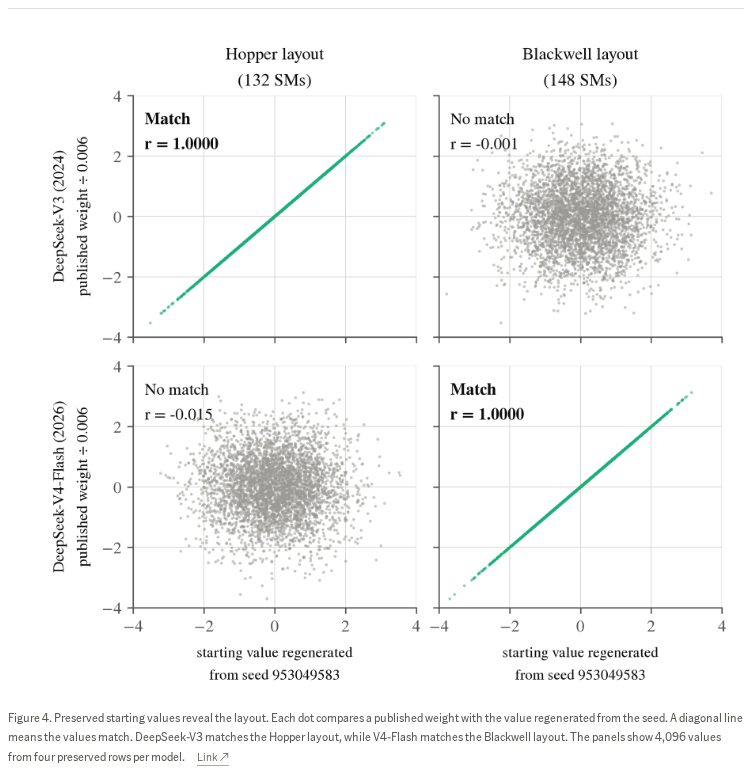
这张图片提供了研究中使用的硬件指纹技术的首要证据。
在 Moonshot AI 观察到了类似的模式,其模型在 2026 年 1 月至 2026 年 7 月之间从 Hopper 转向 Blackwell。Ant Group 也显示出转变,其 Ling-3.0-flash 模型使用 Hopper,而 Ling-3.1-flash 发布版本则转向了 Blackwell。
HN Digest 根据 unemploymentlabs.com 报告的数据绘制;数值按来源原文显示。
值得注意的是,并非所有中国实验室都进行了切换。来自阿里巴巴、智谱和腾讯的模型仍显示 Hopper 时代的指纹,而美团报告使用“AI ASIC 超级 Pod”,这些 Pod 完全没有显示 NVIDIA 硬件特征。
规模与经济影响
分析表明,这些训练运行是在大规模的数据中心级别进行的。根据模型的规模和训练数据量,研究人员估计每次运行需要在两到三个月内需要 500 到 3,000 个 Blackwell GPU。
按每块 GPU 约 70,000 美元的成本计算,这些集群中最大的集群初始化成本将在 1.5 亿美元到 2 亿美元之间。五个已识别的 Blackwell 训练模型的总投资可能超过 5 亿美元,且不包括初始训练运行的成本。
虽然这些发现提供了获取硬件的技术证据,但它们并未确定芯片是如何获得的、它们位于何处,或者是否违反了特定的出口法律。
Hacker News 读者的反应
- 替代方案: 一位评论者建议,政府可能会故意容忍某些出口以维持地缘政治稳定,或者为了在允许市场运作的同时创造出符合规定的战略假象。 评论 ↗
- 质疑: 另一位用户认为,由于存在庞大的转售灰色市场,出口管制从根本上是无效的,并指出类似的限制未能阻止西方芯片进入其他受限地区。 评论 ↗
- 技术补充: 一位评论者对指纹识别方法的稳健性表示技术上的怀疑,指出他们需要验证 PyTorch 并行 philox 基础 PRNG 的具体行为。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗