Claude Fable 5.2 (Max) 在 Artificial Analysis Intelligence Index 上获得了 65 分,远高于同类模型 40 分的中位数。虽然这表明了极高的智能水平,但该模型的表现伴随着显著的效率权衡:完成单个 Intelligence Index 任务需要 45.0 分钟,而同类模型的中位数为 12.9 分钟。
智能与性能指标
Claude Fable 5.2 (Max) 模型在包括知识工作、编码、科学和通用知识在内的系列评估中表现出高智能。它在 Artificial Analysis Intelligence Index 上获得了 65 分,该指数包含了九项不同的评估,例如 AA-Briefcase v1.1 和 FrontierCode 2.0。
尽管拥有高智能评分,该模型的表现受到显著延迟的阻碍。它记录的首个回答 token 时间为 171.16 秒,输出速度为每秒 101 个 token,导致整体任务完成时间缓慢。
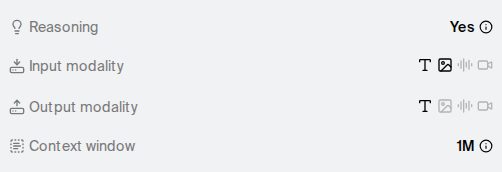
此截图提供了性能指标部分提到的具体技术数据点,如 token 速度和智能评分。
“Claude Fable 5.2 (Max, Default Fallback) 在 Artificial Analysis Intelligence Index 上获得 65 分,远高于同类模型(中位数为 40)的平均水平。”
— Claude Fable 5.2 (max) - Intelligence, Performance & Price Analysis | Artificial Analysis
成本与冗余权衡
该模型的运营成本显著高于同类产品的行业平均水平。其输入每 100 万 token 成本为 8.00 美元,输出每 100 万 token 成本为 40.00 美元,导致每个 Intelligence Index 任务的平均成本为 26.54 美元。
图表由 HN Digest 根据 artificialanalysis.ai 报告的数据绘制;数值与来源一致。
这些成本的主要驱动因素是模型的极端冗余。在 Intelligence Index 评估期间,它生成了 2.75 亿个输出 token,这几乎是同类模型使用的 7280 万个 token 中位数的四倍。
模型变体与局限性
Claude Fable 5.2 的发布包含了针对不同需求定制的五个不同模型。例如,“Low”变体提供最佳速度,每项任务耗时 6.5 分钟,且成本最低,每项任务仅为 3.10 美元,展示了该版本中广泛的性能特征。
虽然 Max 变体提供了最高的智能,但与同类模型相比,其高冗余度和缓慢完成时间的具体原因在当前分析中尚未明确。此外,除了“Low”变体外,该版本中另外三个模型的具体名称和指标目前尚未详细列出。
Hacker News 读者的反应
- 替代方案: 一位评论者指出,由于输出 token 的显著增加,该模型的每项任务成本比前代产品翻了一倍。 评论 ↗
- 质疑: 另一位用户建议,该模型的表现可能受到早期获取基准测试的影响,并指出它可能在公开发布前尚未运行结束。 评论 ↗
- 亲身经验: 一位评论者认为,“Max”版本可能处于收益递减的领域,只有在严格需要每一点性能时才应使用。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗