Linux 内核的一个尺寸计算 Bug 可能会阻止系统映射多个 32 GB 的可重构 BAR(Base Address Registers)时,如果这些 BAR 连接在 PCIe 交换机后,这实际上阻碍了 GPU 之间高性能的对等(P2P)通信。这是因为内核低估了容纳大型内存块与小型寄存器窗口之间对齐间隙所需的地址空间数量。
对齐间隙问题
当 GPU 使用可重构 BAR 时,它会将整个 VRAM(例如 32 GB)映射到 CPU 的地址空间中。然而,许多 GPU 还需要一个用于驱动通信的小型“doorbell” BAR。由于这些大型 BAR 必须从特定的边界(例如 32 GB)开始,紧随 32 GB BAR 之后的 2 MB doorbell 仍会迫使下一个设备从下一个 32 GB 增量处开始。
Linux 7.0 内核在 `pbus_size_mem()` 函数中包含一个回归错误。它通过求和其子设备的尺寸来计算交换机的总窗口。因为它将这些视为简单的求和,而不是考虑到对齐间隙,它认为卡片占据的空间比实际占用的空间更小,从而导致“无法分配;无空间”的错误。
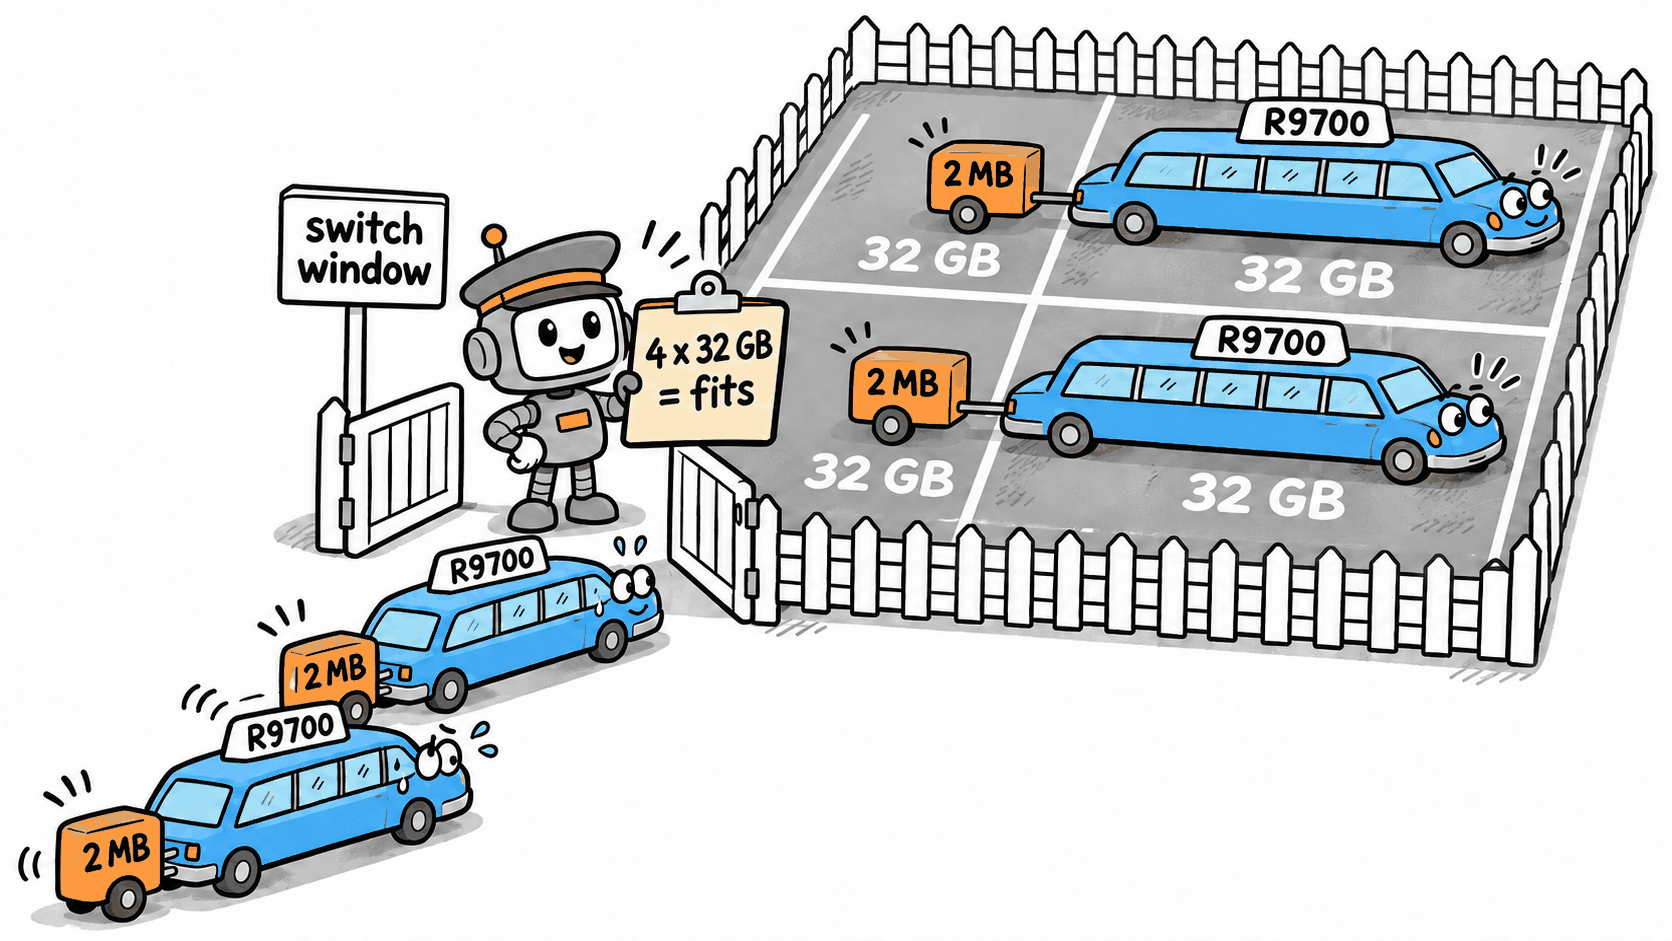
此插图提供了一个尺寸 Bug 的视觉隐喻,即内核认为可用空间充足,尽管实际存在对齐要求。
“内核给交换机分配了约 128.6 GB 的窗口。随着每个 BAR 后放置 doorbell,按照 Linux 7.0 的布局方式,四个窗口跨度达到 224 GB(三个 64 GB 插槽加上最后一张卡的 32 GB 及其 doorbell)。”
— Fitting Four 32 GB Resizable BARs Behind a PCIe Switch on Linux
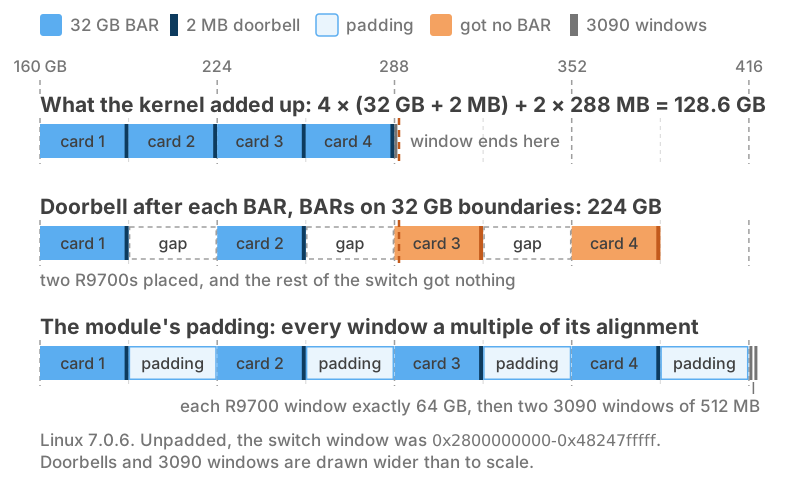
此图表展示了特定的对齐间隙问题,其中内核的“简单求和”计算未能考虑到大型 BAR 所需的 32 GB 填充。
绕过内核尺寸 Bug
为了解决这个问题,自定义内核模块 (`gpu-rebar-layout`) 在 initramfs 中运行,这是内核在加载任何 GPU 驱动之前启动的微型文件系统。该模块识别目标 GPU,将其 BAR0 大小设置为最大支持值(例如 32 GB),然后移除并重新扫描 PCIe 交换机上方的根端口。
在重新扫描期间,该模块手动提高每个较小内存 BAR 的对齐高度,使其与该段上最大的 BAR 相匹配。这确保了每个 R9700 窗口恰好占用 64 GB 的地址空间,从而允许内核分配器成功放置所有设备,而不会发生重叠或空间不足。
性能提升与权衡
正确映射这些 BAR 对于对等(P2P)通信至关重要,它允许 GPU 在不涉及 CPU 的情况下互相复制数据。在四块 AMD Radeon AI PRO R9700 的测试中,此配置实现了每对 14.0 GB/s 的速度,四块卡以环形方式复制时总速度达到 54.7 GB/s。
该变通方案涉及特定的权衡:它必须在启动过程的非常早期加载,并且可能需要禁用 GPU 音频功能以释放更多地址空间。此外,虽然目前正在为 Linux 内核开发包含 14 个补丁的修复系列以正确解决此尺寸 Bug,但该模块仍是当前版本的必要权宜之计。
Hacker News 读者的反应
- 替代方案: 评论者指出,文章作者解释说他们开发该模块是为了实现四块 GPU 之间的对等传输,并指出禁用此功能会显著降低预填充任务中的性能。 评论 ↗
- 技术补充: 一位评论者澄清,该问题源于某些主板上的固件限制,其中 BIOS 限制了 PCI 设备的可用地址空间,导致大型 BAR 重叠并超出可用插槽。 评论 ↗
- 质疑: 几位评论者表示沮丧,因为软件层和隐藏配置正阻止硬件利用其全部物理能力,他们质疑为什么如此大的虚拟地址空间不能被更轻松地管理。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗