Google 正在扩展其第八代张量处理单元(TPU)产品组合,加入了两款全新的专用系统:TPU 8tx 和 TPU 8i Max。这些新增产品旨在应对 AI 的“智能体时代”,在这一时代,工作负载日益需要高安全环境来处理敏感数据,并具备同时跨越海量信息进行推理的能力。
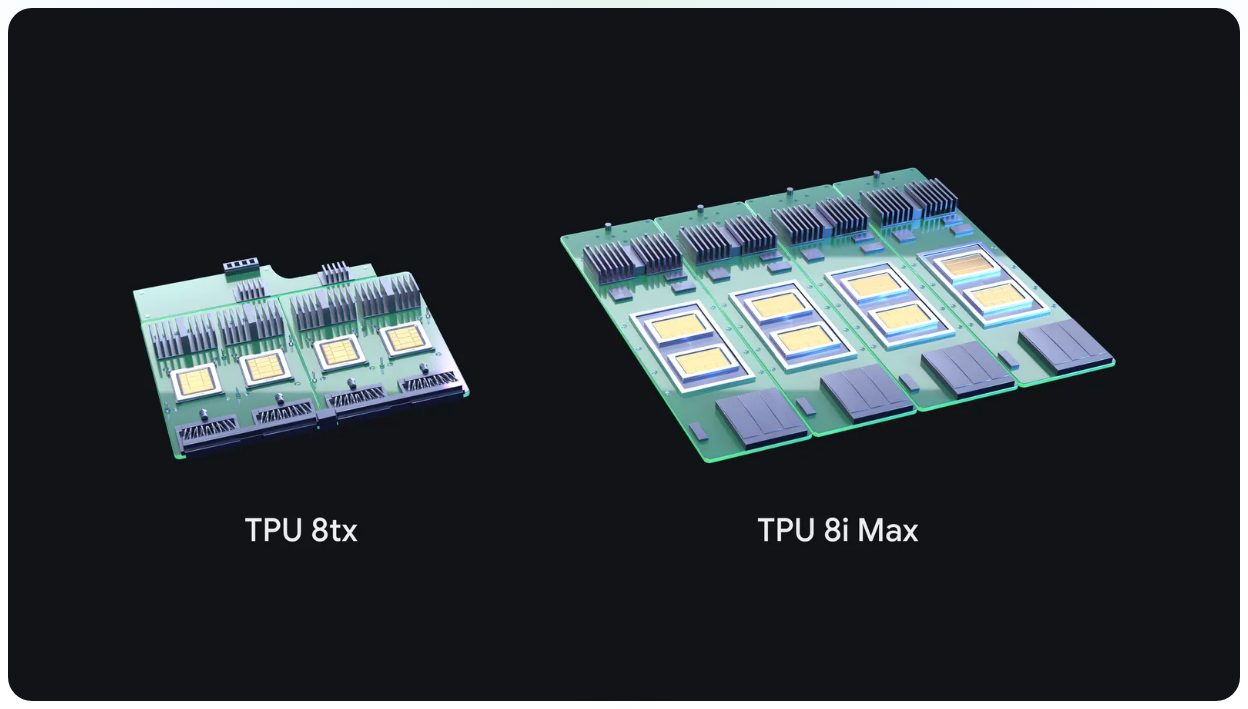
这张图片展示了第八代 TPU 产品组合中推出的两个主要新系统。
用于安全和上下文的专用硬件
TPU 8tx 专门为需要在处理敏感数据的同时运行前沿模型的受监管企业和政府而设计。与保护静态或传输中数据的标准加密不同,8tx 将安全性直接构建到硬件层,确保数据即使在内存中处理时也能保持隔离。
通过将训练级计算与快速推理网络相结合,8tx 允许组织在单个系统上同时运行和定制模型。这种配置使团队能够在无需在不同集群之间迁移敏感数据的情况下,进行私有微调和强化学习。
“TPU 8tx 为敏感数据提供硬件级安全,而 TPU 8i Max 处理海量上下文窗口。”
— Our newest TPUs: 8tx and 8i Max, built for the agentic era
通过 TPU 8i Max 打破内存墙
TPU 8i Max 解决了“内存墙”问题——这是当 AI 智能体必须处理海量数据(如整个软件代码库或数小时的视频)时出现的瓶颈。它通过将两个 TPU 8i 芯片组合到单个封装中,实现计算和内存的同步扩展来达成这一目标。
通过将基础 8i 模型的 SRAM 和 HBM 带宽翻倍,8i Max 确保处理器始终配备必要的关键数据,从而避免大型工作负载停滞。这种设计还允许数据中心通过在现有机架占地面积内容纳双倍硅片,从而每平方英尺和每瓦提供显著更多的计算能力。
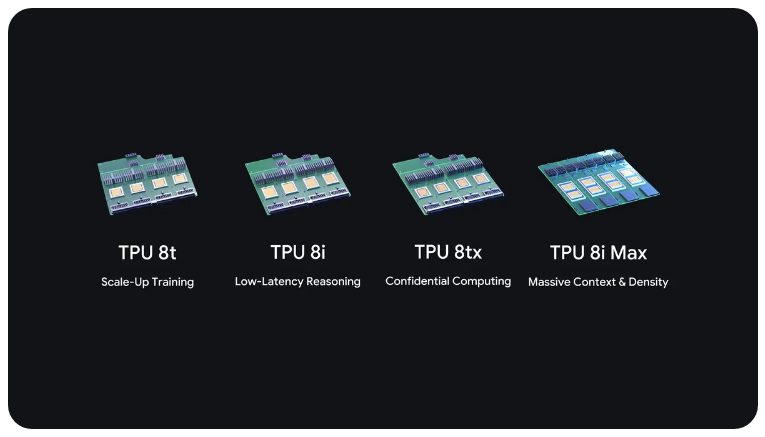
此视觉效果有助于将新的 8tx 和 8i Max 模型与现有的 8t 和 8i 系统区分开来。
系统模块化与开发者可访问性
Google 将这些新产品区别为“系统”而非仅仅是“芯片”。由于硅片制造受限于长周期的生产周期,Google 使用模块化架构,允许工程师围绕核心 TPU 构建块快速调整封装、高速内存和光学网络。
为了降低准入门槛,Google 正在将这些系统与开放软件栈相结合。这包括 TorchTPU,它允许 PyTorch 代码和 Hugging Face 模型原生运行在 TPU 上,以及一个新的 TPU 智能体套件,该套件使用自然语言自动化入驻和内核自动调优。
性能指标与局限性
虽然 Google 报告称 8t 和 8i 系统比前几代提供了高达 2.7 倍的训练性能和 80% 更好的推理性价比,但公告中并未提供新 8tx 和 8i Max 模型的具体数值。
HN Digest 根据 cloud.google.com 报告的数据绘制;数值与来源一致。
目前的文档侧重于定性改进,例如“双倍计算”以及安全功能带来的“近乎零性能损失”。具体的每 token 瓦特数或与 NVIDIA 最新产品直接的性价比对比仍未说明。
Hacker News 读者的反应
- 技术补充: 一位评论者指出,文章未能定义 TPU 为张量处理单元(Tensor Processing Unit)。 评论 ↗
- 质疑: 几位评论者表示沮丧,因为公告缺乏具体的性能指标(如每 token 成本或功耗效率),且未提供开发者实际购买或访问硬件的明确路径。 评论 ↗
- 替代方案: 一位评论者指出,虽然公告营销色彩浓厚,但可以通过其他在线渠道找到更多技术规格。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗