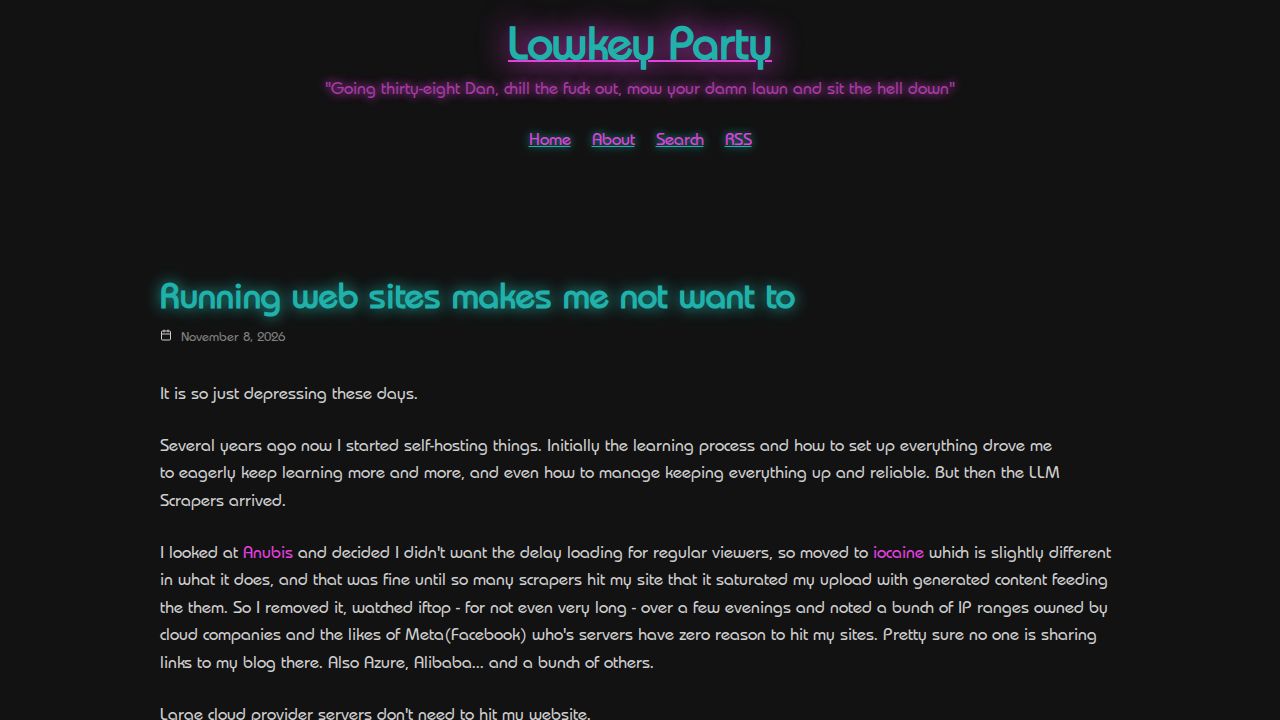
一位自托管爱好者计划将他们的摄影作品从网络转移到实体小册子,以逃避企业 AI 爬虫带来的“令人沮丧”的现实。作者报告称,这些源自 Azure 和阿里巴巴等大型云服务提供商的爬虫,为了向大语言模型(LLMs)提供数据,已经耗尽了他们的家庭上行带宽。
LLM 爬虫的影响
作者描述了自托管体验的转变,从学习系统管理的乐趣转变为处理“LLM 爬虫”的挫败感。这些自动化系统访问作者的网站以收集 AI 训练数据,经常耗尽家庭网络的上行容量。
虽然一些爬虫通过 SDK 使用住宅 IP 段——这些 IP 在不影响真实用户的情况下更难拦截——但大部分有问题的流量源自少数几个大型云分配的 /16 IP 段。
“我不希望我的时间花在最终变成喂养那些机器的东西上。”
— Running web sites makes me not want to - Lowkey Party
技术缓解措施
为了防御这些流量,作者利用 `nftables` 和 `nft-blackhole` 来丢弃来自已知云提供商 IP 段的连接。这些工具允许在防火墙层面对网络流量进行细粒度的过滤。
尽管付出了这些努力,作者指出,由于“合法”抓取的庞大数量,如果不具备高水平的技术技能或支付高额费用给大型公司提供内容分发网络(CDN),就很难维持一个网站。
向实体媒介的转变
由于“企业技术的过度扩张”,作者正考虑完全移除他们的摄影网站。目标是转向销售实体小册子,确保作品留在物理世界中,而不是去喂养那些生产“平庸创意模仿品”的机器。
这一举动代表了一种权衡:虽然生产和分发实体商品需要更多的手动工作,但它消除了防御自动化数据采集的负担。作者将此视为当前互联网现状中的“一线生机”。
Hacker News 读者的反应
- 技术补充: 一位评论者建议使用 CDN 来提供大部分静态页面,并在服务器端缓存动态内容以管理负载。 评论 ↗
- 技术补充: 另一位用户建议使用防火墙支持,在 IP 喂入“毒药”内容后丢弃流量,同时建议不要在出口处进行流量整形,以免耗尽工作进程。 评论 ↗
- 质疑: 一位评论者认为,期望一个网站永远不接收机器人流量是不现实的,并建议改用云提供商提供的简单黑名单。 评论 ↗
- 替代方案: 一位评论者分享了一个观点:允许机器人抓取他们的博客可能是有益的,因为这可能会让 AI 训练偏向于他们特定的观点。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗