在 Apple M1 系统上进行的基准测试中,blqsort 算法在 0.68 秒内完成了 5000 万个随机 double 类型的排序,优于标准 C++ 库的 std::sort(耗时 1.33 秒)。这种性能提升是由一系列优化驱动的,旨在最大限度地减少 CPU 流水线停顿,并比通用排序实现更高效地处理特定的数据分布。
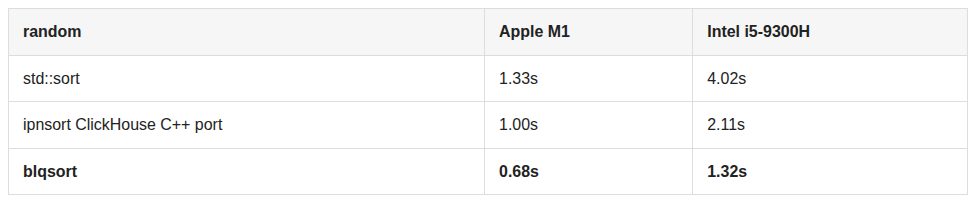
此表提供了引言中提到的性能提升的实证证据。
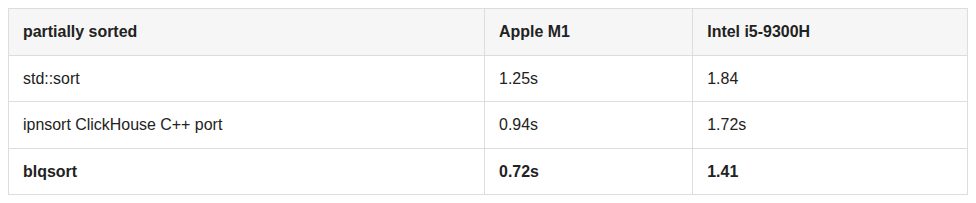
此视觉效果支持关于 blqsort 如何处理不同数据分布和大小的讨论。
消除分支预测错误
标准的快速排序实现通常依赖“if”条件来划分数据。在现代 CPU 上,如果数据分布是随机的,这些条件对于分支预测器来说是不可预测的,迫使处理器刷新其流水线并重新开始执行。
blqsort 通过使用无分支方法来解决这个问题。它不使用条件跳转,而是使用条件递增指令来移动元素。虽然这为每个元素引入了无条件的内存写入,但作者指出,写入带来的开销显著低于频繁分支预测错误造成的性能损失。
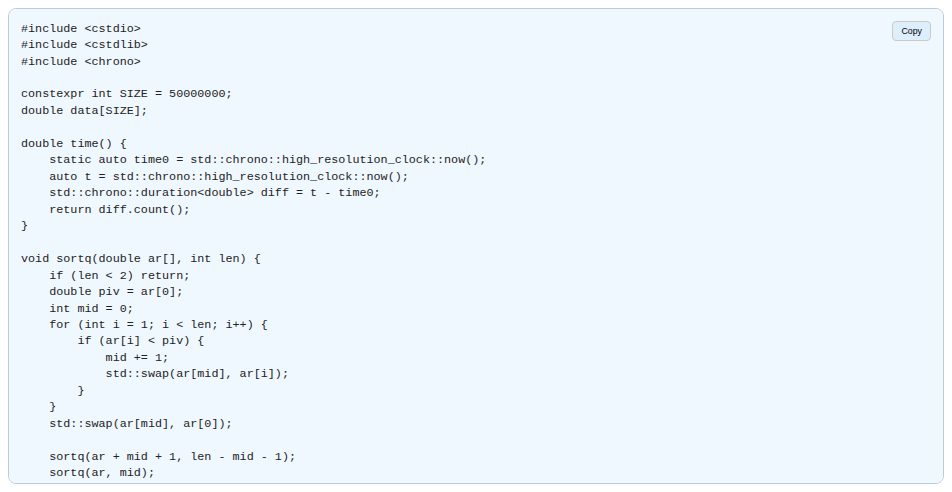
此代码片段说明了从标准条件逻辑到优化后的 blqsort 结构的转变。
“blqsort 的核心概念是无分支划分、针对小分区的排序网络以及良好的基准点选择。”
— A Fast Quicksort
针对小分区的排序网络
对于非常小的分区(例如少于 20 个元素的分区),传统的快速排序不如简单的方法高效。blqsort 用排序网络取代了这些方法,排序网络使用固定的比较和交换序列来对元素进行排序。
该实现包含了针对最多 16 个元素分区大小的特定逻辑。通过使用这些网络,该算法避免了递归调用的开销,并为排序过程的“基础情况”提供了高度优化的路径。
基准点选择和边缘情况处理
为了在不同数据类型中保持高性能,blqsort 采用了多步骤基准点选择过程。它从分区中确定几个中位数来计算最终的中位数,确保在划分步骤中数据分布更均匀。
该算法还包含了针对困难输入的保护措施。如果数据分布仍然不均匀(通常是由于许多相同元素引起的),系统将切换到堆排序。此外,它还会识别并分组重复键以保持效率。
性能权衡与局限性
blqsort 速度的主要权衡是使用了无分支逻辑,这要求编译器即使在条件不满足时也要执行内存写入。由于编译器无法保证此类写入对分配的缓冲区是安全的,因此它无法自动将此操作优化为条件写入。
虽然 blqsort 在随机数据上的表现优于 std::sort,但其相对优势因架构而异。例如,在 x86 系统上,观察到 blqsort 与 std::sort 之间的性能差距约为 10%。
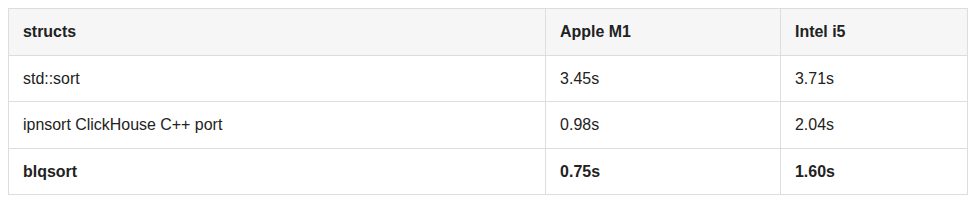
此表说明了最后一部分讨论的性能权衡和架构变化。
图表由 HN Digest 根据 tiki.li 报告的数据绘制;数值与源文件一致。
Hacker News 读者的反应
- 替代方案: 一位评论者建议,对于特定的排序,基数排序可能异常快速,因为它在数据上执行简单的扫描,且具有出色的引用局部性。 评论 ↗
- 质疑: 一位评论者对性能提升表示怀疑,认为对于许多问题,输入/输出操作占用的执行时间比排序算法本身更多。 评论 ↗
- 技术补充: 另一位用户指出,快速排序的效率很大程度上归功于其 O(log n) 的空间需求,这使其区别于合并排序等算法。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗