向内核请求内存的单次系统调用大约需要 610 纳秒,如果程序每进行一次微小的分配就必须执行一次此类调用,其成本将变得难以承受。为了解决这个问题,malloc 函数充当一个复杂的用户空间管理器,它请求大块内存并维护自己的内部记账,以高效地处理较小的请求。
此表格提供了支持 malloc 比直接系统调用快得多的实证数据。
内核交互的成本
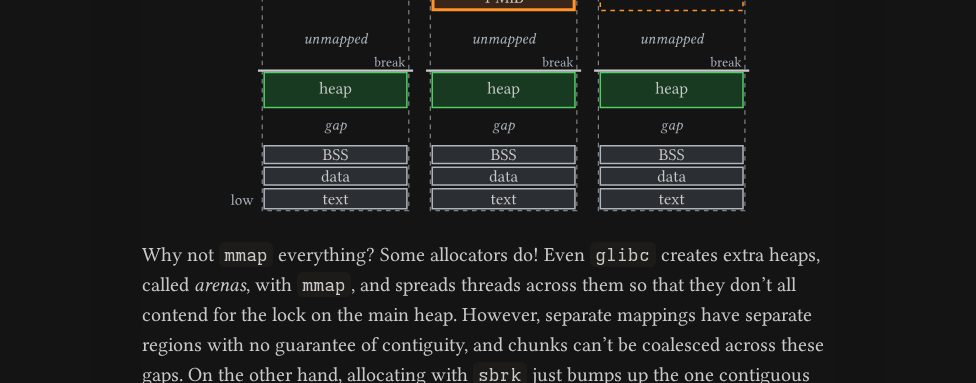
当程序请求内存时,它驻留在被划分为文本、数据、bss、堆和栈等区域的地址空间中。虽然内核最终拥有物理内存,但由于从用户空间切换到内核空间的开销,为每一次微小的分配调用内核都是低效的。

此视觉效果有助于说明文中提到的进程地址空间的不同区域,如堆和栈。
通过一次性请求大块内存——例如在单次操作中跳跃 132 KiB——malloc 允许程序在无需进一步内核干预的情况下执行数百次后续分配。这种策略确保了大多数内存请求由库的内部逻辑处理,而不是缓慢的系统调用。
由 HN Digest 根据 benmandrew.com 报告的数据绘制;数值与源文件一致。
“malloc 从内核请求大块内存并自行将其切割。”
— What is malloc doing, anyway?
内部记账和空闲列表
为了管理这些大块内存,malloc 使用包含大小头的“块”。此头信息允许分配器知道有多少内存被占用以及下一个块从哪里开始,而无需用户在释放操作期间提供大小。
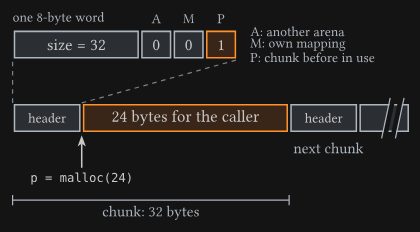
此图表解释了内部记账机制,其中头信息位于分配给用户的实际内存之前。
当内存被释放时,它会被放入空闲列表中。分配器随后执行“拆分”,将大的空闲块分解为适合特定请求的小块,并执行“合并”,将相邻的空闲块重新合并为较大的块,以防止内存变得不可用。
分配器确保所有返回的指针都是 16 字节对齐的,这是 x86-64 架构的标准,确保内存与任何 C 数据类型兼容。
碎片化和驻留内存
堆管理的一个重大限制是碎片化。由于内核只能从堆的最顶端(“程序断点”)回收内存,任何位于空闲间隙上方的存活内存块都会阻止该间隙返回给系统。
这意味着在长时间运行的程序中,碎片化可能导致驻留集大小 (RSS) 随着时间的推移而增长。即使应用程序“释放”了大量内存,如果即使只有一个微小的存活分配位于比空闲空间更高的地址,物理内存仍将保持占用状态。
使用 mmap 处理大分配
对于非常大的内存请求(例如超过 128 KiB 的请求),malloc 可能会切换策略并使用 mmap 系统调用。这会在进程的地址空间中创建一个完全独立的映射,它不是标准堆的一部分。
与堆内存不同,这些通过 munmap 系统调用释放后,mmap 映射的块可以立即返回给内核。这允许分配器处理海量分配,而不会导致堆碎片化或阻止程序断点收缩。
Hacker News 读者的反应
- 替代方案: 一位评论者对“仅栈”语言表示兴趣,认为这是消除与 malloc 抽象相关的复杂性和开销的一种方法。 评论 ↗
- 质疑: 一位读者认为检查 malloc() 并不能揭示内存实际上是如何分配的,因为真正的底层逻辑存在于内核和设备固件中。 评论 ↗
- 亲身经验: 一位评论者分享说,使用具有显式分配器处理的语言帮助他们培养了更好的编码习惯,因为这使内存分配成为一种深思熟虑的设计选择。 评论 ↗
- 亲身经验: 另一位用户发现研究 malloc 源代码并编写一个玩具分配器对于理解计算机架构与应用程序代码之间的桥梁非常有用。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗