目前的 AI Agent 内存分布在至少四种不同的格式中,范围从像 `CLAUDE.md` 这样的 Markdown 文件到 JSONL 知识图谱以及托管的仓库事实。由于这些格式不兼容,一个工具中学习到的经验无法被另一个工具中的编辑器 Agent 获取,这为使用多个 AI 工具的开发者造成了孤立的体验。
Agent 内存的碎片化
随着 AI Agent 生态的增长,开发者正在构建具有独特架构和存储方法的定制化内存层。这些包括本地文件、命名空间存储和时间知识图谱,但这些系统目前都无法原生相互通信。
LoreKit 的作者认为,问题不在于缺乏工具,而在于缺乏共享的共识。如果没有共同的数据模型,每一个新解决方案都会增加另一种孤立的格式,从而阻碍跨工具的上下文共享。
OpenTelemetry 模型
该提案与可观测性行业建立了直接的类比。在 2019 年之前,不同的供应商提供专有的仪表化库和数据格式,迫使用户在切换供应商时必须重新对代码进行仪表化。
该行业通过合并到 OpenTelemetry 解决了这一问题,OpenTelemetry 标准化了跨度(span)、指标和日志记录的定义,以及共享名称(语义约定)和通用协议(OTLP)。这使得整个工具生态系统能够在竞争存储和分析的同时,读取彼此的数据。
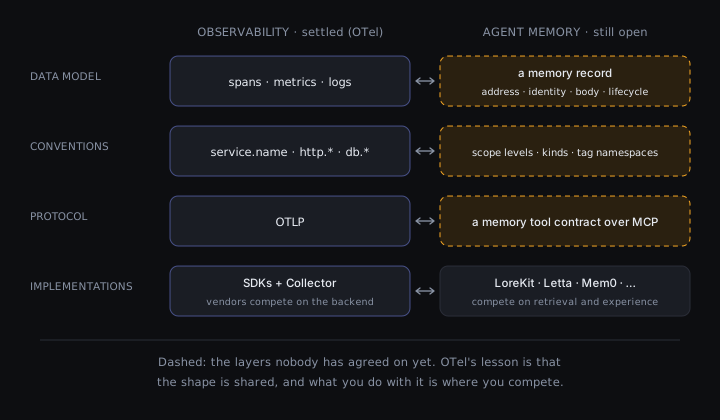
文章解释了该提案如何直接类比可观测性行业向 OpenTelemetry 的转变,以解决碎片化问题。
Agent 内存目前处于类似的阶段,其格式尚处于足够年轻的阶段,可以在它们变得根深蒂固之前被标准化。
导出 vs. 实时寻址
该提案区分了两个主要问题:“导出”和“实时寻址”。“导出”是指将用户的内存从一个供应商移动到另一个供应商,这是几个现有的草案(如 Open Memory Protocol)试图解决的问题。
“实时寻址”是更复杂的挑战,它允许 CI 作业、编辑器 Agent 和评审机器人同时在同一个仓库中工作。共享规范将提供一个通用的“地址”(例如特定的仓库或分支),这些工具可以在其中实时达成共识,确定内存记录的含义。
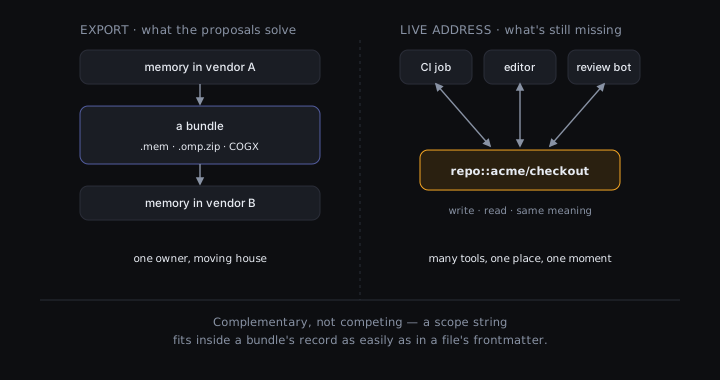
此视觉效果澄清了讨论的两个主要问题:在工具之间移动数据与实时的共享访问。
提议的架构与权衡
提议的记录将包括唯一 ID、范围(地址)、键、生命周期(过期时间)以及一个“written_by”字段,用于识别是人类还是 Agent 创建了该内存。这种结构允许工具根据信息的来源来决定信任程度。
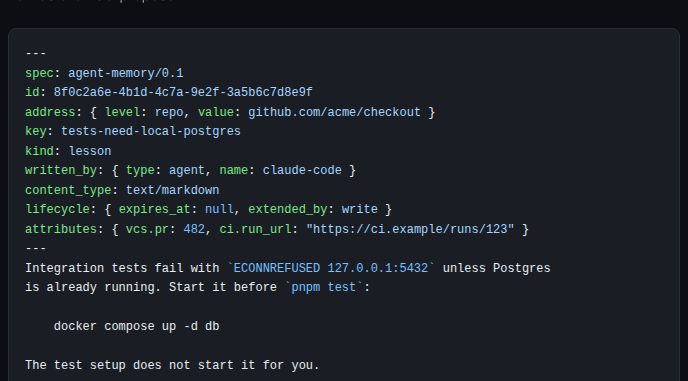
文章描述了提议的记录将包含哪些特定字段以促进互操作性。
批评者指出,共享标准可能是一种“过早的抽象”或提示注入风险。该提案建议通过包含签名并将记录链接到特定的代码版本来减轻这些风险,尽管哪个地址级别(例如仓库 vs. 分支)应该被标准化仍是一个开放的问题。
Hacker News 读者的反应
- 质疑: 一位评论者认为,现在标准化抽象可能过早,因为行业尚未完全理解处理上下文和内存持续时间的最佳方法。 评论 ↗
- 质疑: 几位评论者对统一格式的必要性表示怀疑,指出 Agent 已经能够读取和遍历各种文件格式来检索上下文。 评论 ↗
- 亲身经验: 一位用户分享了他们完全禁用 Agent 内存的经历,因为 Agent 经常记住错误的信息,他们更倾向于让 Agent 将特定发现记录到文件中。 评论 ↗
- 亲身经验: 另一位评论者建议,最好的方法是为 Agent 提供一个标准目录和最少规则,让 Agent 自主管理内存。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗