生成式 AI 模型在生成非英语语言文本时,比生成英语文本消耗的能量高出 1.4 到 180 倍。这种差异在不使用拉丁字母的语言中最为严重,例如印地语和孟加拉语,处理等效提示词所需的能量分别高出 7.9 倍和 15.3 倍。这一发现表明,当前的大语言模型(LLMs)架构为数十亿非英语使用者制造了巨大的能源和成本障碍。

该图表直观展示了研究的核心发现:非英语语言能耗显著增加,尤其是那些具有复杂脚本的语言。
Token 消耗的机制
这种能耗差异的主要驱动因素是 AI 模型如何将文本处理为“Token”——这是模型使用的基本数据单位。对于像 Devanagari(用于印地语、尼泊尔语和马拉地语)或孟加拉语这样的脚本,基本字符可以改变形状并与重音符号结合,从而产生数百万个独特的字符。
HN Digest 根据 news.umich.edu 报告的数据绘制的图表;数值按来源原文显示。
由于更多的 Token 会消耗更多的计算机内存,模型可用于处理信息的可用空间就会减少。这迫使系统以更小的批次处理 Token,从而显著增加了每个 Token 消耗的能量。
这种复合效应意味着脚本越复杂,推理过程的效率就越低。这种差异在不同模型大小和不同类型的计算机处理器上均存在。
“根据密歇根大学工程学院研究人员的说法,在处理和生成非英语文本时,生成式 AI 消耗的能量更多,有时提供的答案准确性较低,这可能会加剧现有的全球不平等。"
— Generative AI uses more energy on non-English text
全球用户的双重惩罚
除了物理上的能源成本外,研究还发现能耗要求较高的语言往往产生的答案准确性较低。这造成了一种“双重惩罚”,即非英语使用者面临更高的成本和较低质量的输出。
这种差异造成了潜在的数字鸿沟。由于许多公司根据生成的 Token 数量定价,非英语语言的用户可能会面临更高的直接成本。
此外,这些语言较低的准确性可能会让公司更不愿服务于某些市场,这可能会将数十亿母语非英语的人排除在外。
建议的解决方案与局限性
为了解决这些不平等问题,研究人员建议开发人员针对特定语言优化服务,而不是依赖通用模型。这可能包括将查询路由到为特定脚本定制的模型,或者使用可靠的翻译流水线在处理前将提示词转换为英语。
该研究测量了三个开源模型(阿里巴巴的 Qwen 3、Google 的 Gemma 3 和 Meta 的 Llama 3.1),强调了需要更多母语人士的参与。通过众包母语人士来为代表性不足的语言创建高质量的训练数据和资源,可以帮助提高这些系统的效率和准确性。
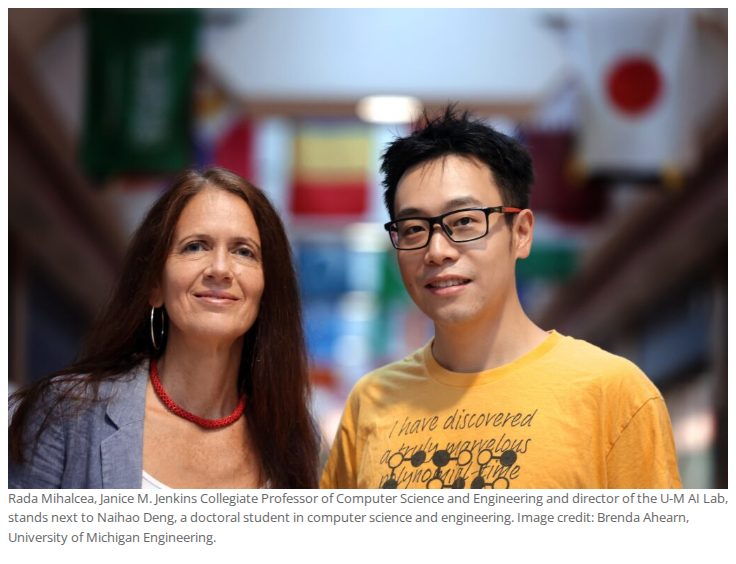
这张图片识别了密歇根大学开展 LLM 语言相关能耗研究的主要研究人员。
研究范围与不确定性
这些发现是基于对三个特定开源模型以及用于创建基准测试的特定翻译工具(No Language Left Behind)的测量得出的。目前尚不清楚像 GPT-4 或 Claude 这样的专有模型与研究中的开源模型相比,如何处理印度语系脚本的 Token 化。
此外,翻译工具本身的特定能耗并非本次测量的重点,这可能会影响最终用户端的效率计算。
Hacker News 读者的反应
- 替代方案: 一位评论者建议,用于衡量效率的指标可能会不公平地惩罚英语,因为大量由非母语人士撰写的训练材料可能会扭曲结果。 评论 ↗
- 质疑: 一位读者质疑了研究结果的相关性,指出所测试的模型大约是 18 个月前的,并询问结果是否仍适用于当前模型。 评论 ↗
- 亲身经验: 几位评论者分享了个人经历,提到 AI 工具默认使用非英语语言,或者在没有特定指令的情况下拒绝提供英语答案。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗