机器学习研究智能体可以在不陷入过拟合陷阱的情况下,成功针对固定基准优化模型,这一现象与标准的教科书预测相矛盾。来自 Amazon Science 的研究人员发现,这是因为成功的策略占据了策略空间中的“低复杂度区域”,允许它们被提炼为极少数的信息标记。
过拟合悖论
在标准的机器学习理论中,反复针对固定的验证集评估模型最终应该导致过拟合。这是因为训练过程“看到”了验证数据,允许模型记住特定的答案,而不是学习潜在的模式。
然而,更广泛的机器学习社区在长期的基准测试上评估模型并迭代改进模型的分布式循环中运行。尽管在相同数据上不断进行这种“爬山”优化,模型仍继续显示出真正的进步,并能很好地迁移到新的、未见的数据集上。
“简短的描述无法作弊,因为没有空间。”
— Why don’t machine learning research agents overfit?
压缩假设
这一悖论的解释在于奥卡姆剃刀的公式化版本:在同样解释数据的假设中,最简单的假设——即可以用最少比特位描述的那个——更有可能具有泛化性。如果一个策略太小到无法记录训练数据,它就无法通过记住数据来作弊。
研究人员假设成功的机器学习策略本质上是紧凑的。一个获胜的策略通常由几个熟悉的选择组成,例如特定的架构家族、优化器或学习率计划。由于这些选择很少,模型对基准测试的真实依赖程度远小于用于寻找该策略的冗长实验记录。
测试信息瓶颈
为了测试这一点,研究人员使用了一个涉及 LLMs 的三智能体设置。一个“探索者”智能体迭代搜索高性能模型,并使用验证集。随后,一个“压缩者”智能体将探索者的工作提炼为非常短的提示词(几个标记)。最后,一个没有访问验证集或探索者记录的“复现者”智能体,尝试仅使用该短提示词来重现结果。
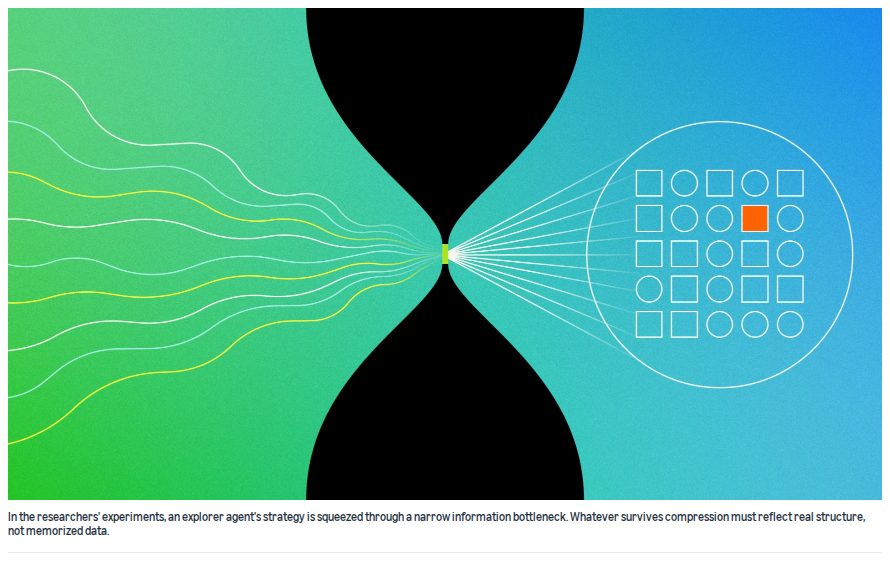
此视觉效果解释了核心实验机制,即压缩探索者的策略以查看它在没有记住噪声的情况下是否仍保留其性能。
结果显示,复现者可以在包括视觉和语言建模在内的八个不同数据集上匹配探索者的性能。这表明指定成功策略所需的信息可以穿过极小的通道,证实了该策略捕捉到了真实的结构,而非记住的噪声。
LLMs 作为知识解码器
该研究强调了为什么 LLMs 在此过程中特别有效。因为它们拥有关于机器学习工具和标准算法的庞大“世界知识”,它们可以解构简练的专家对专家之间的信息。如果短提示词中遗漏了某些细节,LLM 可以根据其内部知识填补合理的默认值。
这张图片说明了专家级的机器学习策略可以通过极少数标记进行沟通,因为接收者已经拥有了必要的上下文。
虽然这证实了为什么 LLMs 能够进行复杂的推理,但它也建立了一个明确的界限:当研究人员故意诱导过拟合时,产生的策略将无法通过压缩测试。这些过拟合的模型无法通过短提示词来复现,因为它们的“知识”与特定的、不可压缩的数据点绑定在一起。
Hacker News 读者的反应
- 技术补充: 一位评论者建议,机器学习模型主要在数据点数量显著超过参数数量时倾向于避免过拟合。 评论 ↗
- 质疑: 一位读者认为现代 AI 模型实际上是过拟合的典型例子,指出尽管基准测试得分很高,它们仍经常表现出幻觉和上下文腐烂。 评论 ↗
- 质疑: 几位评论者对文章的质量表示怀疑,将其描述为“AI 垃圾”,并批评其大量使用 AI 生成的写作风格。 评论 ↗
- 技术补充: 另一位用户指出,机器学习本质上是关于泛化的,而记住模式与死记硬背并不相同。 评论 ↗
以上为 Hacker News 讨论中观点的摘要,并非经过核实的事实。 阅读完整讨论 ↗