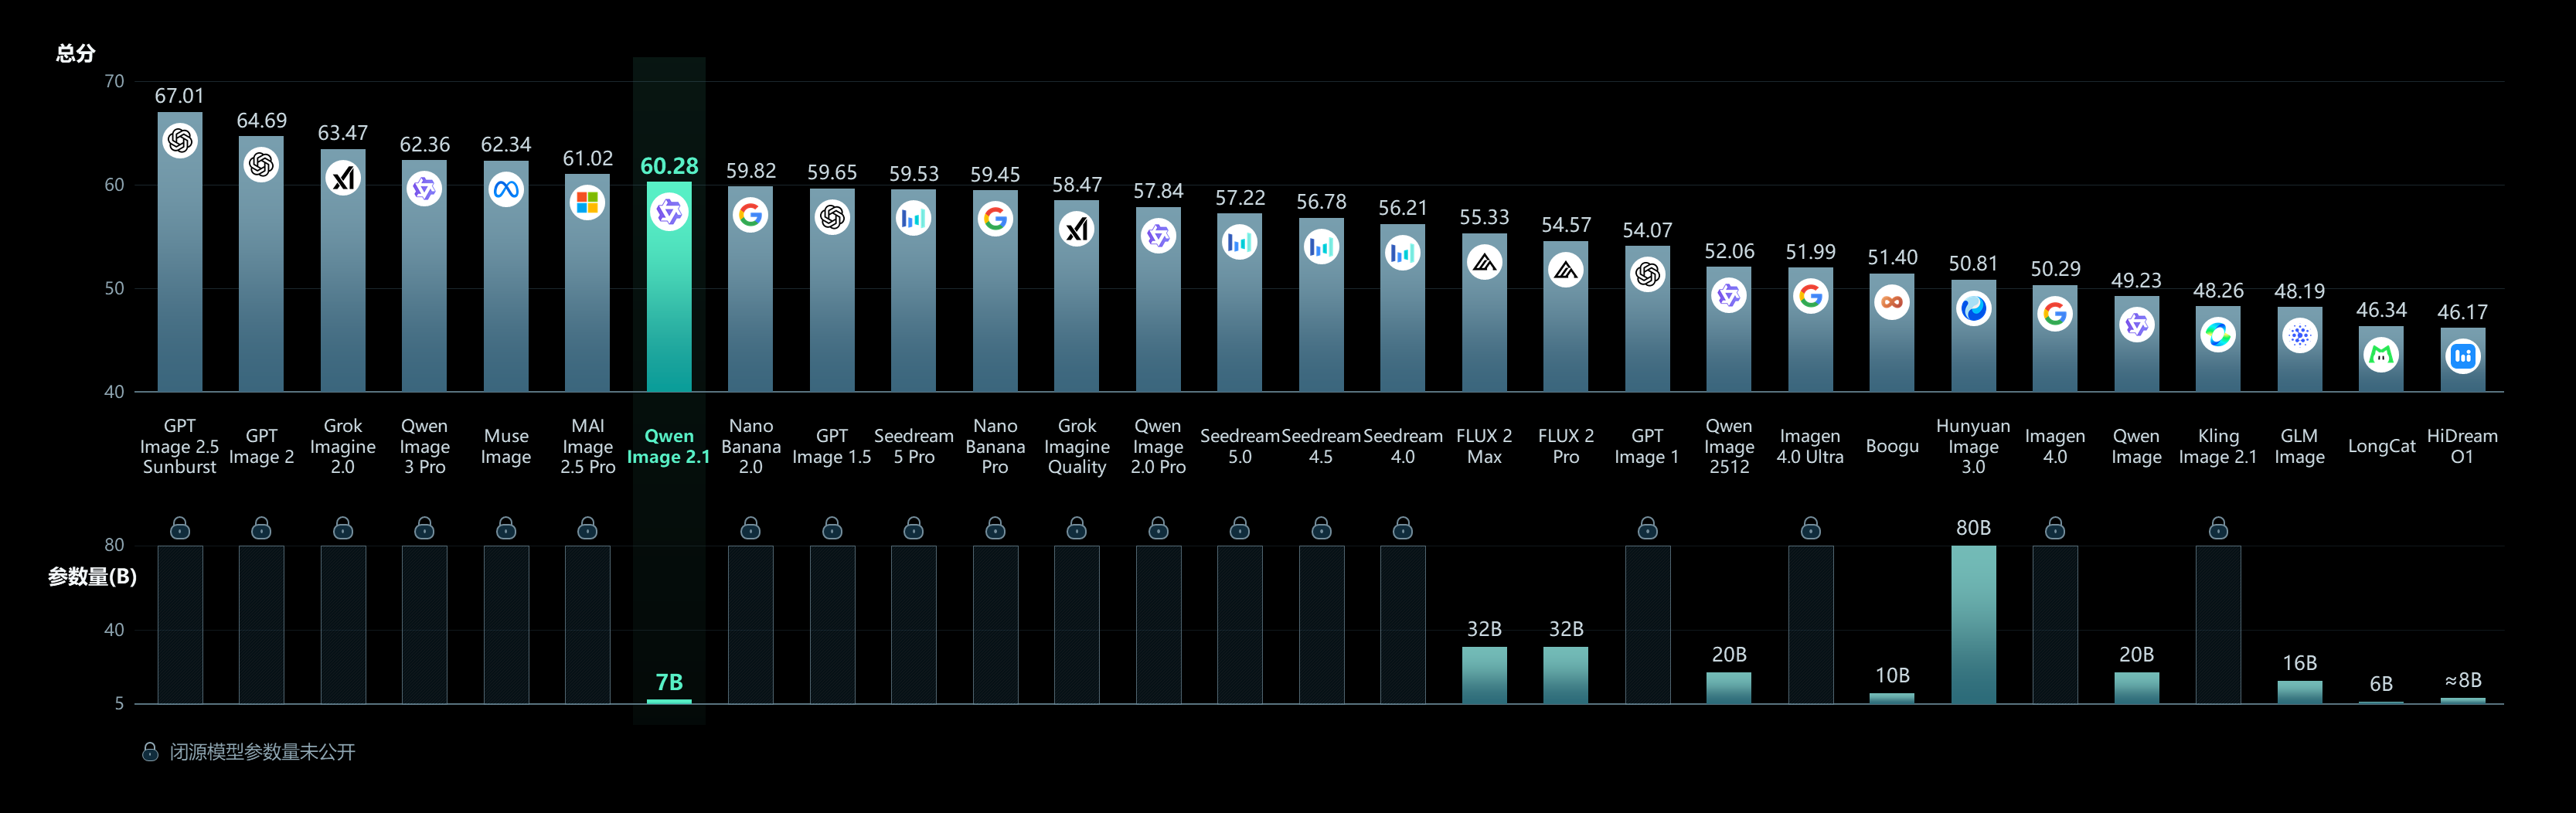
Qwenは2026年9月20日、Image 2.1を発表した。これは文書から画像を生成する機能と画像を編集する機能を、別々のシステムではなくひとつのモデルとして提供するリリースだと公式リポジトリは説明している。視覚生成コンポーネントは70億パラメータで、32層のSingle-Stream Diffusion Transformer、つまりDiTで構成される。この表記は重要だ。70億という数字は画像生成の中核部分に関するもので、全体のパイプラインに含まれる別のテキストエンコーダと区別する必要がある。
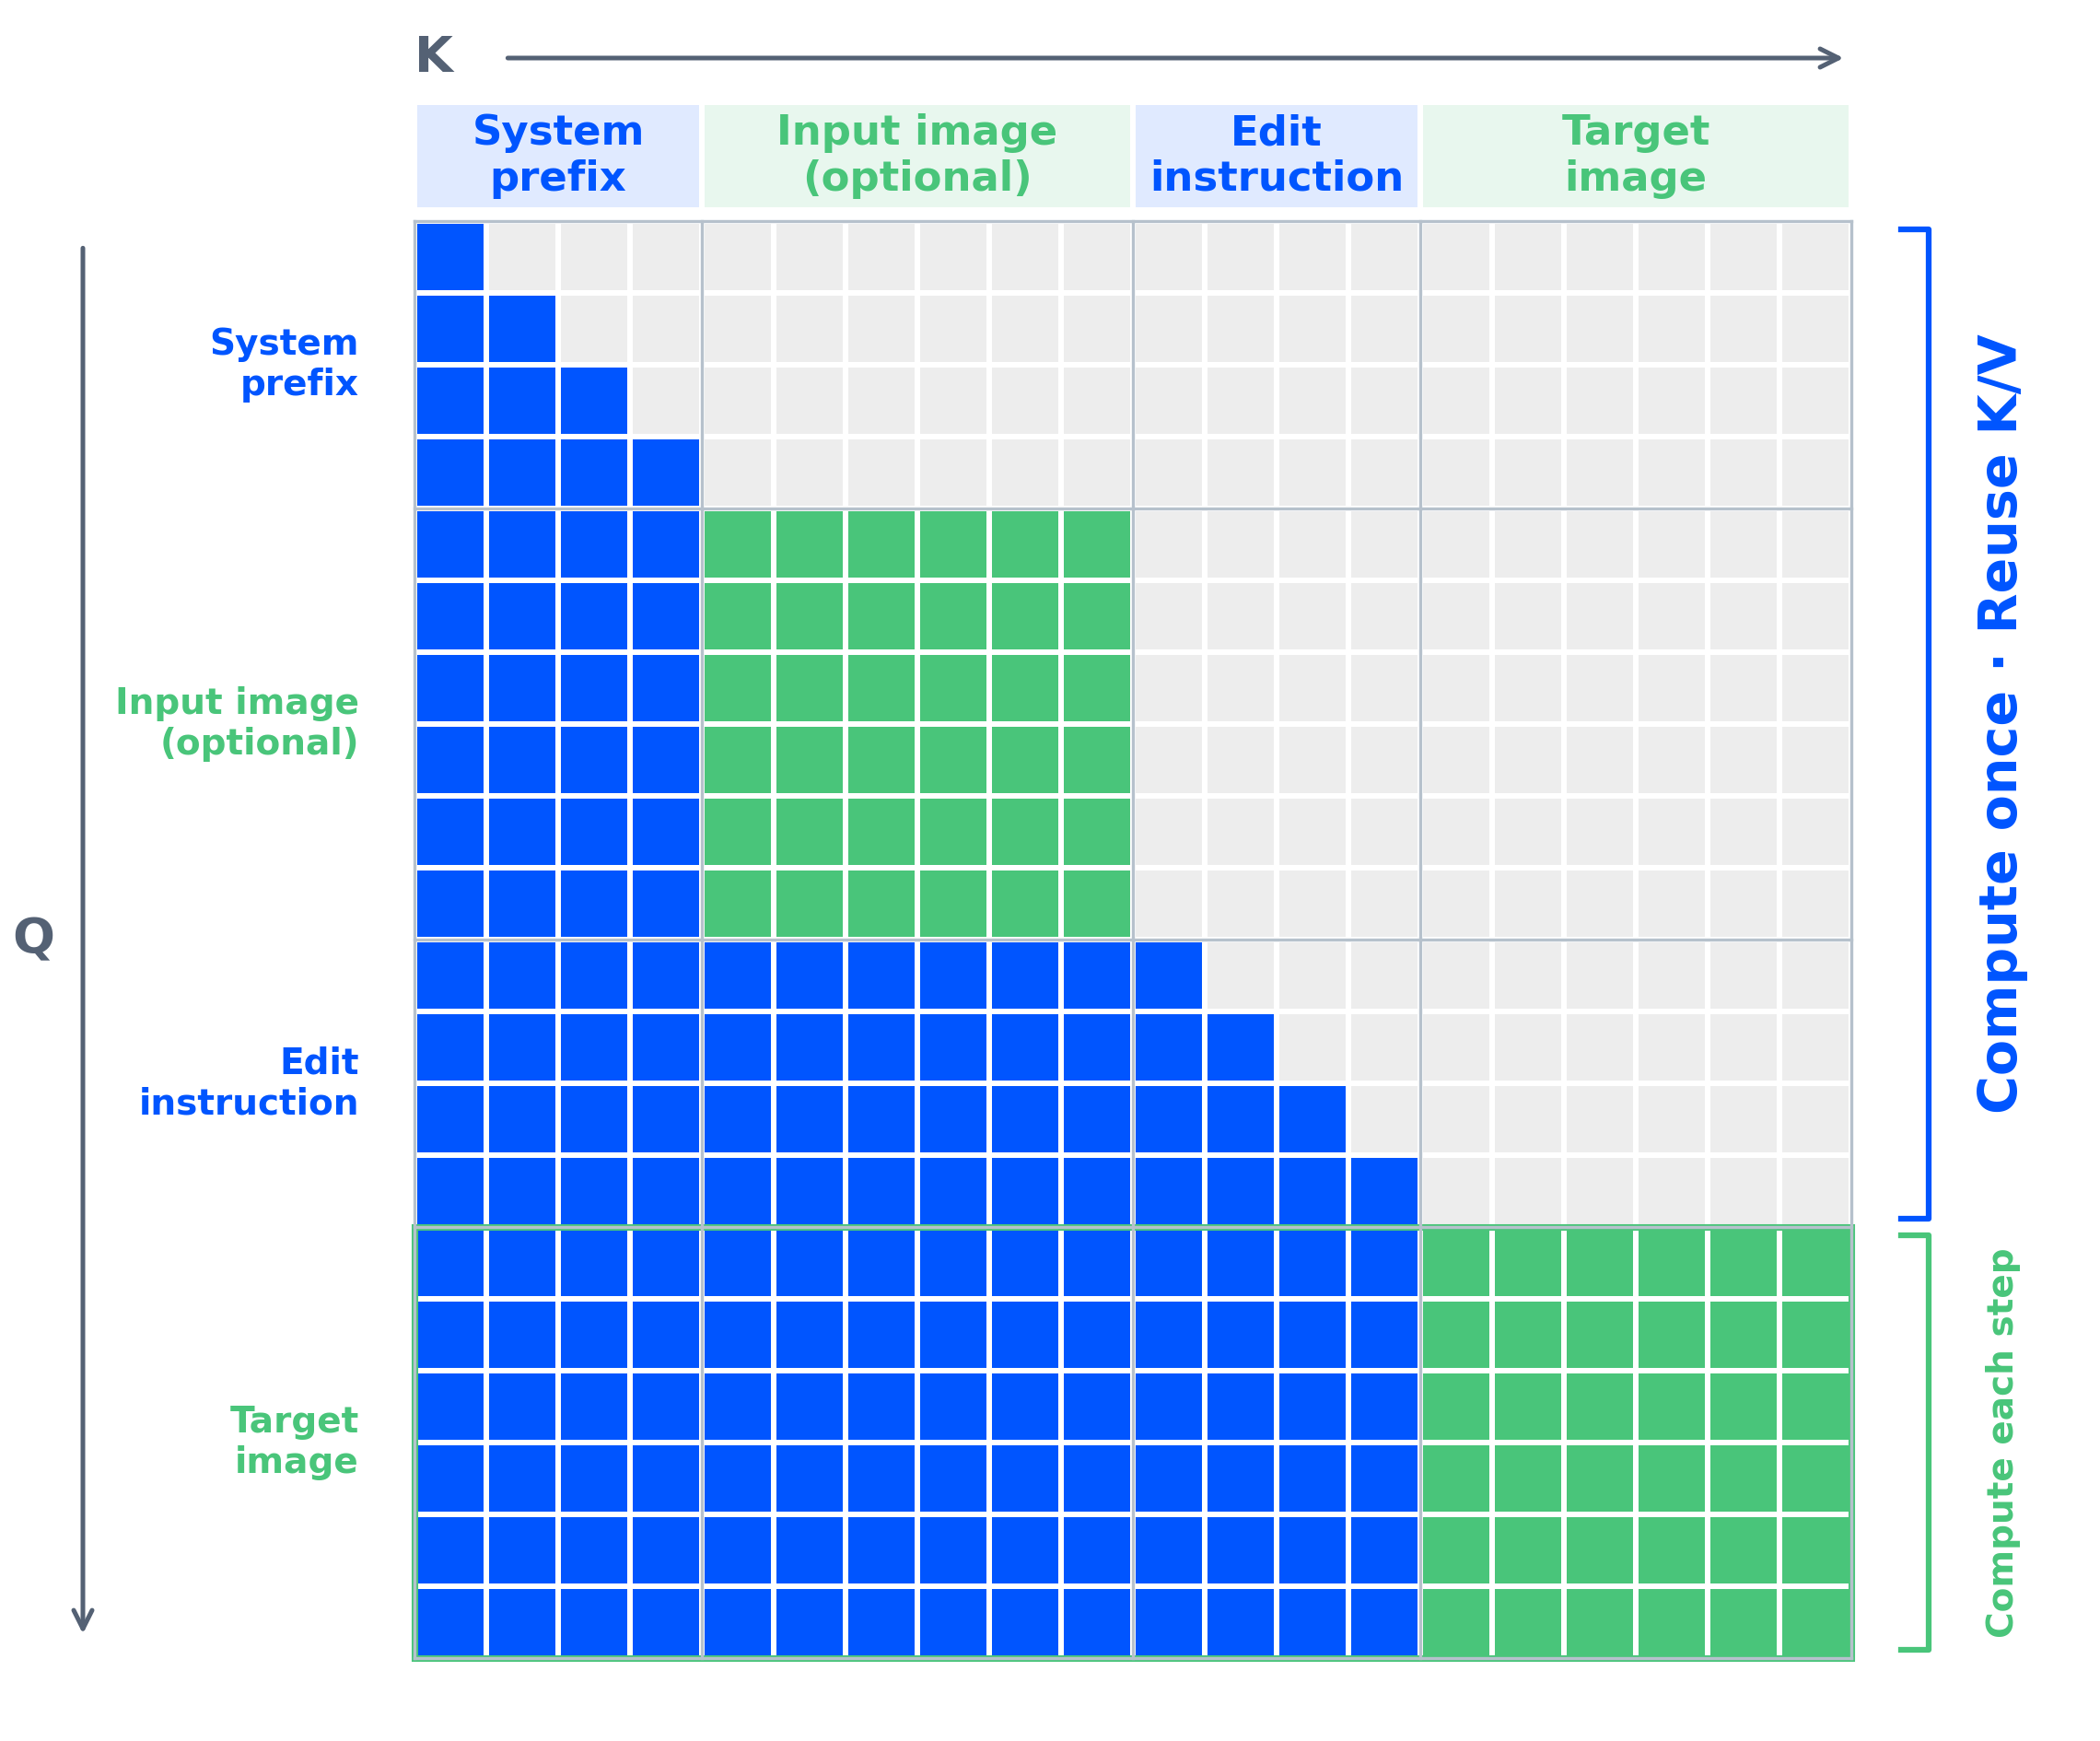
アーキテクチャの特徴は、mixed-granularity attentionとprefix key-value cacheの再利用だ。Qwenが示す仕組みでは、テキストと条件画像のprefixを最初の段階で計算し、その後のdenoisingステップで再利用できる。繰り返し計算を減らしながら、生成と編集をひとつのモデルで扱うことを目的としている。ただし、これはプロジェクト自身が示す設計説明であり、独立したベンチマーク結果ではない。実際の効率は利用するGPU、精度、バックエンド、入力条件によって変わるため、自分の環境で測定する必要がある。
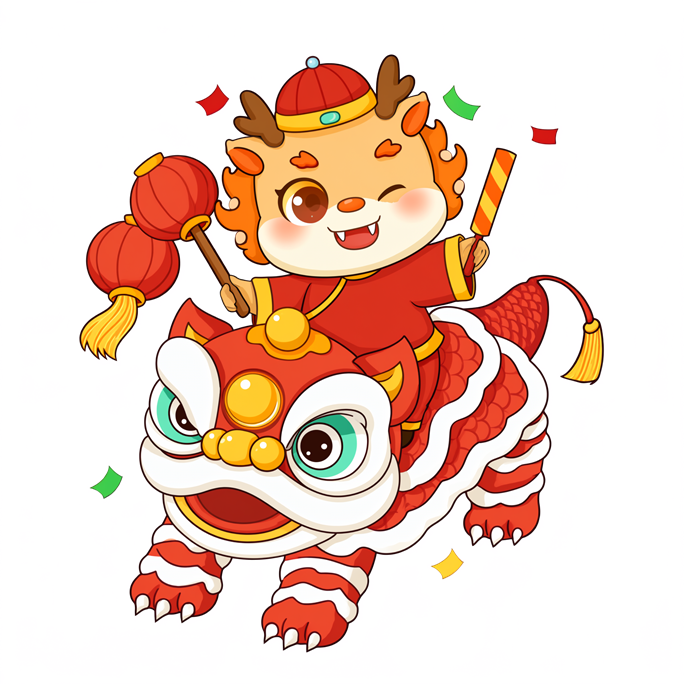
具体的な新機能のひとつがネイティブの透明画像だ。Image 2.1は通常の画像だけでなく、アルファチャンネルを持つRGBA画像も生成できる。透明レイヤの編集や写真からの被写体抽出も同じモデルで扱える。公式リポジトリには透明な背景を求めるプロンプトの例と、RGBA画像として保存する手順が示されている。切り抜き、ステッカー、合成、製品画像のように、透明部分を後処理用の別モデルに頼らず扱いたい作業に関係する機能だ。
透明な市松模様と切り抜きは、別の背景除去処理ではなく、直前の段落で説明したネイティブRGBA機能を示している。
編集機能は複数の参照画像にも対応する。公式資料は、複数の人物や対象を合成する際に最大10枚の参照画像を使えると説明している。局所的な変更は円、塗りつぶされた注釈、または別のマスクで指定でき、人物や製品の同一性を保つことを目指す。ここでいう同一性の保持は目標であり、すべての顔、服装、細部がどのような入力でも完全に保たれるという意味ではない。結果はプロンプト、参照画像、編集方法、入力画像の質に左右される。
表示された編集例は、直前で説明した編集ワークフローのように、局所的な指示で既存画像の一部を変更できることを示している。
Qwenは、文字の描写、人物の照明、細部の表現が改善されたとも説明している。モデルはネイティブ2K生成に対応し、正方形、4対3、3対4、3対2、2対3、16対9、9対16といった縦横比を推奨設定として挙げている。これは対応範囲と推奨構成を示す情報であって、あらゆる文字が必ず読める、またはartifactが出ないという保証ではない。公開された例は意図した用途を示すデモであり、実際の可読性は言語、書体、解像度、プロンプトごとに確認すべきだ。
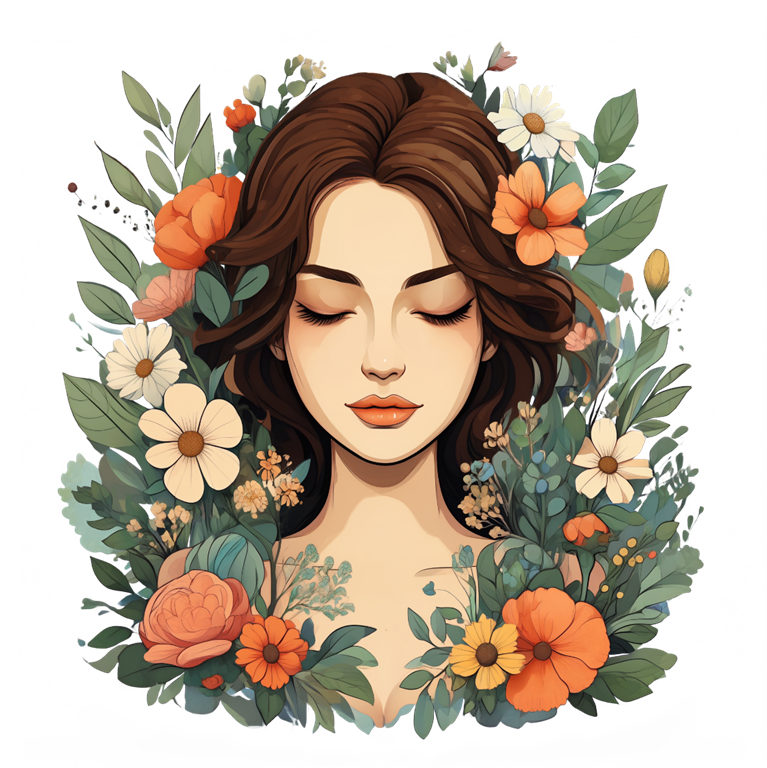
複数の対象を組み合わせた画像は、直前で説明した複数参照による合成機能を示すデモであり、品質を保証するものではない。
技術構成は70億パラメータのDiTだけではない。テキストエンコーダには、テキスト指示と条件画像を共通表現へ変換するQwen3-VL 8Bが使われる。VAEは64チャンネルのRGBAオートエンコーダで、空間方向に16分の1へ圧縮し、ネイティブ透明に対応する。schedulerには、Euler discrete schedulingとdynamic shiftingを組み合わせたFlow Matchingが使われる。これらの構成は、テキストと画像の両方を条件として受け取り、RGBまたはRGBAの結果を生成する仕組みを示している。ただし、個々の出力の品質をこれらの名称だけで決めることはできない。
長いプロンプトを整えたい利用者向けに、プロジェクトはQwen3.5-VL 9Bをfine-tuneしたprompt rewriting用のcheckpointも公開している。文書から画像を生成する用途と、画像を編集する用途にそれぞれひとつずつあり、Transformersを使ったローカル実行とvLLMサーバ経由の実行例が用意されている。出力には詳細なプロンプトと縦横比の選択が含まれる。これは必須の経路ではなく、短い指示を詳しくしたい場合の補助機能だ。画像パイプラインを直接呼ぶこともできる。
リリースにあわせて、複数の統合先も公表された。公式READMEは、DiffusersのQwenImage21Pipelineが初日から対応すると説明している。ComfyUIのネイティブ対応、vLLM-Omniによる高性能な推論、SGLang-Diffusionのネイティブ推論、LightX2Vによる高速化もリストに含まれる。モデルの重みはHugging FaceとModelScopeから入手できる。既存のツール経由で試しやすくなった一方、インストール要件、GPUメモリ、ソフトウェアのバージョン、OSの対応は別途確認が必要だ。
公式のquick startではPyTorch、Transformers、Diffusers、Accelerate、Pillowを使い、CUDA向けのpipelineを示している。またCPU offload、vLLMのオフライン推論、オンライン配信、SGLangのコマンド、FlagOSによる複数のaccelerator対応も説明されている。ローカル実験の選択肢が広いことは確かだが、すべての構成が同じ速度で動き、すべてのコンシューマGPUに収まるという意味ではない。選ぶback endのメモリ要件、精度、offload設定を事前に確認する必要がある。
ライセンスも重要な要素だ。リポジトリにはQwen Research License Agreementが適用され、Non-Commercialを研究または評価目的だけに限定している。このライセンスは非商用での利用、複製、配布、変更などを認める一方、商用利用には別途commercial licenseが必要だと定めている。再配布時には通知と帰属表示の条件があり、この素材を使って作成・改善したモデルにも追加の表示要件が含まれる。製品、有料サービス、商用導入を考えているなら、重みが公開されているという事実から利用許諾を推測せず、全文を確認して必要な許諾を得るべきだ。
Image 2.1の意義は二重にある。技術面では、比較的小さな70億パラメータの生成コンポーネントに、編集、透明画像、複数参照による合成、2K出力、推論ツール群をまとめた点だ。実用面では、有用性がback end、利用可能なハードウェア、プロンプトと参照画像の質、そして利用目的に合うライセンスに左右される点だ。公式リリースは試すべき機能を広く示している。同時に、研究用の実験と商用導入の境界を、ワークフローを組む前に理解しておく必要がある。