明示的な位置情報がなければ、自己注意(self-attention)メカニズムは「The red fox jumps over the gray fox」と「The gray fox jumps over the red fox」という文章を同一のものとして扱ってしまいます。なぜなら、単語「fox」は、その位置に関わらず同じ埋め込みベクトルを受け取ることになるからです。この問題を解決するために、GPT-2やMiniMax-M3のようなモデルは、トークンベクトルに位置固有のデータを注入し、Transformerが入力の構造的な順序を理解できるようにしています。
この視覚資料は、同一の単語が順序によってどのように意味が変わるかを示すことで、位置データの根本的な必要性を説明している。
絶対位置埋め込みのメカニズム
GPT-2のアーキテクチャでは、位置情報はトークン埋め込みとは別の独立したベクトルとして追加されます。モデルはトレーニング中に位置ベクトルのテーブルを学習し、位置mにある各トークンに対して、ベクトルP_mが選択され、トークンの埋め込みベクトルに要素ごとに加算されます。
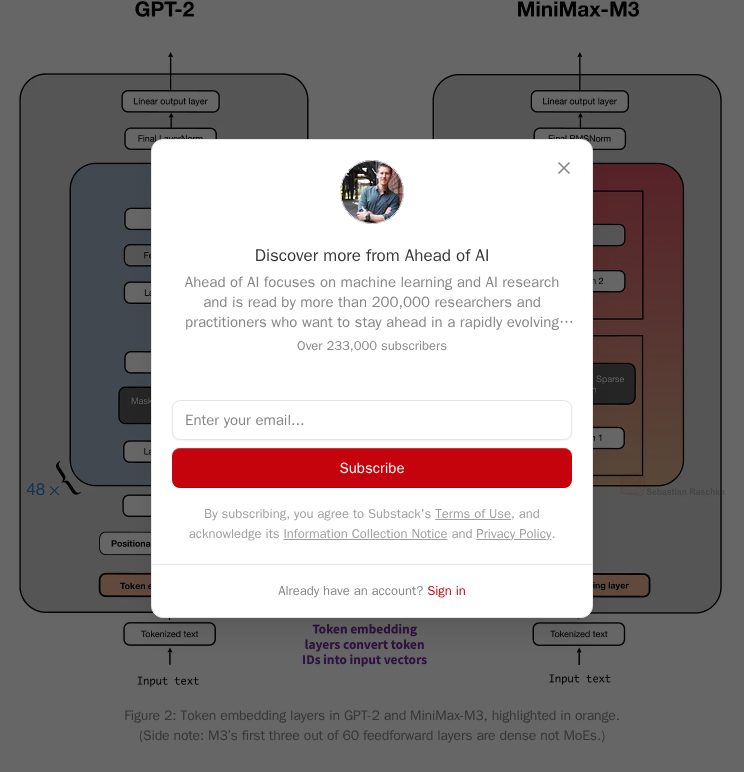
この図は、異なるモデルタイプにおける位置埋め込みの具体的なアーキテクチャ上の配置を説明している。
このアプローチにより、2つのトークンが同一(例:単語「fox」が2回出現)であっても、それらは異なる数値表現を持ってTransformerブロックに入力されることが保証されます。しかし、この手法は事前に定義された埋め込みテーブルのサイズによって制限され、このテーブルはトレーニング開始前に確立されている必要があります。
「それにもかかわらず、GPT-2やほとんどの新しいLLMに明示的な位置情報が含まれているのは、それが注意メカニズムに対して位置に関する直接的な信号を与えるためです。」
— Understanding Positional Embeddings in Modern LLMs
スケーリングの制限と相対的手法への移行
絶対位置埋め込みの大きなトレードオフの一つは、コンテキストウィンドウを拡張する際のコストです。GPT-2 Mediumでは、1,024トークンの制限において位置埋め込み層は重みのわずか0.30%を占めますが、同じコンテキストを100,000トークンに拡張すると、その割合はモデルの総重みの22%以上に増加します。
HN Digestによる図(magazine.sebastianraschka.com の報告数値に基づく)。数値はソースの表記通り。
これを回避するために、多くの現代的なモデルはRotary Positional Embeddings(RoPE)などの相対的位置埋め込みへと移行しています。絶対的な手法とは異なり、RoPEは注意メカニズムに直接位置情報を注入するため、モデルの重み数を膨らませることなく、長距離の依存関係をより効率的に処理することが可能になります。
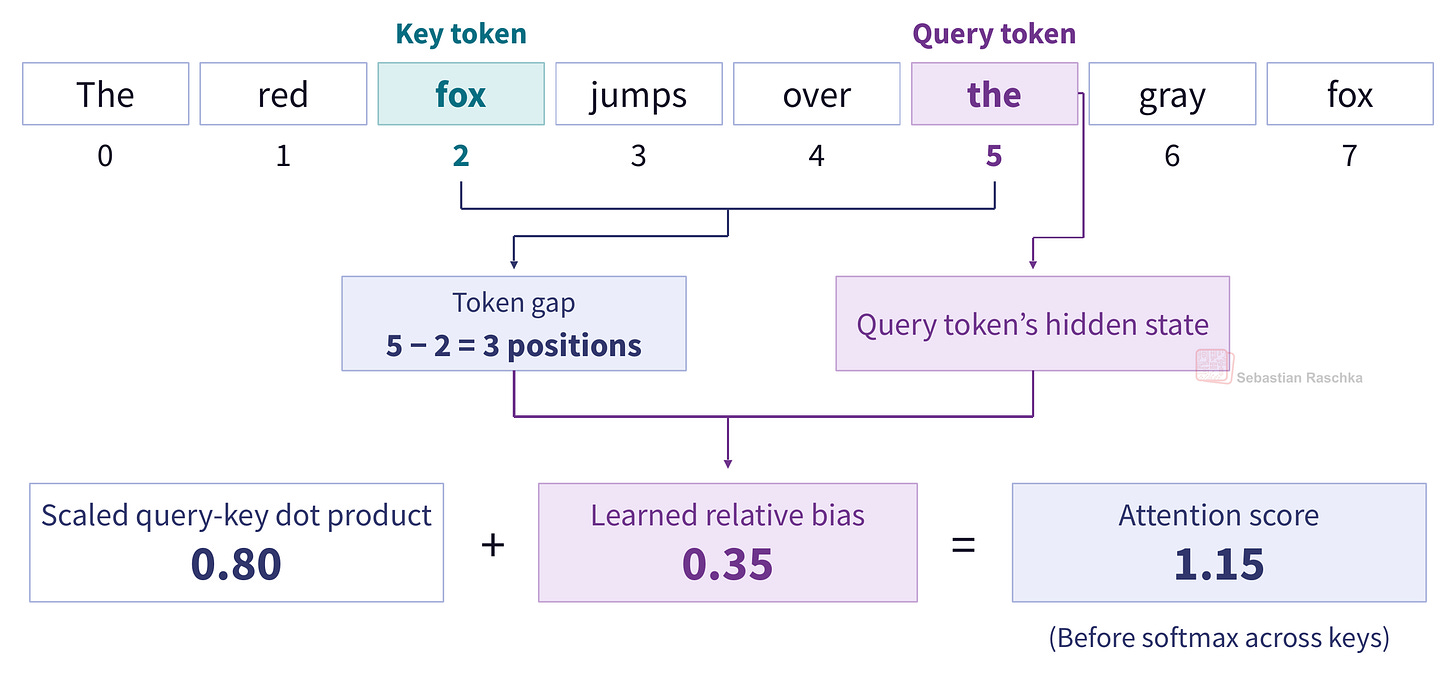
この画像は、RoPEのような相対的手法が注意メカニズム内でどのように機能するかという説明をサポートしている。
暗黙的な順序 vs 明示的な信号
自己回帰モデルにおける因果マスクは、現在のトークンが注目できる過去のトークンを制限することで、ある程度の暗黙的な順序を提供します。理論的には、これにより明示的な埋め込みがなくてもモデルは単語の順序を区別できるはずです。
それにもかかわらず、明示的な位置手法は依然として不可欠です。なぜなら、因果マスクは距離の感覚を提供しないからです。明示的な埋め込みは、モデルがトークンのすぐ隣にあるものと10つ離れた位置にあるものを区別するのに役立つ直接的な信号を提供し、この区別は一貫したテキスト生成において極めて重要です。