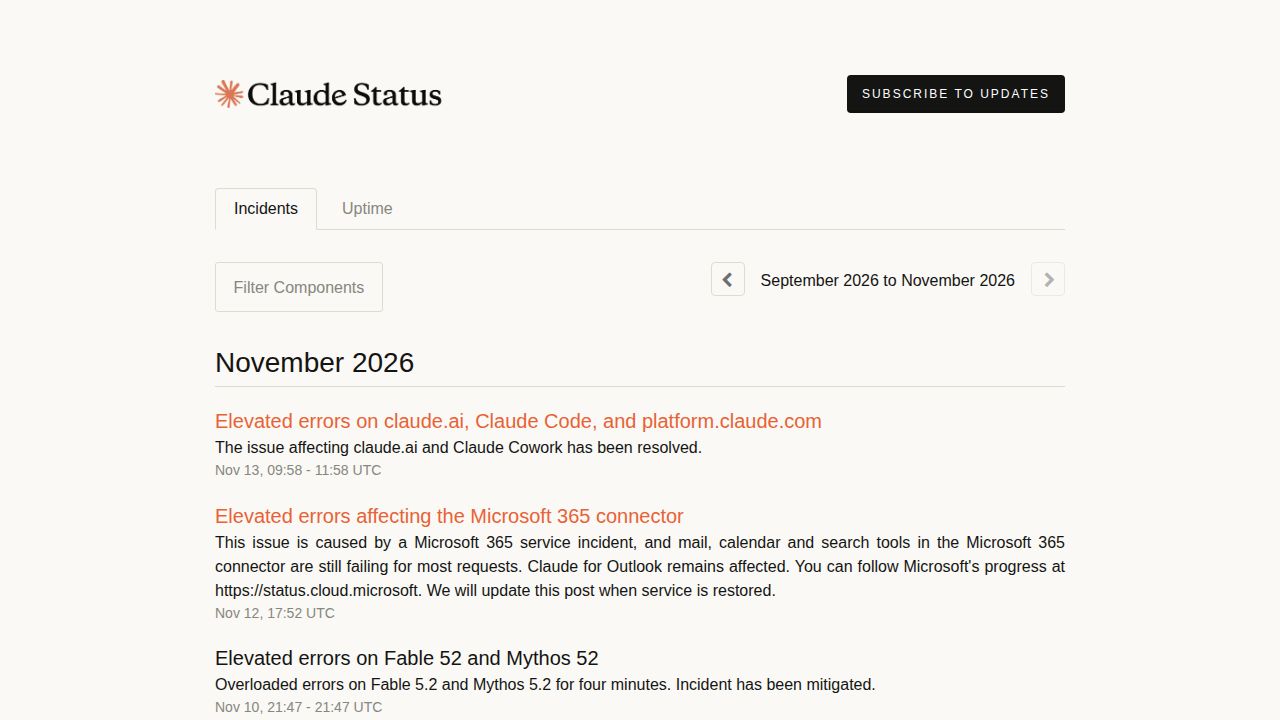
11月13日、AnthropicのClaudeサービスで障害が発生し、多くのユーザーが重要な業務の最中にプラットフォームへアクセスできなくなりました。一部のユーザーにとっては、ソースファイルの破損や、提出のわずか数分前になっても時間制限のあるプレゼンテーションを完成させられないといった、即座のプロジェクト中断を招く結果となりました。
報告された影響と解決策
投稿者(primary)によって提供されたステータス履歴によると、11月13日にClaudeサービスがダウンしていました。yodonと識別されるコメンターは、修正が09:58 UTCに公式に適用されたことを指摘しましたが、その時点以降も完全な復旧に向けた監視が続いたことを観察しました。
ダウンタイム中のユーザー体験は大きく異なりました。あるユーザー(biofox)は、残り39分でプレゼンテーションを仕上げている最中に強制終了されたと報告し、別のユーザー(rfgplk)は、修正したソースファイルでの進捗が失われ4つのプロジェクトが台無しになったため、この状況は容認できないと述べました。
障害を軽減するための戦略
この障害を受けて、複数のコメンターが単一のプロバイダーへの依存を避けるための技術的な戦略について議論しました。コメンターの一人であるmicwは、DeepSeek用のカスタムVS Code統合を、既存のCodexおよびClaudeのサブスクリプション、そしてOpenRouterアカウントと組み合わせた多様化戦略を詳しく説明しました。
他のユーザーは、信頼できるフォールバックとしてローカルモデルを維持することを提案しました。例えば、mark_l_watsonは、インターネットの信頼性が低い場合や主要なクラウドプロバイダーが利用できない場合でも機能を確保するために、qwen-3.8-flash-nextのような強力なローカルモデルを使用することを挙げました。
ベンダーロックインのリスク
この議論では、「ベンダーロックイン」とそれがプロフェッショナルなワークフローに及ぼす影響についてのより広範な懸念が浮き彫りになりました。コメンターたちは、サイバー攻撃やサービス障害の際に冗長性を確保するために、大企業はH100を搭載しオープンウェイトモデルを備えた内部サーバーを維持すべきかどうか疑問を投げかけました。
一部のユーザーは、このような障害がいかにAIの可用性がなければ生産がすぐに停滞するかを示していると懸念を表明した一方で(nicce)、AIは思考を置き換えるのではなく主に人間のアイデアを加速させるためのものであるため、基礎となるロジックがユーザーに属している限り、直接的な影響は管理可能な範囲に留まると主張する者もいました。