Muesliは、Apple Siliconハードウェアに特化した、ローカル優先のディクテーションおよび会議文字起こしを提供するネイティブmacOSアプリケーションです。デバイス上での処理を優先することで、音声データがクラウドで処理されることが多いGranola、WisprFlow、Littlebirdといったサービスに対するプライバシー重視の代替手段を提供することを目指しています。
プライバシー優先のアーキテクチャ
Muesliの核となる設計哲学は、データをローカルに保持することです。音声認識はデフォルトでユーザーのMac上で実行され、アプリはユーザーが特定のAI機能に明示的に同意した場合にのみ、ホストされたプロバイダーにコンテンツを送信します。
この画像は、ユーザーのプライバシーを確保するためにローカル優先の処理を優先するアプリケーションの核となる哲学を捉えています。
HN Digestによる図表(github.comの報告数値に基づく)。数値はソースの表記通り。
このアプリは、デバイス間でテキストとメタデータを同期するためにiCloudを使用しますが、音声ファイルを転送しないように設計されています。これにより、生の録音データは元のデバイスに残ったまま、処理されたテキストにアクセスできるようになります。
会議の文字起こしにおいて、アプリはマイクとシステムオーディオの両方をスピーカーラベル付きでキャプチャします。また、MP3、MP4、WAVなどの形式の既存ファイルをインポートして再文字起こしすることもサポートしています。
モデルの柔軟性とカスタマイズ
このアプリケーションは多様な文字起こしモデルをサポートしており、ユーザーはニーズに合わせて最適なものを選択できます。選択肢には、Apple Speech、Parakeet(Unified、v2、v3、Redux、Realtime EOU)、Nemotron 3.5、SenseVoiceが含まれます。
ユーザーは、個人辞書に専門用語、名前、置換ペアを追加することで、体験をカスタマイズすることもできます。この辞書はJSONファイルとしてインポートまたはエクスポートでき、アプリおよびコマンドラインインターフェース全体で使用できます。
特定のAIプロバイダーを好むユーザーのために、MuesliはOpenAI、Anthropic、OpenRouter、およびOllamaやLM Studioなどのローカル推論エンジンとの統合を可能にします。
会議管理とエージェント統合
単純な文字起こしを超えて、Muesliは会議をアクション可能な項目に変換するためのツールを提供します。会議を要約するためのテンプレートや、ユーザーが「@」記号を使用して特定の会議を添付し、履歴をクエリできる「Ask Meetings」ワークスペースが含まれています。
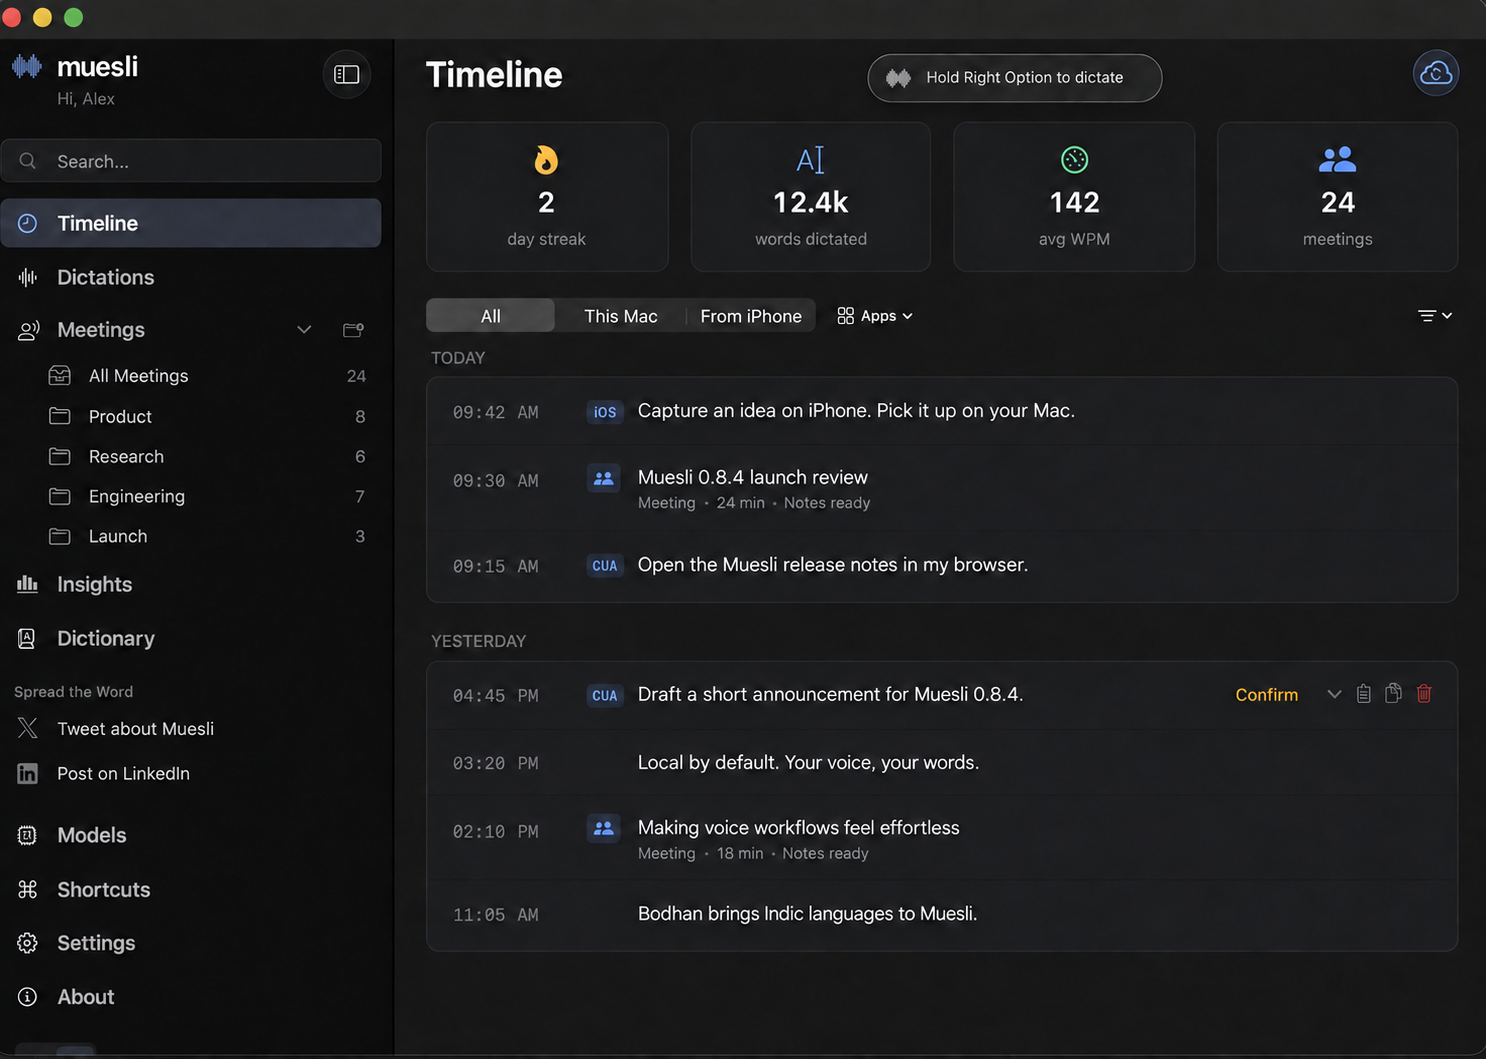
この画像はMuesliアプリケーションの主要なユーザーインターフェースを例示しており、ユーザーが保存された文字起こしや会議フォルダとどのように対話するかを示しています。
このプロジェクトには、Claude CodeやCodexなどのコーディングエージェントと連携するコマンドラインインターフェース(CLI)も含まれています。これにより、ローカルシェルへのアクセス権を持つエージェントが文字起こしを分析し、会議の検索やファイルの文字起こしなどのタスクを直接実行できるようになります。
「Time Turner」のような実験的機能では、ユーザーはテキストまたはアプリによってローカルのスクリーン履歴を検索でき、「Cotypist」はユーザーの入力ソースに基づいてデバイス上でインラインの執筆提案を提供します。
ハードウェア要件と制限
Muesliは、macOS 14.2以降を実行するApple Silicon搭載のMacを必要とします。多くのモデルがローカルで実行されるため、アプリは録音が始まる前にモデルの準備状況を示す進行状況インジケーターを提供します。
ローカル処理はプライバシーを向上させますが、リソースを大量に消費する場合があります。「Ask Meetings」チャットや特定の要約ステップなどの一部の機能は、選択したモデルによってはシステムリソースを大幅に消費する可能性があります。
ソースには、Muesliのローカルモデルの正確性やレイテンシをクラウドベースの競合製品と比較した具体的なパフォーマンスベンチマークは提供されておらず、ローカルのプライバシーとクラウドのパフォーマンスの間のトレードオフはユーザー自身で定義する選択となります。
技術スタック
このアプリケーションは、Swift、AppKit、およびSwiftUIを使用して構築されています。ローカル推論には、CoreML、Apple Neural Engine、MLX Swift、llama.cppを含む様々なランタイムを利用しています。
オーディオ処理はCoreAudioプロセスタップとScreenCaptureKitを介して処理され、音声活動の検出と話者の識別にはSilero VADとpyannoteのダイアリゼーションが使用されています。
Hacker Newsの読者の反応
- 技術的な指摘: あるコメント投稿者は、すべてをゼロから構築する負担を避けるためにRealtimeSTTのようなより成熟した基盤を再利用することを検討しつつ、非Apple Siliconハードウェアのサポートの価値についても指摘しました。 コメント ↗
- 技術的な指摘: 同様のツールを構築したユーザーは、通話内にボットがない状態でメモをダイアリゼーションすることの難しさを共有し、開発者がその特定の問題を解決したかどうかを尋ねました。 コメント ↗
- 懐疑的: あるコメント投稿者は、このカテゴリーに非常に多くの類似アプリが存在することの必要性に疑問を呈し、文字起こしと要約の単純なワークフローで十分である可能性を示唆しました。 コメント ↗
- 技術的な指摘: あるコメント投稿者は、ローカルシステムリソースを節約するために、ローカルの事後処理をスキップしたり、要約を外部サービスにオフロードしたりする機能を求める意向を表明しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗