Huaweiの新しいMACaQツールは、わずか32.5 GBのデバイスメモリを使用して、巨大な122Bパラメータのモデルをわずか64分で量子化できます。この開発は、ローカルAI推論における重要なボトルネック、すなわち、品質を大幅に損なうことなくコンシューマー向けハードウェアで実行可能な形式に大規模モデルを圧縮するために必要な時間とハードウェアリソースの問題に対処するものです。
マルチモーダル量子化機能
MACaQはモデルに依存しない(model-agnostic)量子化フレームワークとして設計されており、特定のアーキテクチャに制限されることなく、さまざまな種類のAIモデルに適用できます。テキスト生成、Diffusersを介した画像およびビデオ生成、そしてPyTorchを介した音声生成をサポートしています。
このバナーは、モデルに依存しない量子化ツールとしてのMACaQフレームワークの主な目的を表しています。
このツールは、異なるバックエンド向けの特定のワークフローを提供します。例えば、llama.cpp向けの2ビット、3ビット、4ビットGGUF形式や、vLLMおよびPyTorchベースの音声モデル向けのW4A4(4ビット重みおよび4ビット活性化)をサポートしています。
効率性とパフォーマンスのベンチマーク
MACaQの主な利点はそのスピードです。開発者は、競合手法よりも11倍少ない量子化時間を必要としながら、Llama-3-8Bの最高のパープレキシティに匹敵できると主張しています。この効率性は、圧縮モデルを迅速に反復試行する必要がある研究者や開発者にとって極めて重要です。
Qwen3.6-35B-A3Bモデルを用いたテストでは、MACaQ-R(洗練手法)はFP16に対して0.013367のKLダイバージェンスを達成し、0.015731を記録したUnsloth UD-Q4_K_XL手法を上回りました。KLダイバージェンスが低いほど、元のモデルの重みの再構成品質が高いことを示します。
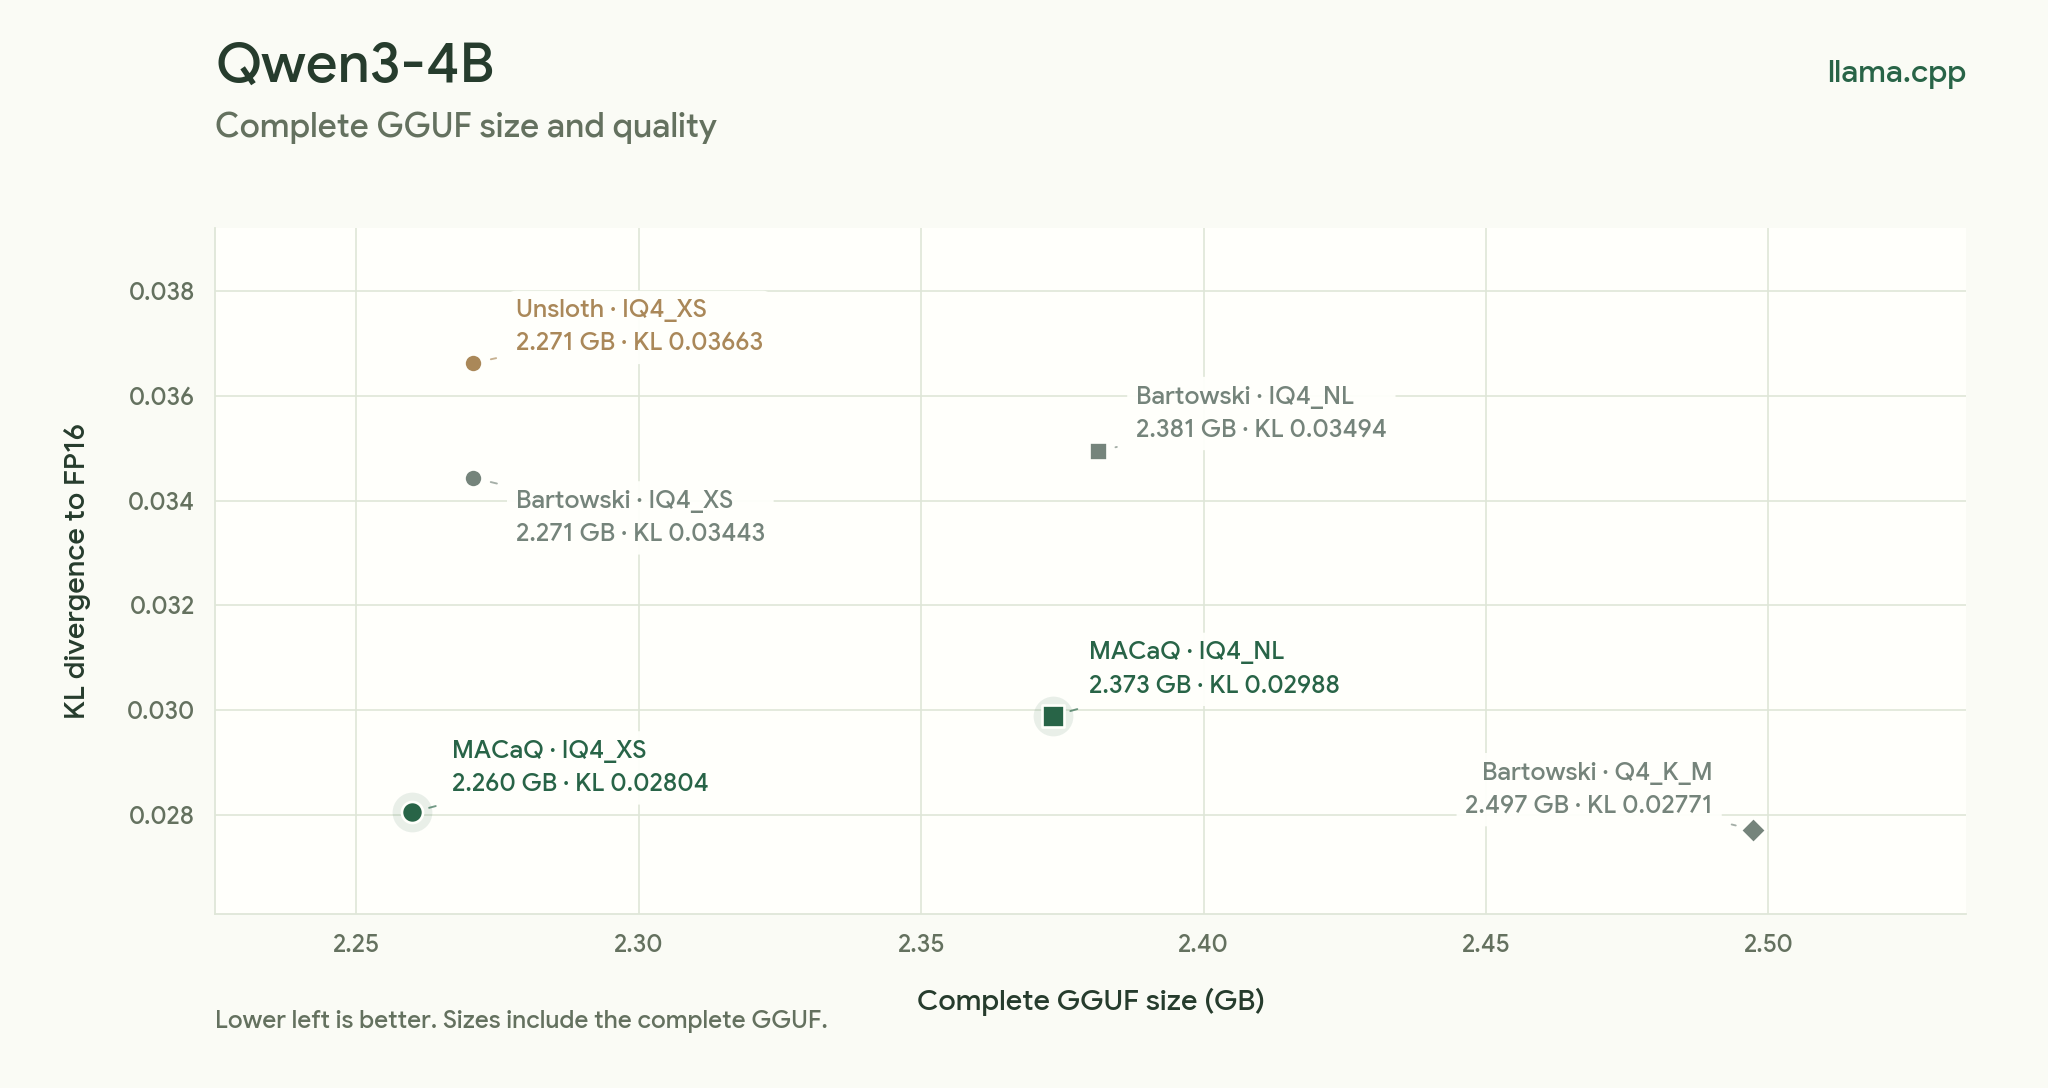
このチャートは、パフォーマンスベンチマークで言及されたモデルサイズと再構成品質(KLダイバージェンス)の視覚的な比較を提供します。
推論のトレードオフとハードウェア統合
MACaQは推論速度を大幅に向上させますが、精度には測定可能なトレードオフがあります。Qwen3.8-27Bモデルにおいて、BF16からMACaQ W4A4精度に移行したところ、パープレキシティは2.8463から2.8994へとわずかに上昇しましたが、これはデコード速度の大幅な向上によって相殺されました。
HuaweiのAscendハードウェアを使用するユーザー向けに、このプロジェクトはCANNプルリクエストを通じて特定の高密度およびグループ化されたmatmulカーネルを提供します。これにより、特殊なNPU(Neural Processing Unit)アーキテクチャ上で量子化のメリットを最大限に活用できるようになります。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、ナビゲーションが容易でコードに直接アクセスできるため、公式製品ページよりもGitHubを使用することを好むと述べています。 コメント ↗
- 懐疑的: 別のユーザーは、Huawei製品のサードパーティによるホスティングの信頼性に懸念を表明し、中国国外のプラットフォーム上のコンテンツはいつでも削除される可能性があることを示唆しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗