Apple M1システムで実施されたベンチマークでは、blqsortアルゴリズムは5,000万個のランダムなdouble型データを0.68秒でソートし、1.33秒を要した標準C++ライブラリのstd::sortを上回りました。この性能向上は、CPUパイプラインのストールを最小限に抑え、汎用的なソート実装よりも特定のデータ分布を効率的に処理するように設計された一連の最適化によるものです。
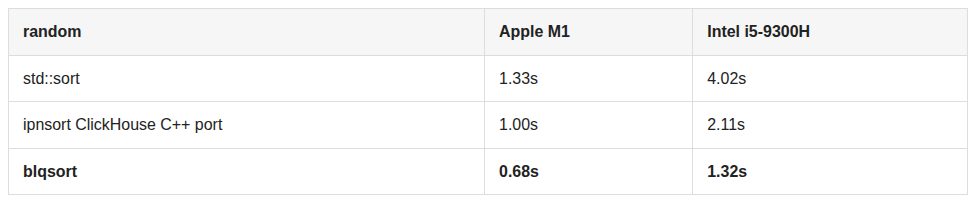
このテーブルは、導入部で言及された性能向上の実証的な証拠を提供します。
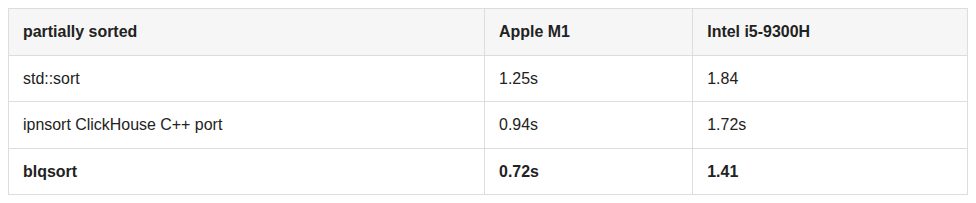
この視覚資料は、blqsortが異なるデータ分布やサイズをどのように処理するかについての議論をサポートします。
ブランチ予測ミスの排除
標準的なquicksortの実装は、データのパーティショニングに「if」条件を依存することがよくあります。現代のCPUにおいて、データがランダムに分布している場合、これらの条件はブランチ予測器にとって予測不可能となり、プロセッサはパイプラインをフラッシュして実行を再開せざるを得なくなります。
blqsortはブランチレスなアプローチを用いることでこの問題に対処します。条件付きジャンプの代わりに、条件付きインクリメント命令を使用して要素を移動させます。これにより、すべての要素に対して無条件のメモリ書き込みが発生しますが、著者は書き込みのオーバーヘッドは、頻繁なブランチ予測ミスによって引き起こされる性能損失よりも大幅に低いと指摘しています。
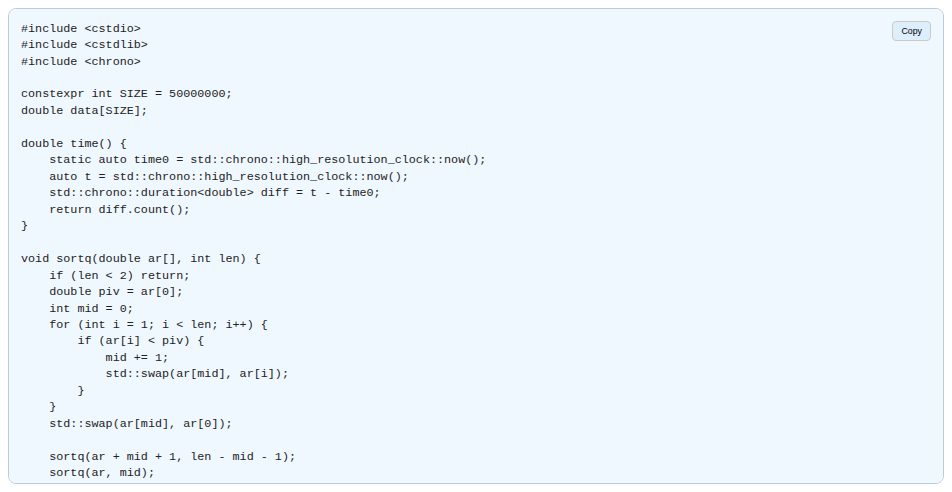
このコードスニペットは、標準的な条件付きロジックから最適化されたblqsort構造への移行を例示しています。
「blqsortの主要なコンセプトは、ブランチレス・パーティショニング、小さなパーティションのためのソートネットワーク、そして優れたピボット選択です。」
— A Fast Quicksort
小さなパーティションのためのソートネットワーク
20要素未満のような非常に小さなパーティションでは、従来のquicksortはより単純な手法よりも効率が悪くなります。blqsortはこれらをソートネットワークに置き換えます。これは、固定された比較とスワップのシーケンスを使用して要素を整列させるものです。
この実装には、最大16までのパーティションサイズに対する特定のロジックが含まれています。これらのネットワークを使用することで、アルゴリズムは再帰呼び出しのオーバーヘッドを回避し、ソートプロセスの「ベースケース」に対して高度に最適化されたパスを提供します。
ピボット選択とエッジケースの処理
異なるデータ型にわたって高いパフォーマンスを維持するために、blqsortはマルチステップのピボット選択プロセスを採用しています。パーティションからいくつかの中央値を決定して最終的な中央値を算出することで、パーティショニングステップ中にデータがより均等に分布されることを保証します。
このアルゴリズムには、困難な入力に対するセーフガードも含まれています。データ分布が不均一なまま(多くの場合、同一の要素が多数存在する場合)であれば、システムはヒープソートに切り替わります。さらに、効率を維持するために重複するキーを特定してグループ化します。
パフォーマンスのトレードオフと制限
blqsortの速度に対する主なトレードオフは、ブランチレスロジックの使用です。これにより、条件が満たされない場合でもコンパイラはメモリへの書き込みを実行する必要があります。コンパイラは、そのような書き込みが割り当てられたバッファに対して安全であることを保証できないため、これを条件付きの書き込みへと自動的に最適化することはできません。
blqsortはランダムなデータにおいてstd::sortを上回りますが、その相対的な優位性はアーキテクチャによって異なります。例えば、x86システムでは、blqsortとstd::sortの性能差は約10%であることが観察されました。
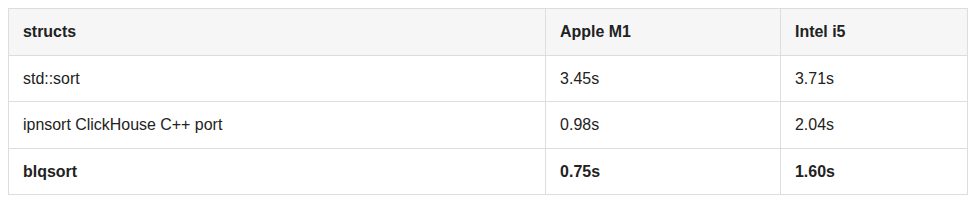
このテーブルは、最終セクションで議論されている性能のトレードオフとアーキテクチャによる差異を例示しています。
HN Digestによる図表(tiki.liの報告数値に基づく)。数値はソースの表記通り。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、ラディックスソートは優れた参照局所性を持ちながらデータに対して単純なスキャンを実行するため、特定の順序付けにおいて非常に高速になる可能性があると示唆しました。 コメント ↗
- 懐疑的: 別のコメント投稿者は、多くの問題において入出力操作がソートアルゴリズム自体よりも実行時間を支配するため、性能向上については懐疑的な見解を表明しました。 コメント ↗
- 技術的な指摘: また別のユーザーは、quicksortの効率は主にO(log n)の空間要件によるものであり、マージソートのようなアルゴリズムとは区別される点であると指摘しました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗