Unslothは、モデルのフットプリントを増やすことなく、主要なベンチマークにおいてQwen3.8-27Bモデルの精度を5〜10%向上させる新しいDynamic V3.1量子化アルゴリズムをリリースしました。このアップデートは特に2ビットから6ビットの量子化範囲を対象としており、ビジョン、推論、エージェンティックなコーディングタスクのために高密度モデルをローカルで実行するユーザーに高性能なオプションを提供します。
Dynamic V3.1による精度向上
Dynamic V3.1のアップデートは、ビジョンと推論機能を備えた高密度モデルであるQwen3.8-27Bモデルにおいて、大幅な精度の飛躍をもたらします。Unslothの報告によると、これらの改善はLiveCodeBench v6、GPQA Diamond、MMLU-Proを含むほとんどのベンチマークにおいて一貫しています。

この記事では、Unsloth Desktopインターフェースを通じてアクセス可能なQwen3.8-27Bモデルのビジョンおよび推論機能について論じています。
2ビットから6ビットのほとんどの量子化が更新されましたが、Unslothは3ビットUD3量子化をそのまま維持することを選択しました。これは、新しいV3.1アルゴリズムと同等の性能を発揮したためです。このアップデートは、エージェンティックなベンチマーク用に256Kのコンテキスト長、一般的なベンチマーク用に128Kのコンテキスト長を使用して検証されました。
「Qwen3.8-27B GGUFsは現在Unsloth Dynamic V3.1を使用しており、Terminal Bench、DeepSWE、およびその他のベンチマークを含む平均精度を、同等のサイズで5〜10%向上させています。」
— Qwen3.8 - How to Run Locally | Unsloth Documentation
エージェンティックなワークロードのための最適化
純粋な精度を超えて、新しい量子化はCodexのようなエージェンティックなツール向けに最適化されています。これらには開発者ロールのサポートやネストされたオブジェクトの改善されたパースが含まれており、複雑なタスク中にツールがより頻繁に成功するのを助けます。

アップデートには、複雑なタスク中にエージェンティックなツールが成功するのを助けるためのネストされたオブジェクトの改善されたパースが含まれています。
これらのモデルは、より高速な推論を促進するためにMulti-Token Prediction(MTP)もサポートしています。高速な推論を必要とするユーザー向けに、Qwen3.8-27Bモデルは、精度と速度のバランスをとるために、xhigh、medium、low、またはnoneの異なる推論努力(reasoning efforts)をサポートしています。
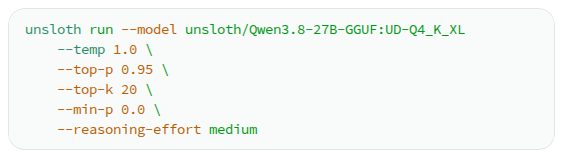
この記事では、新しい量子化がエージェンティックなツールと高性能な推論に最適化されていることに言及しています。
ハードウェア要件とトレードオフ
これらのモデルをローカルで実行するには、選択した量子化レベルに応じて特定のハードウェアのトレードオフが発生します。例えば、4ビット量子化は、RTX 5080や24GBのユニファイドメモリを備えたMacなど、16〜19GBのVRAMセットアップで動作するように設計されています。
HN Digestによる図表(unsloth.aiの報告数値を基に作成)。数値はソースの表記通り。
最大性能を得るために、UnslothはBF16チェックポイントよりも約1.5倍高速に動作するNVFP4量子化をリリースしました。ただし、これらの特定の量子化で公表されたスピードアップを実現するには、RTX 50XシリーズなどのNVIDIA Blackwell GPUが必要です。
ベンチマークの不一致
Unslothは外部ベンチマークにおける不一致、特にLiveCodeBenchに関するGSQ-RCOの結果について言及しました。彼らは、一部の報告では自社の量子化の性能が劣っていると示唆されていたものの、それらのテストは恐らく96Kのコンテキスト予算を使用していたと指摘しました。
Unslothのテストでは128Kのコンテキスト予算を使用しており、そこでは彼らのUD3量子化が競合を上回りました。また、GPUの非決定性を考慮すると、信頼できる結果を確保するためにベンチマークを複数回実行する必要があるとも述べています。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、Unslothは既製品のモデルに広く適用可能である一方で、Bonsai 2はより小さなサイズにより多くのパラメータを詰め込むための追加のチューニングを提供していると指摘しました。 コメント ↗
- 体験談: あるユーザーは、M4 Mac miniでモデルを正常に実行し、ローカルでの使用に許容できる速度を達成したと報告しました。 コメント ↗
- 体験談: あるコメント投稿者は、CPUのみのモードで27Bモデルを実行した経験を共有し、非常に低速ではあったものの、一晩かけて大きなファイルを処理することができたと述べています。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗