大量のAIワークロードを実行する組織は、ホスト型APIからセルフホストモデルに移行することで、コストを約80%削減できます。この変化は、従来のプラットフォームエンジニアリングを、推論エンジニアリングという専門的な分野へと変貌させています。この移行は、データのプライバシー、低レイテンシ、そしてDeepSeekのR1のように数学やコーディングのベンチマークでフロンティアモデルに匹敵する性能を持つオープンモデルの進化によって推進されています。
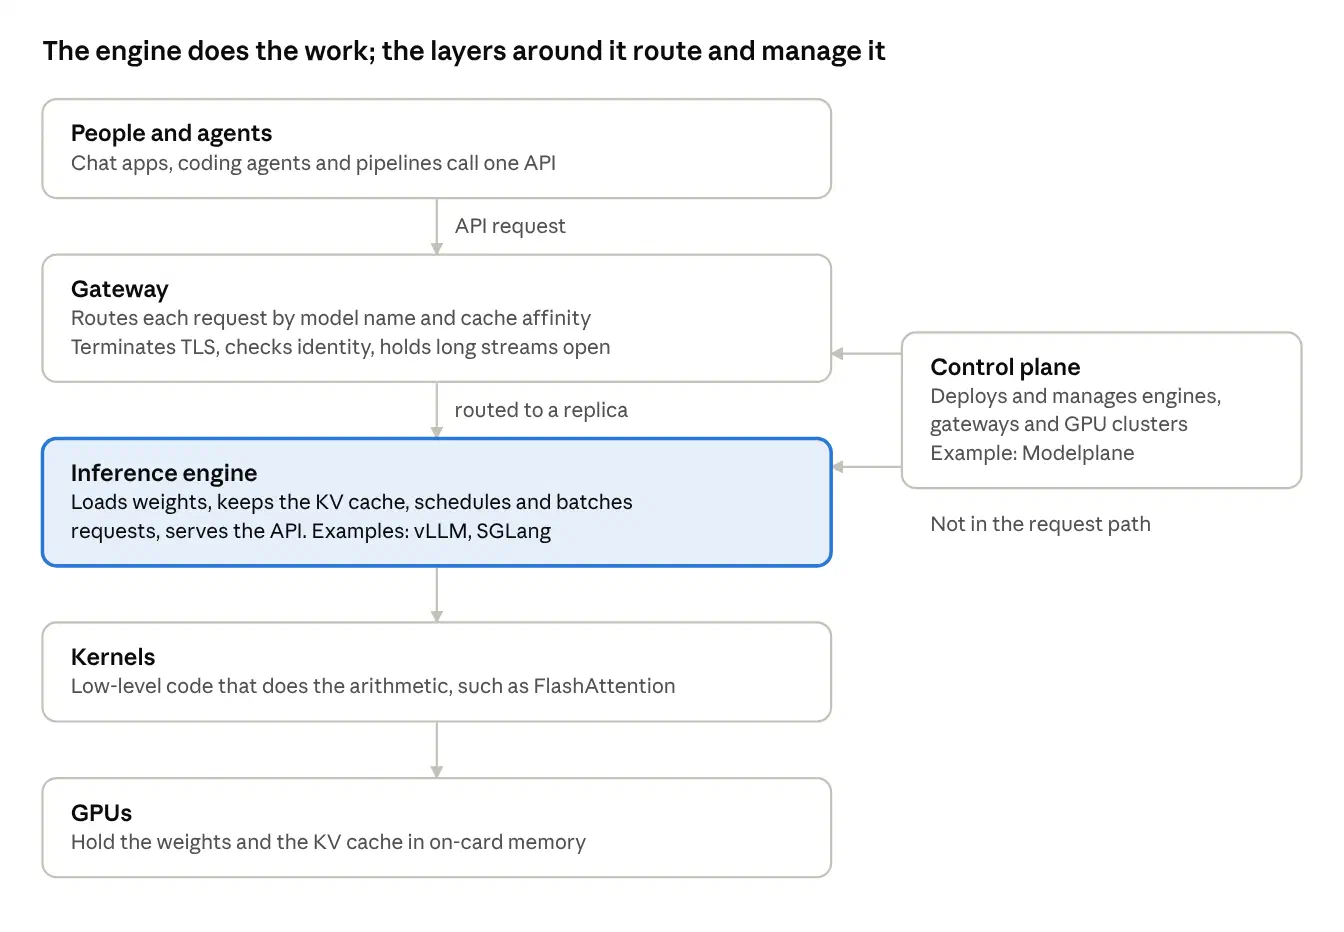
この図は、エンジニアリング原則のリストで言及されている推論スタックの4層アーキテクチャを説明しています。
セルフホストへの移行
組織がソースコードや機密データを保護するためにモデルを内部で実行しようとする中で、プラットフォームチームはますます推論チームへと変化しています。初期の製品開発にはホスト型APIで十分なことが多いものの、モデルの請求額が増大し、Hugging Face上で200万件以上存在するオープンモデルがクローズドシステムに対して競争力を持ち始めたことで、セルフホストの方が実用的になってきています。
HN Digestによる図(docs.modelplane.aiの報告数値に基づく。数値はソースの表記通り)
推論エンジニアリングの主な目標は、これらのモデルのライフサイクルを管理することです。つまり、適切なハードウェアの選択、GPUメモリの最適化、そして高可用性の確保です。この作業は標準的なインフラ管理とは異なり、AI機能の価格低下は、単なるGPUハードウェアの改善よりも、モデルがどのようにサービングされるかの改善によって主に引き起こされているためです。
この視覚資料は、モデルのライフサイクルとハードウェアの最適化を管理する推論スタックのコントロールプレーンレイヤーを表しています。
「一定レベルのAI機能の価格は、年間で約10倍低下しており、その大部分はGPUの改善ではなく、モデルのサービング方法によるものです」
— modelplane/docs/content/guides/inference-guide.md at release-0.7 · modelplaneai/modelplane
推論エンジンのメカニズム
vLLMやSGLangのような推論エンジンは、GPUを接続したステートフルなデータベースサーバーのように機能します。起動時にモデルの重みをGPUメモリにロードします(このプロセスには数分かかる場合があります)。そして、進行中のすべての会話に対してKV(Key-Value)キャッシュを維持します。システムRAMを使用する標準的なデータベースとは異なり、推論エンジンは、高価で限られたGPUメモリ内にワーキングセットを保持する必要があります。
KVキャッシュは、会話内のすべてのトークンに対するアテンションのキーと値を保存し、履歴の再計算を避けるための重要なコンポーネントです。Llama 3 70Bのようなモデルでは、単一の128Kトークンの会話で約40GBのキャッシュが必要になることがあり、これが単一のGPUでどれだけの同時ユーザーを処理できるかという際の主要なボトルネックになることがよくあります。
パフォーマンスのボトルネックとトレードオフ
モデルのリクエストは、相反するボトルネックを持つ2つのフェーズで実行されます。「prefill」フェーズは入力全体を並列で読み取るため計算能力に制限され、「decode」フェーズはトークンを一つずつ生成するためメモリ帯域幅に制限されます。これらのフェーズは異なるハードウェアの制限によって制約されるため、最初のトークンの速度(TTFT)を向上させる最適化が、その後のトークンの速度(秒あたりのトークン数)にほとんど影響を与えない場合があります。
エンジニアはレイテンシとスループットの間のトレードオフのバランスを取らなければなりません。より多くのリクエストをバッチ処理すると、秒間処理される総トークン数(スループット)は増加しますが、個々のユーザーの応答時間(レイテンシ)は遅くなります。これは、データベースのチューニングにおけるトランザクション処理と分析クエリの間の古典的なトレードオフを反映しています。
Hacker Newsの読者の反応
- 体験談: あるコメント投稿者は、エージェントを使用して手動でクラスターサービングスタックを構築した経験を共有し、カーネルキャッシュの再利用やエンジンのバグ修正といった複雑なタスクを処理できたと述べています。 コメント ↗
- 懐疑的: 別の読者は、このガイドにはプラットフォームエンジニアに必要な基礎知識が欠けている可能性があると懸念を表明し、この役割にはTransformerアーキテクチャとKVキャッシュの内部構造に関する深い理解が不可欠であると示唆しています。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗