AMDのZen 6アーキテクチャは、VNNIユニットの数を1サイクルあたり4つに倍増させ、単一のスレッドがコアのデコードクラスターの両方を利用できるようにすることで、Zen 5からの世代的な向上を実現しています。これらの変更は、新しい「Zen 6c」バリアントと組み合わされることで、同じコアを単に異なる密度にスケールさせるのではなく、異なるワークロードの挙動に合わせてコア設計を専門化するというAMDの戦略の転換を示唆しています。
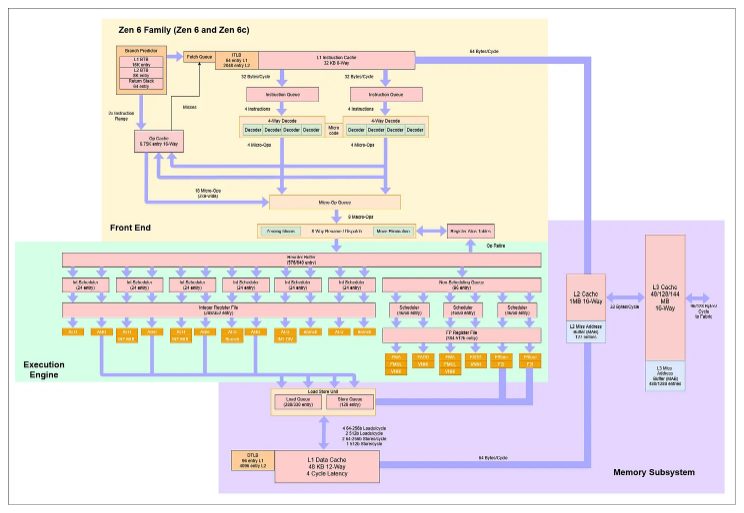
この図は、Zen 6アーキテクチャとそのコア設計哲学のハイレベルな概要を提供します。
フロントエンドとブランチ予測の改善
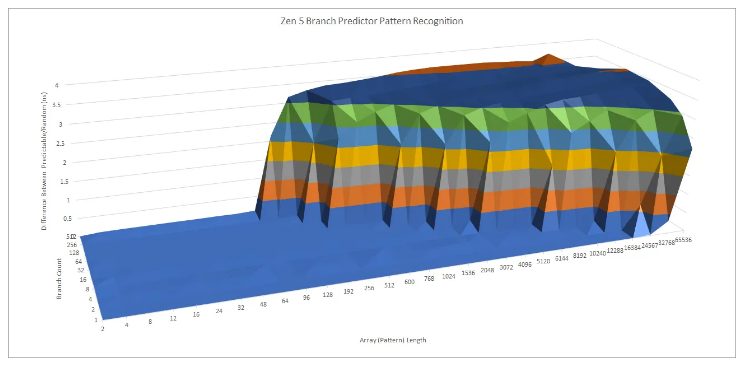
Zen 6はZen 5の方向予測をベースとしていますが、予測ミスからの回復能力を向上させています。Zen 5が誤った予測から回復するのに約3.5〜4 nsを要していたのに対し、Zen 6はこのペナルティを3〜3.5 nsに短縮します。
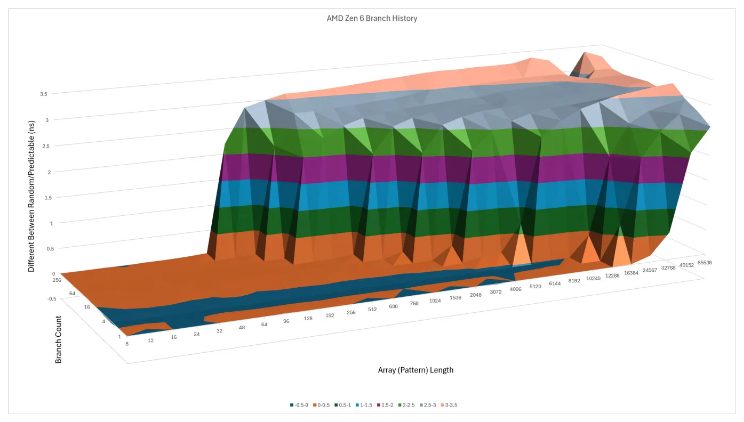
このチャートは、テキストで言及されているブランチ予測回復時間の具体的な改善を例示しています。
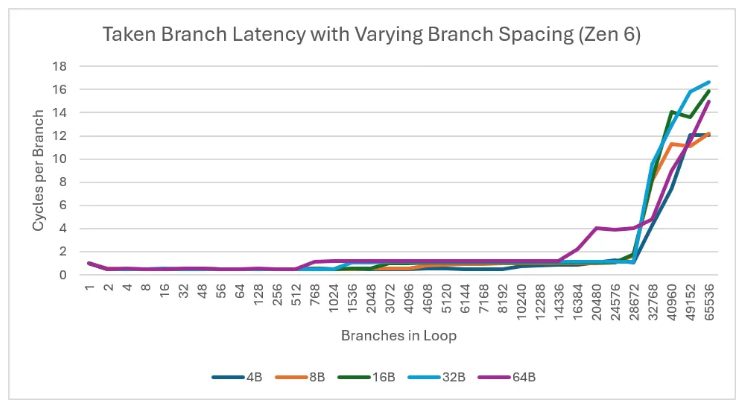
命令フェッチ段階において、重要なアーキテクチャの転換が行われています。単一のスレッドが1つのデコードクラスターしか効果的に使用できなかったZen 5とは異なり、Zen 6では単一のスレッドが両方のクラスターを同時に利用できるようになり、潜在的な命令スループットが向上しています。
この画像は、命令フェッチ段階におけるアーキテクチャの転換に関する説明をサポートします。
「これらの違いは、AMDが2つの設計を専門化していることを示唆しています。Zen 6は高周波に調整されているように見え、一方でZen 6cは比較的高いメモリレイテンシを許容するための容量を備えています。」
— AMD’s Zen 6 Family: Feeding the Beast
実行エンジンとベクトルスループット
整数演算の側面では、Zen 6はZen 4スタイルのNOPペアリング動作に戻り、コアが1サイクルあたり最大16個のNOPをリタイアできるようになりました。また、単純な64ビット加算の理論上のピークスループットも向上し、Zen 5の5.25に対し、Zen 6では1サイクルあたり5.96に達しています。
AMDは、3番目のユニットが面積コストに見合わないとして、整数乗算ユニットの数を3つから2つに削減しました。逆に、ベクトル側ではAI推論やビデオコーデックに不可欠なVNNIユニットが大幅に強化され、1サイクルあたり2つから4つへと倍増しています。
Zen 6とZen 6cのアーキテクチャの分離
初めて、「Classic」と「Dense」のコアがアウトオブオーダーエンジン内で異なる設計となりました。Zen 6は高周波向けに調整されているのに対し、Zen 6cは内部構造の容量を増やすことでレイテンシを吸収するように設計されています。
Zen 6cは、より大きな再順序バッファ(576に対し640エントリ)、より大きな整数レジスタファイル(288に対し352)、およびより大きなロードキュー(280に対し330)を備えています。これらの変更により、Zen 6cは低速なメモリアクセスによる影響を隠蔽するために、より多くの作業を「インフライト」状態で保持できるようになります。
この図は、Zen 6cがメモリレイテンシを隠蔽することを可能にする容量の違いを視覚的に表しています。
HN Digestによる図(chipsandcheese.comの報告数値に基づく)。数値はソースの表記通り。
パフォーマンスのトレードオフとメモリのスケーリング
EPYC 9686F(Zen 6)は、より高いクロック速度を維持できるため、純粋な整数および浮動小数点レートにおいて9996(Zen 6c)を上回ります。しかし、9996の128 MB L3キャッシュは、「fotonik3d」や「lbm」のような重いワークロードにおいて、メモリストールシェアを低く保つのに役立っています。
L3レイテンシはファミリー全体で増加しており、Zen 6で55サイクル、Zen 6cで66サイクルに達しています。Zen 6の高いクロックはこれらの増加の多くを隠蔽しますが、Zen 6cのより大きなキャッシュは、メインメモリへのアクセスを減らすための主要なメカニズムとして機能します。
Hacker Newsの読者の反応
- 技術的な指摘: あるコメント投稿者は、Zen 6cバリアントのアウトオブオーダー構造の拡大は、ワークロードがよりメモリ重視になるにつれてメモリレイテンシを吸収するための戦略的な動きであると指摘しました。 コメント ↗
- 技術的な指摘: ある読者は、整数乗算器の削減とPDEP/PEXTスループットについて好奇心を示し、これらの操作が同じ回路を共有しているのか、あるいは独立したハードウェアの削減を意味するのかを疑問視しました。 コメント ↗
- 懐疑的: 数人のコメント投稿者がメモリ帯域の制限について議論し、ある観察者は多くのアプリケーションが計算制限ではなくIO制限であると指摘し、別の人は帯域を増やすことよりもメモリレイテンシを減らすことの方が重要であると主張しました。 コメント ↗
- 技術的な指摘: あるコメント投稿者は、単一のCCD上の32コアのアーキテクチャ管理について、具体的にCCDと個々のコアの間に小さな論理ユニットがあるのかどうかというオープンな質問を投げかけました。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗