AIエージェントを扱うプロフェッショナルにとっての主な課題は、新しいセッションごとにコンテキスト、過去の決定、およびクライアント固有のルールを再説明する際に発生する多大な時間コストです。これを解決するために、ユーザーはエージェントのメモリを一時的な会話としてではなく、永続的で構造化された資産として扱うカスタムアーキテクチャを開発しています。
コンテキストのドリフト問題
Hacker Newsの投稿者は、複数のクライアントにわたってAIエージェントにコンテキストや過去の決定を再説明することに大きな時間コストがかかるワークフローについて記述しています。彼らはこの問題を解決するためのツールを構築するかどうかを検討しており、特にチャット、メール、チケットなど、さまざまなソースからのコンテキストを処理する方法を模索しています。
Hacker Newsのコメント欄では、多くの人がこれらの問題に対処するためにすでに同様のツールを構築していることが指摘されました。目標は、エージェントの「メモリ」をセッションを越えて持続させることで、ユーザーが以前の作業ですでに確立された指示を繰り返す必要がないようにすることです。
“私にとっての大きな時間コストは、すでに実施しているコンテキストや過去の決定、クライアントのルールを再説明することです。”
— Ask HN: How do you manage your AI agents' context across clients and projects?
永続的ストレージと共有メモリ
複数のコメント者が、コンテキストを構造化されたファイルやデータベースに移動することを提案しました。あるユーザーは、すべてのトランザクションを記録するためにOpen Knowledge Format (OKF) を使用することを提案し、これにより任意のAIモデルが履歴を読み取れるようにしました。別のアプローチでは、ローカルのSQLiteデータベースを使用してメタデータを保存し、特定のトピックに対する永続的なコンテキストを構築するために、毎セッションの最後に更新される「running topic.md」ファイルを使用します。
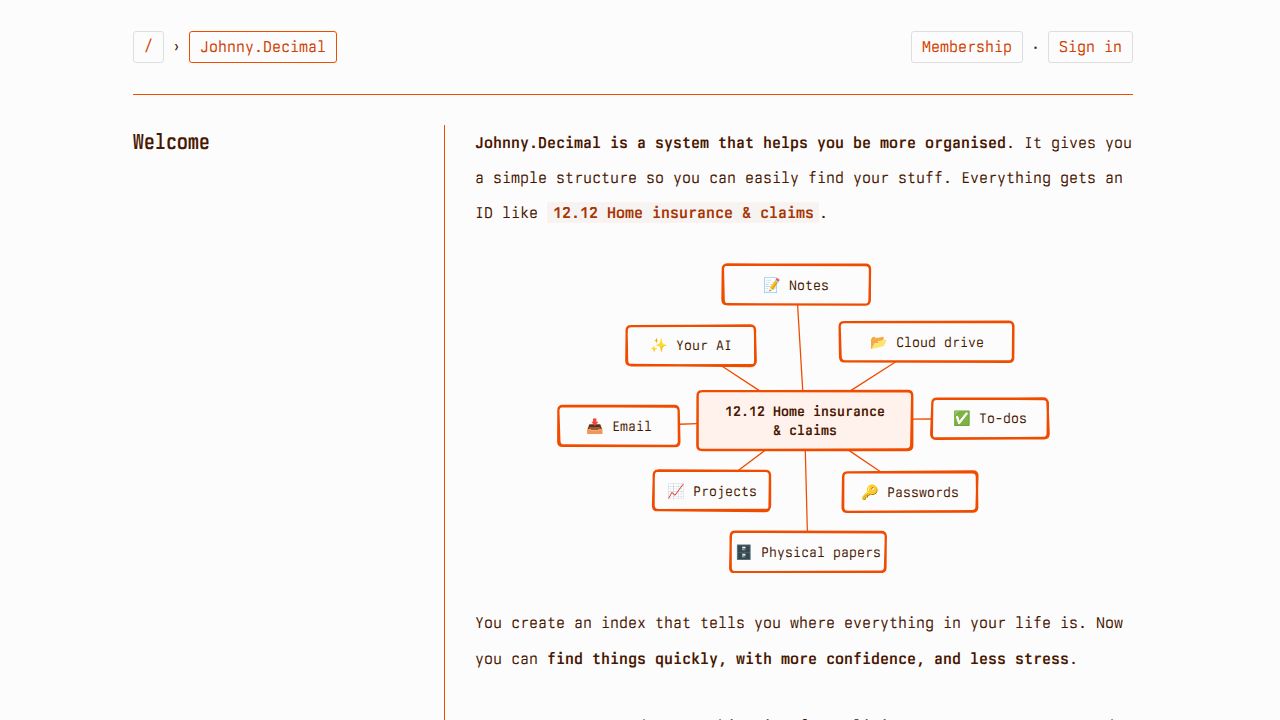
その他の方法には、gitignoredされたArchitecture Decision Record (ADR) ディレクトリやステータスドキュメントなど、バージョン管理されたファイルを使用して作業を再開する方法が含まれます。一部のユーザーは「Johnny.Decimal」システムを利用しており、ビジネスのあらゆる部分にMarkdownノートとディスク上のフォルダに関連付けられた明確なIDを割り当てることで、エージェントがCLIを介して人間が読める「共有メモリ」にアクセスできるようにしています。
隔離とマルチクライアントアーキテクチャ
プロフェッショナルにとっての重要な懸念は、あるクライアントのデータが別のクライアントに漏洩する「コンテキスト汚染」を防ぐことです。あるコメント者は、コンテキストをルート、エージェント、クライアント、プロジェクトのレイヤーに整理する「レイヤーケーキ」アーキテクチャについて説明しました。エージェントはこれらの特定のサブツリーから指示を読み込んで連結するため、「クライアントA」のために働くエージェントが「クライアントB」のサブツリーにアクセスできないことが保証されます。
他のユーザーは、スタイルを学習させるためにエージェントを特定の「模範(exemplar)」プロジェクトに向けたり、プロジェクト固有のイシュートラッカーを使用したりすることで隔離を管理しています。一部では、エージェントが新しい作業のラウンドを開始する前に、プロジェクトのWikiに新しい知見が更新されているかどうかを検証する「ゲートキーパー」スクリプトを使用しています。
トレードオフと技術的制約
これらの手法は一貫性を向上させる一方で、コストと複雑さのトレードオフをもたらします。例えば、エージェントが重要な詳細を決して忘れないようにプロジェクトのWikiでセマンティック検索を使用すると、トークン使用量の面で高額になる可能性があります。しかし、一部のユーザーは、プロジェクトのあらゆる段階を完璧に再現できるというメリットのために、このコストを払う価値があると主張しています。
議論では、エージェントのループにおけるターミナルインターフェースの制限など、技術的な摩擦も浮き彫りになりました。一部のユーザーは、週間の使用制限内に収めつつ、複数のモデル(ClaudeやCodexなど)を同時に管理するために、Podmanコンテナでエージェントを実行したり、ローカルのWebサーバーを使用したりすることを好んでいます。