現在の人工知能モデルは、人間と比較して学習効率が著しく低く、約10,000,000倍のサンプル効率のギャップがある。人間は約100兆のパラメータを持ち、わずか2億トークンから学習するのに対し、Chinchillaの処方箋に従う現在のAIモデルなどは、パラメータあたりのトークン比率を20:1としている。このギャップを埋めるために、Qの研究者たちは、モデルを7桁拡大し、潜在的にクアドリリオンパラメータの規模に達する必要があることを示唆している。
固定サイズを超えたスケーリング
Chinchillaの処方箋のような標準的なスケーリング則は、固定されたデータセットに対して固定されたモデルサイズ(具体的にはパラメータあたり20トークン)を提案している。しかし、高品質なトレーニングデータの供給がボトルネックになるにつれ、モデルはますますマルチエポックかつデータ制約のあるレジームでトレーニングされるようになるだろう。
新しい研究では、データセットを固定した場合、計算予算が増加するにつれて計算量的に最適なモデルサイズが増大し続けることが判明した。このレジームにおいて、研究者たちは10^29 FLOPsにおいてアンサンブルがトークンあたり300以上のパラメータを保持すべきであることを発見した。これは以前の処方箋からの大幅な増加である。
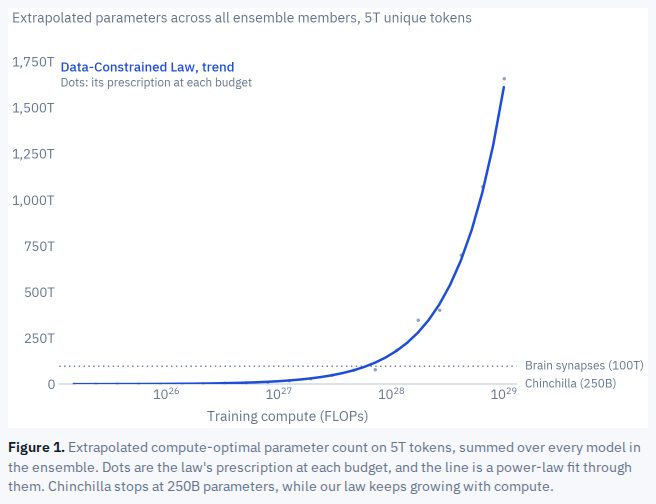
この図は、固定されたデータセットでトレーニングする場合、モデルサイズが以前の処方箋よりも大幅に大きくなるべきであるという核心的な発見を視覚化している。
「AIと人間の間のパラメータあたりのトークンギャップは10,000,000倍であり、サンプル効率のギャップを埋めるための重要な一歩は、このギャップを埋めることかもしれない。」
— Quadrillion-parameter transformers and how to train them – Q
ハイパーパラメータのスケーリングとWeight Decay
新しい法則の重要な発見は、マルチエポックでトレーニングされるより大きなモデルに対して、ハイパーパラメータがどのように適応しなければならないかである。以前のデータ制約のある法則ではWeight Decayを固定していたため、計算量が増えるにつれて予測される損失が増加していた。
研究者たちは、最適なWeight Decayがエポック数とモデルサイズの両方に対して急激に増加することを示すパワー則を適合させた。彼らの法則は適合された計算量の16倍においてほぼ最適であり、一方で以前のヒューリスティックはこれらの変数の相互作用を考慮できていなかった。
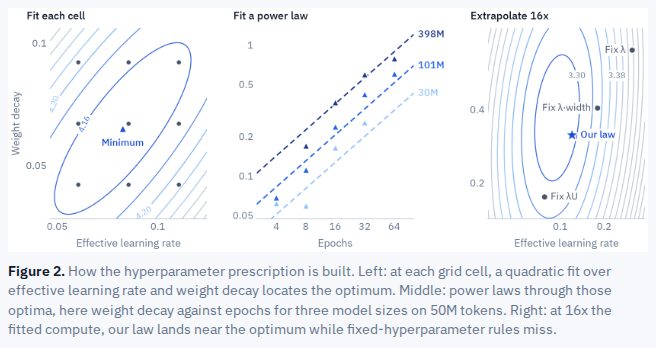
このチャートは、新しいスケーリング則の重要な構成要素である、ハイパーパラメータに対するパワー則の適合手法を説明している。
スケーリング軸としてのアンサンブル
サンプル効率をさらに向上させるため、研究者たちはアンサンブルを第一級のスケーリング軸として統合した。彼らは、単一のトレーニング実行からのチェックポイントを保存し、それらの予測を平均化する「Snapshot Ensembling」を利用した。これにより、追加のトレーニング計算量なしで性能の向上が得られる。
データセットに対して非常に大きな計算予算がある場合、この法則は余剰の計算量を「Deep Ensembling(ディープ・アンサンブル)」、つまり異なるシードで独立したモデルをトレーニングすることに割り当てることを示唆している。このアプローチは過学習を軽減し、以前のレシピでは最終的に性能が低下する地点において、計算量の増加とともに損失を低下させ続けることを可能にする。
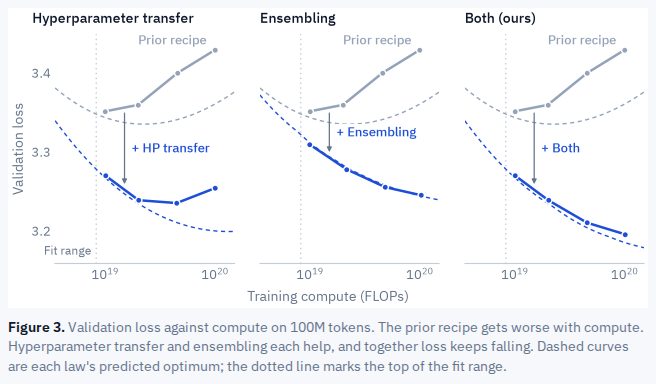
この視覚資料は、アンサンブルがサンプル効率を向上させるための第一級のスケーリング軸として機能するという主張を裏付けている。
クアドリリオンパラメータへの道
これらのスケーリング則の最終的な目標は、人間のような学習効率に一致するためにクアドリリオンパラメータの規模に到達することである。現在の研究は、限られたデータセットでこれらのサイズに到達するための数学的な処方箋を提供するが、著者らは、この移行にはハードウェアとアルゴリズムの大きな進歩が必要になると指摘している。
現在のモデルは、人間の脳の効率に一致するには約7桁小さすぎる。このギャップを埋めることは、Transformerモデルの設計およびトレーニング方法における根本的な転換を意味する。
Hacker Newsの読者の反応
- 代替案: あるコメント投稿者は、人間はランダムに初期化された重みから始まるのではなく、進化による強力な帰納バイアスを持っているため、人間の学習をTransformerのトレーニングと比較することは不適切であると主張した。 コメント ↗
- 懐疑的: 別のコメント投稿者は、人間の学習に使用されたデータ数値に対して懐疑的な見方を示し、人間は視覚や触覚などの感覚を通じて大幅に多くのデータを受け取っていると示唆した。 コメント ↗
- 疑問: あるコメント投稿者は、人間の脳が受け取る複雑な入力を簡単にトークン化することの実現可能性について質問を投げかけた。 コメント ↗
Hacker Newsのスレッドで出た意見の要約です。事実として検証されたものではありません。 議論の全文を読む ↗