研究者たちは、標準的なマルチトークン予測(MTP)の学習における根本的な欠陥を特定しました。それは、勾配の「残留」成分が次トークン学習とマルチトークン学習の両方を妨害する問題であり、モデルのスケールが大きくなるほどこの問題は悪化します。1行のコード変更で導入されるSoft-MTPにより、このノイズから有用なKL自己蒸留信号を分離することが可能になり、様々なモデルサイズにおいてパープレキシティの低下と投機的デコーディングの高速化を実現しました。
標準的なMTP学習における欠陥
マルチトークン予測(MTP)は、下流のパフォーマンスを向上させ、投機的デコーディングを通じて高速な推論を可能にするために一般的に使用される手法です。しかし、標準的なMTP学習は勾配分解の問題を抱えています。すなわち、クロスエントロピー勾配には有用なKL自己蒸留項と、信号対雑音比の低い残留成分が含まれているのです。
このノイズの多い残留成分は有用なKL信号を埋没させ、モデルの効果的な学習能力を妨げます。モデルのサイズが大きくなるほどこの干渉は深刻な問題となり、MTP能力のスケールアップに対するボトルネックとなっています。
「Soft-MTPは、実質的にMTP最適化のための『フリーランチ(無料の昼食)』です。」
— Multi-Token Prediction Done Right
KL勾配リカリカリ・トリック
Soft-MTPは、「KL勾配リカバリ・トリック」を実装することでこの問題に対処します。2つの分布が線形出力ヘッドを共有する場合、それらのKLダイバージェンスの勾配は、ストレートスルー勾配ルーティングを通じてそれらのクロスエントロピー勾配を組み合わせることで正確にリカバリできます。
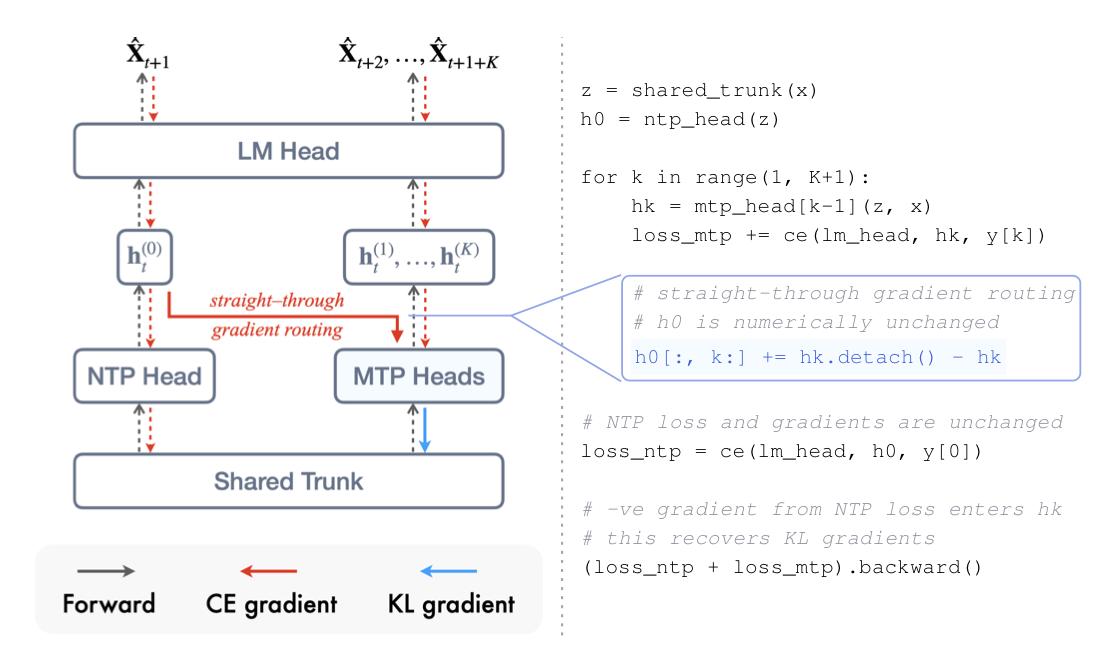
この図はSoft-MTPのコアメカニズム、特にマルチトークン予測の学習を改善するための勾配ルーティングの処理方法を説明しています。
このアプローチは、直接的なKLダイバージェンスの最小化に通常必要とされる膨大な語彙サイズのロジット行列を必要としないため、計算効率に優れています。また、標準的な融合クロスエントロピーカーネルと互換性があるため、最適化における「フリーランチ」となります。
実装は単一の関数変更であり、DeepSeekスタイルおよびMetaスタイルの両方のMTPアーキテクチャをサポートします。既存のNTPおよびMTPクロスエントロピー計算を再利用し、目的のKL自己蒸留信号のみをバックプロパゲーションさせます。
パフォーマンスの向上とトレードオフ
167Mから1.2Bパラメータまでのモデルにわたるテストでは、Soft-MTPが一貫して標準的なMTPを上回ることが示されました。主な改善点には、テストしたすべてのスケールにおける次トークン予測(NTP)パープレキシティの低下と、より高いゼロショット精度が含まれます。
より大きなモデル(689Mパラメータ以上)では、Soft-MTPはMTPパープレキシティも低下させます。さらに、この手法はファインチューニング後において、優れた数学およびコードの推論能力を示すことも証明されました。
Soft-MTPはほとんどの指標において直接的なKLダイバージェンスの最小化と同等またはそれ以上の性能を発揮しますが、特定の「ノイズの多い残留」干渉の大きさや、すべての指標の正確な数値は主要なレポートでは完全には詳述されていません。