2人の研究者による研究室が、より効率的な生成ビデオモデルのための概念実証として設計された「Pyramid-JiT (P-JiT)」というテキストから画像を生成するモデルを公開しました。このプロジェクトの主な目標は、アテンションメカニズムの二次関数的な複雑さに起因することが多い、ビデオ生成の高い計算コストに対処することでした。研究者たちは、画像を潜在空間に圧縮する従来の変分オートエンコーダー(VAE)から離れることで、VAE圧縮の実証的な限界を回避し、ピクセル空間の環境でより効率的に学習することを目指しました。
P-JiTアーキテクチャは、32x32のトークン削減を使用することでこれを実現しており、これはFLUX-2のような標準的なモデルと比較してアテンションコンテキストウィンドウを4倍削減したことを意味します。収束を加速させるために、チームはノイズスケジュールに「カリキュラム」を実装しました。モデルはまず高ノイズのサンプルでトレーニングを行い基本構造を学習し、その後、微細なディテールを捉えるために分布を広げます。トレーニング体制には6億6,000万のサンプルが含まれ、20億パラメータのDiffusion Transformer (DiT)とフリーズされたQwen3.5-4Bテキストエンコーダーを利用しました。H100 GPUを使用した事前トレーニングおよび事後トレーニングの総計算コストは約21,038ドルでした。
このモデルはポートレートや風景において高品質な結果を示しますが、その小さなサイズは複雑なシーンの生成において特定のトレードオフをもたらします。研究者たちは、モデルが複数人の相互作用、多数のエンティティ(ドライバーの山やカモメの群れなど)、および世界知識の処理に苦労していると指摘しました。さらに、モデルはレンダリングされたテキストでトレーニングされていないため、インフォグラフィックやポスターを生成することはできません。これらの制限は20億パラメータというスケールの予想される結果であり、チームは、より大きなモデルをトレーニングし、Finite Difference Flow Optimization (FDFO)のようなさらなる事後トレーニング技術を適用することで緩和できる可能性があると示唆しています。
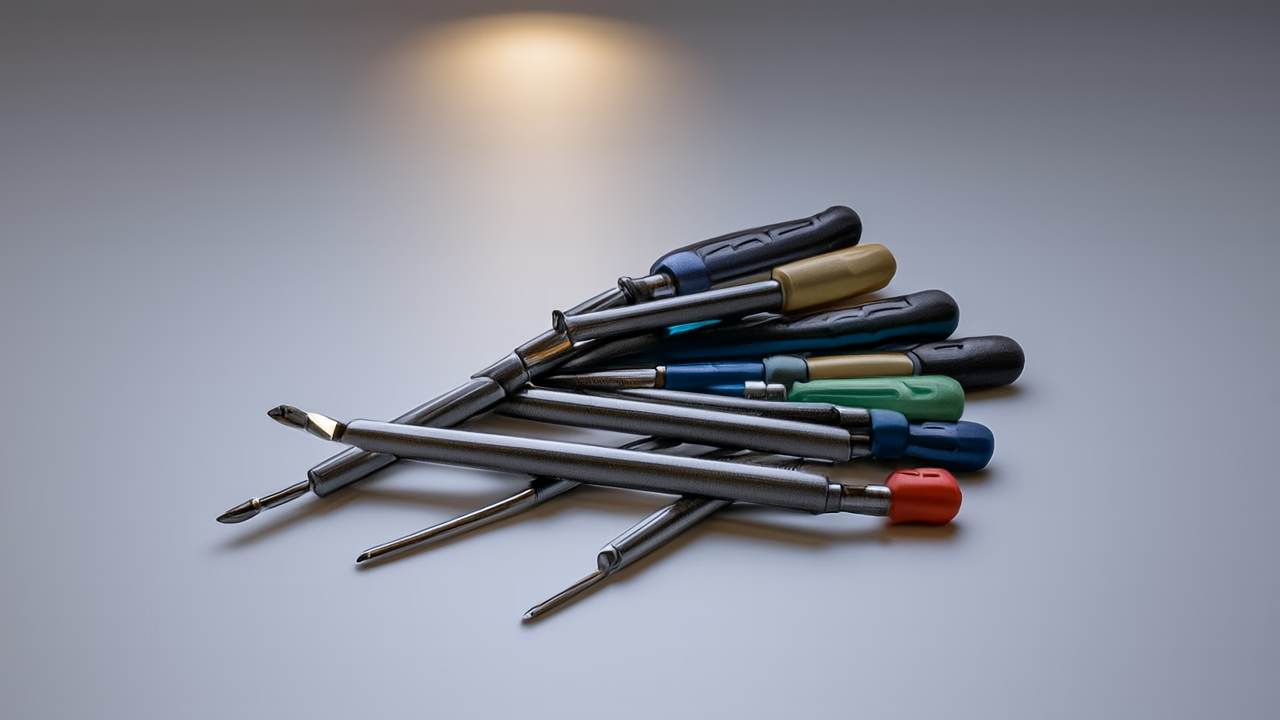
この画像は、単一のシーン内で多くの異なるエンティティを生成することに対するモデルの困難さを例証しています。
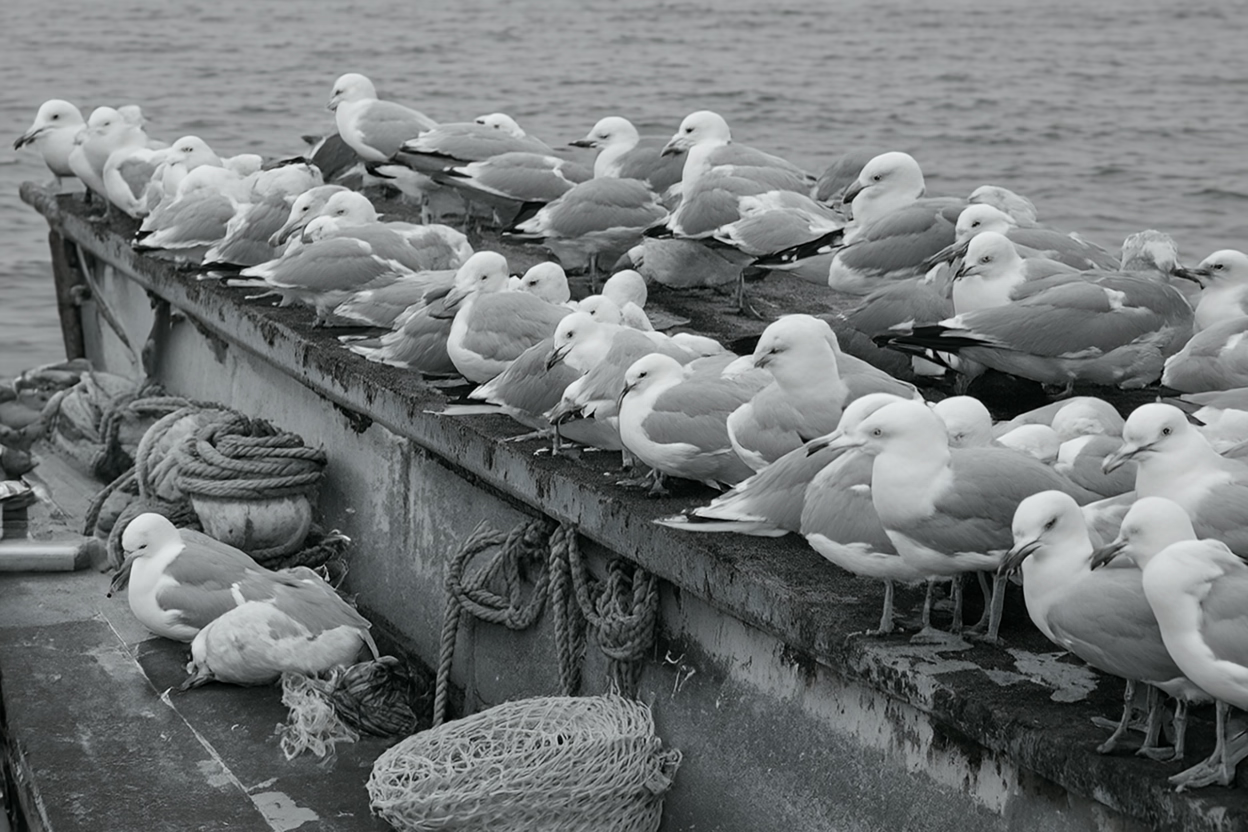
この視覚資料は、テキストで言及されている群衆や複数のエンティティに関する特定の制限を実証しています。
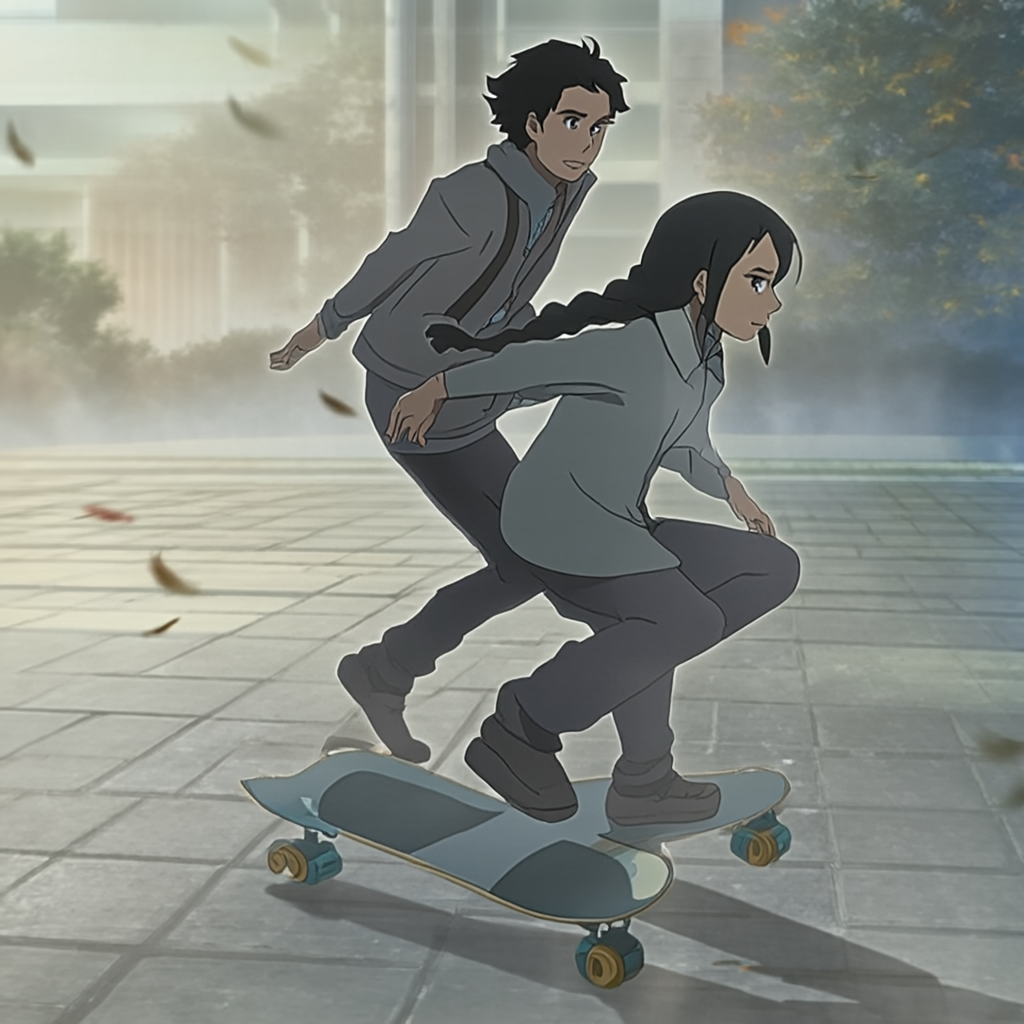
この画像は、モデルが複数人の相互作用に苦労している具体的な例を提供しています。