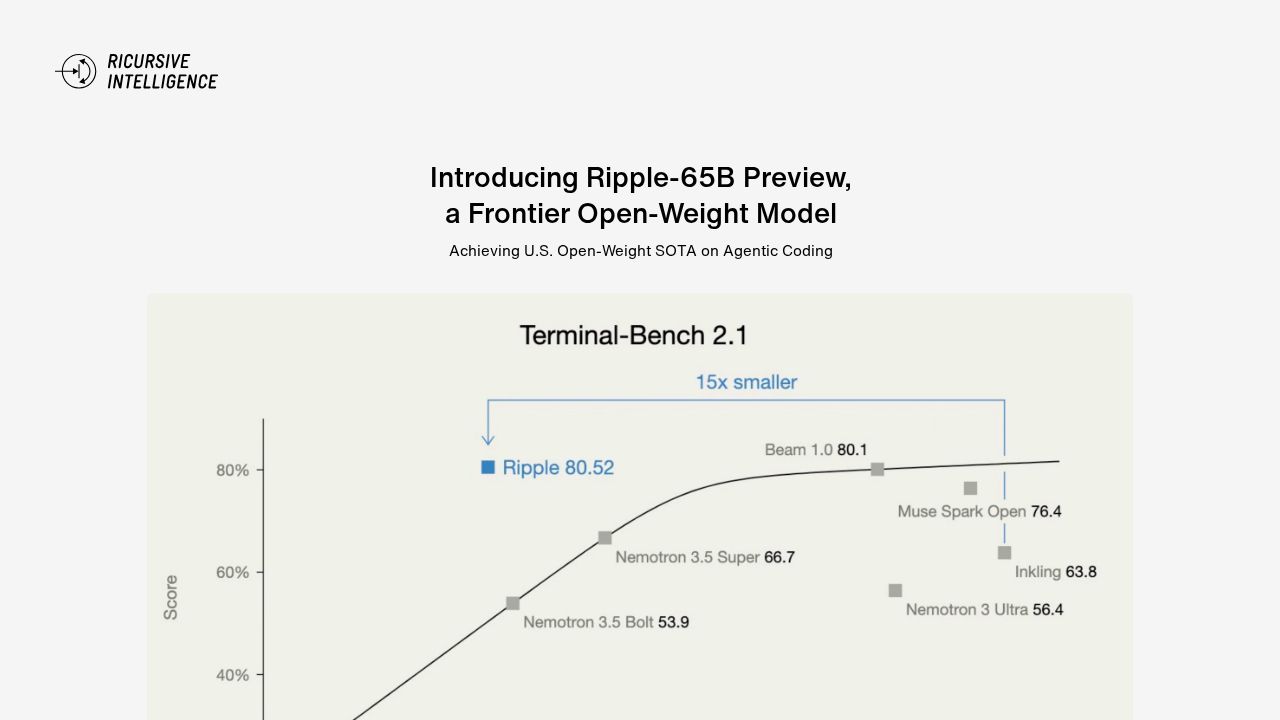
Ripple-65Bは、米国で開発されたオープンウェイトの大規模言語モデル(LLM)であり、AIが自律的なエージェントとしてコードの記述、デバッグ、実行を行う「エージェンティック・コーディング」において優れた能力を発揮するように特別に設計されています。開発者はこのモデルを最先端(SOTA)のソリューションとして位置づけており、これはモデルの性能と物理的なサイズの最適なバランスを測定するパレート曲線における位置付けを指しています。オープンウェイト版を提供することで、このプロジェクトは、ローカルでの推論やモデルのアーキテクチャに対する特定の透明性を必要とする開発者に対して、高性能な代替手段を提供することを目指しています。
純粋な性能の面では、Ripple-65Bはコマンドラインやターミナルベースのコーディングタスクをモデルがいかにうまく処理できるかを評価する指標であるTerminal Bench 2.1において80.5というスコアを達成しました。しかし、他のモデルと比較した際の立ち位置は微妙なものです。例えば、より大規模ではあるものの、効率を維持するためにMixture of Experts(MoE)アーキテクチャを採用しているQwen 3.8 Flash Nextモデルは84.3とより高いスコアを記録しました。逆に、Qwen 3.8-27Bモデルは73.0と低いスコアでした。これらの数値は、Ripple-65Bがある特定のパラメータ内では競争力がある一方で、速度と精度の異なるトレードオフを提供する国際的なモデルから厳しい競争にさらされていることを示唆しています。
このモデルの主張については、ベンチマークの選択や比較モデルに関して精査が行われています。一部の観察者は、Beam 1.0やNemotron 3.5 Superといった同規模カテゴリーの優れたモデルをあえて除外し、競争力の低いベースラインを採用することで、性能データがRipple-65Bに有利に働いているように見えると指摘しています。さらに、「米国製」というブランディングは、具体的なデータの出所や、モデルの性能が独自の国内トレーニングセットによるものなのか、あるいは単にコーディングというニッチな分野に対する特定の最適化によるものなのかについて疑問を投げかけています。このプレビューではトレーニングデータと重みのすべてが公開監査されていないため、その「エージェンティック」な能力の正確な範囲については、現在もコミュニティによる評価が続いている段階です。