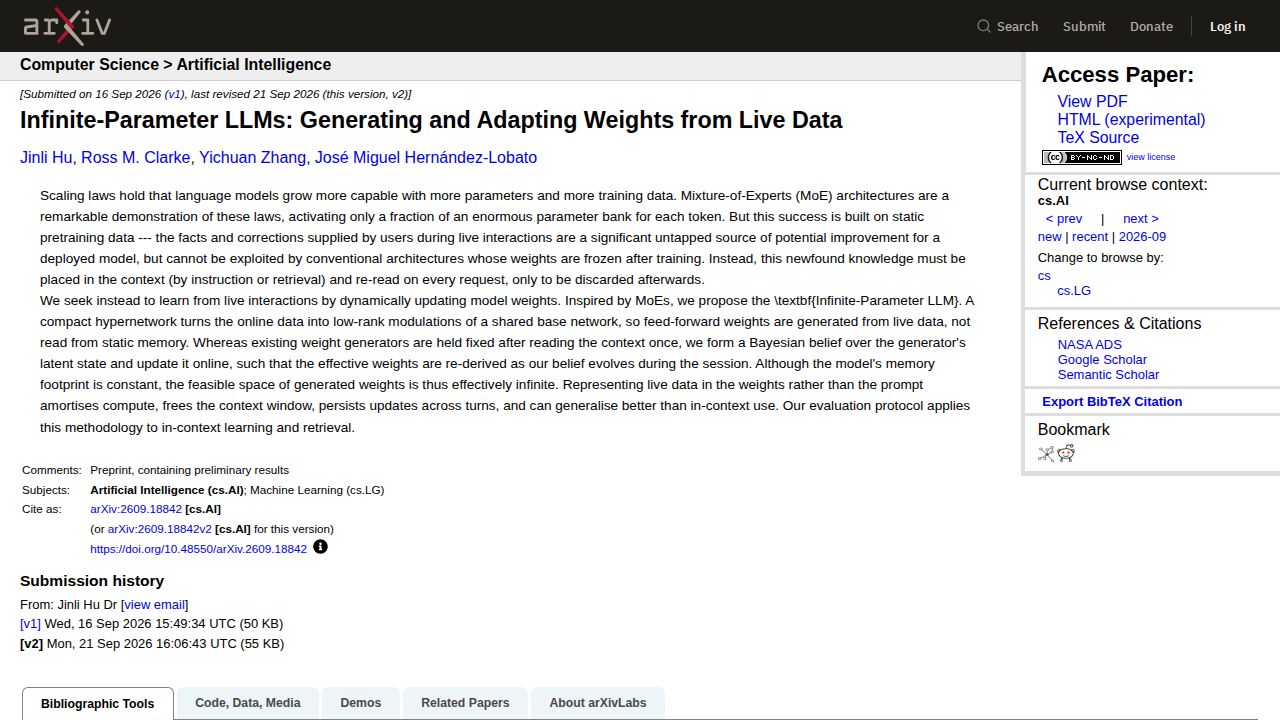
現在の大規模言語モデル(LLM)は、一般的に事前学習フェーズの後に固定される静的な重みに基づいて構築されています。これらのモデルは、会話中にユーザーから提供される新しい情報を処理できますが、それはそのデータを「コンテキストウィンドウ」に配置することで行われます。これは、各リクエストごとに読み取られ、その後破棄される一時的なメモリ空間です。つまり、モデルは、別途コストのかかる再学習やファインチューニングのプロセスを経ない限り、ライブなやり取りから新しい事実や修正を真に「学習」したり内面化したりすることはできません。
この課題を解決するために、研究者たちは「無限パラメータLLM」を提案しました。このアーキテクチャは、コンパクトなハイパーネットワークを使用して、ライブデータを共有ベースネットワークの低ランク変調へと変換します。固定されたメモリバンクから重みを読み取る代わりに、モデルのフィードフォワード重みは、リアルタイムで受け取るデータから動的に生成されます。このアプローチの重要な特徴は、生成器の潜在状態に対するベイズ的信念を使用している点です。プロンプトを一度読み取った後に固定される可能性のある従来の重み生成手法とは異なり、このシステムはオンラインで信念を更新するため、セッションを通じてモデルの内部状態が進化するにつれて、有効な重みを再導出することが可能になります。
この手法は、標準的なインコンテキスト学習と比較していくつかの実用的な利点を提供します。ライブデータを重みそのものの中に表現することで、モデルは計算コストを償却し、コンテキストウィンドウのスペースを他のタスクのために解放し、潜在的には新しい情報をより効果的に汎用化することができます。しかし、継続的な学習への移行は新たな複雑さをもたらします。研究者や観察者は、絶え間ない重みの更新中にモデルの安定性を維持することが大きな課題であると指摘しており、モデルが絶えず進化する際に予測不可能な挙動が現れる可能性があるためです。さらに、継続的学習モデルは、特定のユーザー入力によってモデルを意図しない挙動やバイアスへと押し進める「ポイズニング」のような、独自のセキュリティリスクに直面する可能性があります。
提案されたアーキテクチャは、あらゆるやり取りから真に学習するモデルへの道筋を提供していますが、この研究は現在は予備的な結果を示すプレプリント段階にあります。この「無限」の重み空間を、従来のMixture-of-Experts(MoE)やLow-Rank Adaptation(LoRA)技術と比較する具体的な性能ベンチマークは、技術が成熟するにつれてさらなる調査が必要な領域として残されています。