行列乗算のための単純なネストされたループは、CPUがどのようにデータをキャッシュにフェッチするかを考慮していないため、OpenBLASのようなプロフェッショナルなライブラリのわずか1.1%の速度しか出ないことがあります。高レベルなコードと高性能なカーネルの間の溝を埋めるために、Csongor Kiss氏は、バッファがどのメモリレベルを占有するかといったハードウェアの仮定をソースコードの明示的な一部とする言語「Cachet」を構築しています。
隠れた最適化の問題
プログラムを最適化するには、通常、コンパイラがデータフローを処理するのに十分なほど賢いことを期待するか、あるいはハードウェアに合わせてコードを手動で書き換えるかのいずれかが必要です。後者の場合、抽象化は崩壊し、開発者はキャッシュの滞留やベクトル化などの複雑な詳細を手動で管理しなければなりません。
どちらのシナリオにおいても、重要な決定はしばしば隠されています。コンパイラは内部のハードウェアモデルに基づいてそれらを行い、人間の開発者はそれらを頭の中やコメントの中に保持します。Cachetは、これらの決定を言語自体に移すことを目的としており、コードの進化に合わせて、ハードウェアに関するプログラマーの仮定が依然として正しいことをコンパイラがチェックできるようにします。
「Cachetでは、バッファがどのキャッシュに留まるか、メモリレベル間でどれだけのデータが移動するか、そしてハードウェアがどの命令を提供するかは、言語の一部です。」
— Write your own kernel optimiser | Csongor Kiss
収縮とスケジュール
Cachetは、計算を定義するために「収縮(contraction)」モデルを使用します。ループを書く代わりに、開発者は各出力要素に対して数学的な方程式を書きます。例えば、行列乗算は、自由なインデックスが出力を決定し、合計されるインデックスが操作を決定する数式によって定義されます。
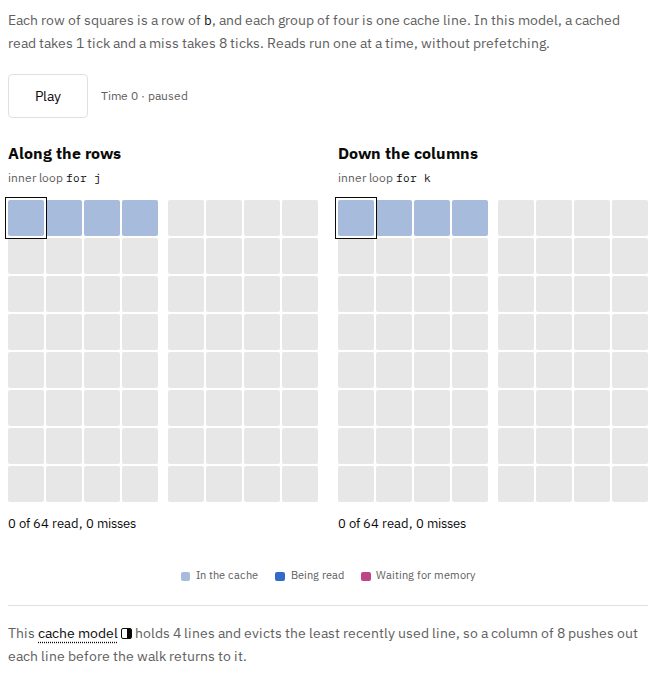
この画像は、Cachetが数学的な収縮へと抽象化することを目指している手動の計算プロセスを説明しています。
HN Digestによるグラフ(blog.csongor.co.ukの報告数値に基づく。数値はソースの表記通り)。
この定義を高速なプログラムに変換するために、Cachetは「スケジュール」を使用します。これは、収縮を最適化されたループネストに書き換える一連の変換です。コンパイラはスケジュールの各ステップをチェックし、変換が計算の元の意味を保持していることを確認します。例えば、異なる出力が数学を破壊するような形で重ならないことを保証します。
検証可能な書き換えとハードウェアのマッピング
このシステムは「steps」ライブラリを使用しており、各書き換えには「証明レシピ」が付随します。これにより、コンパイラは、キャッシュヒットを改善するためのループの入れ替えのような変換が、コンパイルされている特定のプログラムに対して数学的に有効であることを検証できます。
このアプローチにより、「ブロッキング」のような複雑な最適化が可能になります。これは、プロセッサがそれに対して複数の操作を実行している間、データの塊をキャッシュ内に保持する手法です。これらのステップを明示的にすることで、開発者はメモリレベル間のデータ移動について推論することができ、同時にコンパイラは論理が健全であることを保証します。
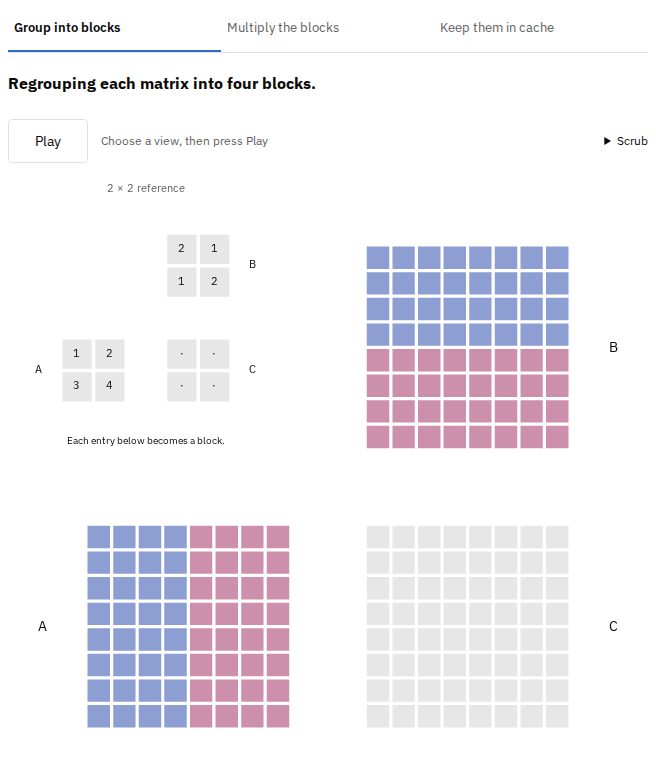
この図は、本文で言及されている「ブロッキング」最適化の主要な構成要素である入力再利用の概念を説明しています。
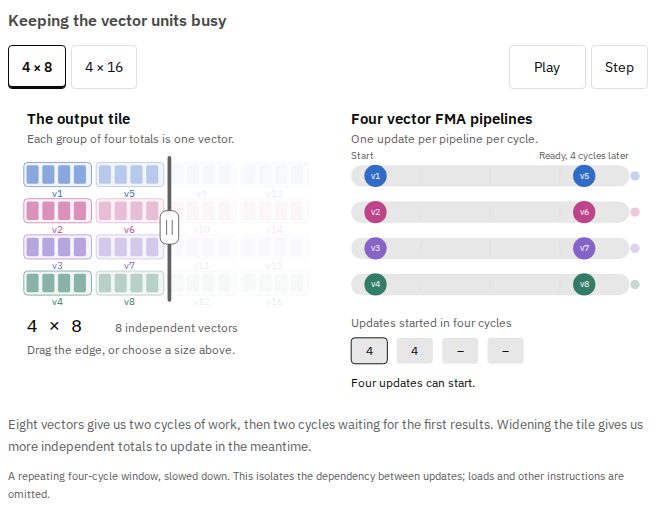
この画像は、最大パフォーマンスのためのカーネルのチューニングとハードウェアのマッピングに関する議論をサポートしています。
トレードオフと現在の制限
Cachetの主なトレードオフは、プログラマーが基礎となるハードウェアアーキテクチャをより深く理解する必要があることです。これにより、コンパイル時にパフォーマンスの低下を検知できるという安全性は提供されますが、標準的な高レベルライブラリよりも事前のアーキテクチャに関する知識を要求します。
現在、このツールはNVIDIA H100ハードウェア向けのプログラムを検証できますが、まだその特定のプラットフォーム向けにビルドする機能は備えていません。目標は、パフォーマンスが「巧妙な」コンパイラの副作用ではなく、意図的で検証可能な選択となるようなフレームワークを提供することです。