すべてのレジからの売上レシートを処理するシステムにおいて、繰り返し発生する問題に直面しました。特定の日のレポートは、オフラインのレジからのレシートが数週間遅れて到着することや、Kafkaの「少なくとも1回(at-least-once)」の配信によって同じレシートが2回カウントされることが頻繁にあるため、決して完全に確定することができませんでした。この問題を解決するために、エンジニアはストリームの不規則性によって容易に破損する従来の「累計(running sum)」モデルから、集計をソースドキュメントの決定論的な関数として定義する設計へと移行しました。
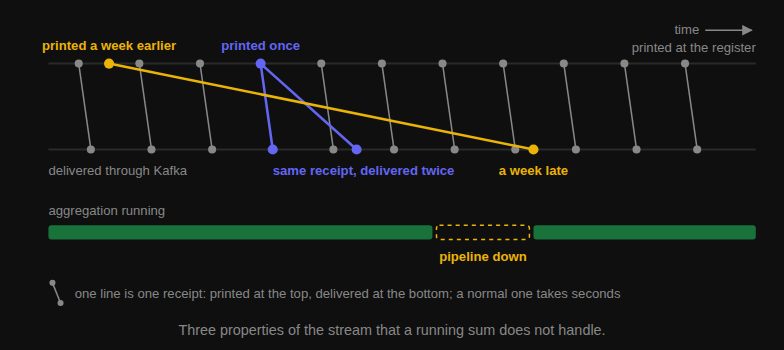
この視覚資料は、エンジニアがデータ不整合の根本原因として特定した、重複や遅延到着などの特定のストリームの不規則性を説明します。
累計モデルの失敗
標準的な集計パイプラインは、データが到着するたびに合計値に加算する「マテリアライズドビュー」に依存することがよくあります。しかし、このアプローチはストリームが同じドキュメントを2回提供した場合に破綻します。システムは重複を特定または差し引く方法がないまま、2回目を加算してしまうからです。同様に、ドキュメントが1ヶ月遅れて到着した場合、すでに「確定」した期間の累計には、複雑なロジックなしでは容易に組み込むことができません。
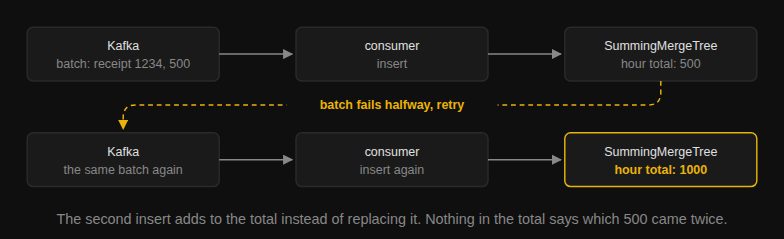
この画像は、本文で言及されている「挿入時に加算」メソッドの特定の失敗モードを実証します。
エンジニアはこれを解決するために4つの異なるアプローチをテストしました。ワイドテーブルからの再計算を試みましたが、データが日付順にソートされていなかったため、必要な508,000件のレコードを見つけるためにデータベースは4,600万行を読み取る必要がありました。また、すべての既知のキーをメモリ内の辞書として保持する方法も試みましたが、キーセットがプロダクションのメモリに収まりきらず、システム全体が停止してしまいました。
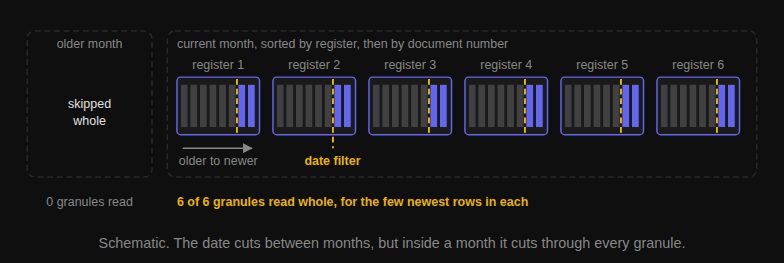
この図は、ワイドテーブルからの再計算に数百万行の不要な行の読み取りが必要であった理由の説明を裏付けています。
HN Digestによる図(alnovis.ioの報告数値に基づく)。数値はソースの表記通り。
「集計とは、挿入されたものの累計ではなく、そのドキュメントの関数である。」
— An Aggregate Is a Function, Not a Sum | Alexander Novikov
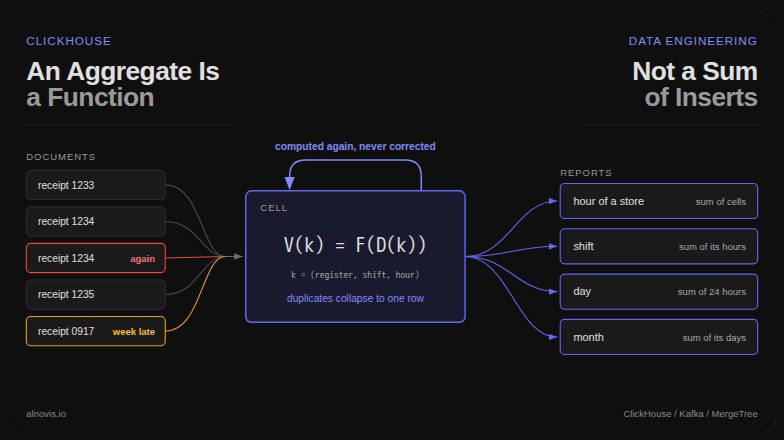
この画像は、集計をソースドキュメントの決定論的な関数として扱うという、この記事の核心となる主張の主要な視覚資料として機能します。
セルモデルと関数型集計
解決策は、集計をドキュメントの関数として扱うことでした。システムは、特定のレジのシフトと時間など、集計の最小単位である「セル」を定義します。すべてのドキュメントは正確に1つのセルに属します。そのセルの値は、そのキーに属するドキュメントをグループ化し、フォールド操作(合計や最大値など)を適用することで計算されます。
値がドキュメントの関数であるため、再計算はべき等です。ドキュメントが2回配信された場合、システムは計算中に一意のIDによってそれを統合します。ドキュメントが遅れて到着した場合は、次回の再計算パスのために対応するセルを単に「ダーティ(dirty)」としてマークするだけです。これにより、メモリを大量に消費する複雑な重複排除テーブルの必要性がなくなります。
ワイドテーブルとジャーナルによる最適化
ClickHouseでこれを効率的に行うために、チームは、メジャーに必要な列のみを含み、レジとドキュメント番号でソートされた「ナローテーブル(narrow table)」を使用しました。このレイアウトにより、単一のセルのすべてのドキュメントが隣接して配置されることが保証され、システムはフルテーブルスキャンではなく、短い範囲のスキャンを実行できるようになります。テストでは、この手法により読み取り行数がワイドテーブルと比較して30倍から37倍減少しました。
「ダーティマーク」ジャーナルは、再計算が必要なセルを追跡します。ドキュメントが挿入されると、`ReplacingMergeTree`にマークが書き込まれます。バックグラウンドプロセスは、最後のマークの時刻と最後の正常な再計算の時刻を比較します。マークが最後の再計算よりも新しい場合、そのセルは次の処理バッチに追加されます。これにより、システムは単に中断した箇所から再開するだけで、障害から自動的に回復できるようになります。