大規模言語モデル(LLM)エージェントは、組織のデータランドスケープに対する構造的な理解を欠いているため、信頼性の高い分析を行うことが困難な場合が多くあります。エージェントはドキュメントを取得したりデータベースをクエリしたりすることはできますが、特定のデータがどこにあるのか、その定義が何を意味するのか、あるいは他のエンティティとどのように関連しているのかを知るためのコンテキストを欠いていることが頻繁にあります。NVIDIAのAuto Ontologyは、生データとAIエージェントの間に位置するセマンティックレイヤーを提供することでこの問題に対処します。このレイヤーは、異なるシステム間での不一致な定義を調整するナレッジグラフとして機能し、エージェントの推論が単なる生で曖昧なデータポイントではなく、認定されたビジネスロジックに基づいていることを保証します。
このフレームワークは、FastAPIバックエンド、Next.jsフロントエンド、およびベクトルストレージ用のpgvectorを備えたPostgresデータベースを使用したマルチコンポーネントスタックとして動作します。開発者は既存のメタデータから企業オントロジーを発見および生成することができ、エージェントを信頼できる関係性の中に「接地(ground)」させる方法を提供します。主要な技術的特徴は、自然言語の質問を、認定された定義およびリネージ(系統)に対して検証されるSQLクエリに変換する能力です。このプロセスにより、生成される回答にプロバンス(由来)が含まれることが保証され、AIの出力がより説明可能になります。また、このシステムは推論、エンティティ抽出、および埋め込みのための特定の構成であるModel Tripletsをサポートしており、これらはNVIDIA NIMエンドポイントまたはセルフホストされたインスタンスを介してホストできます。
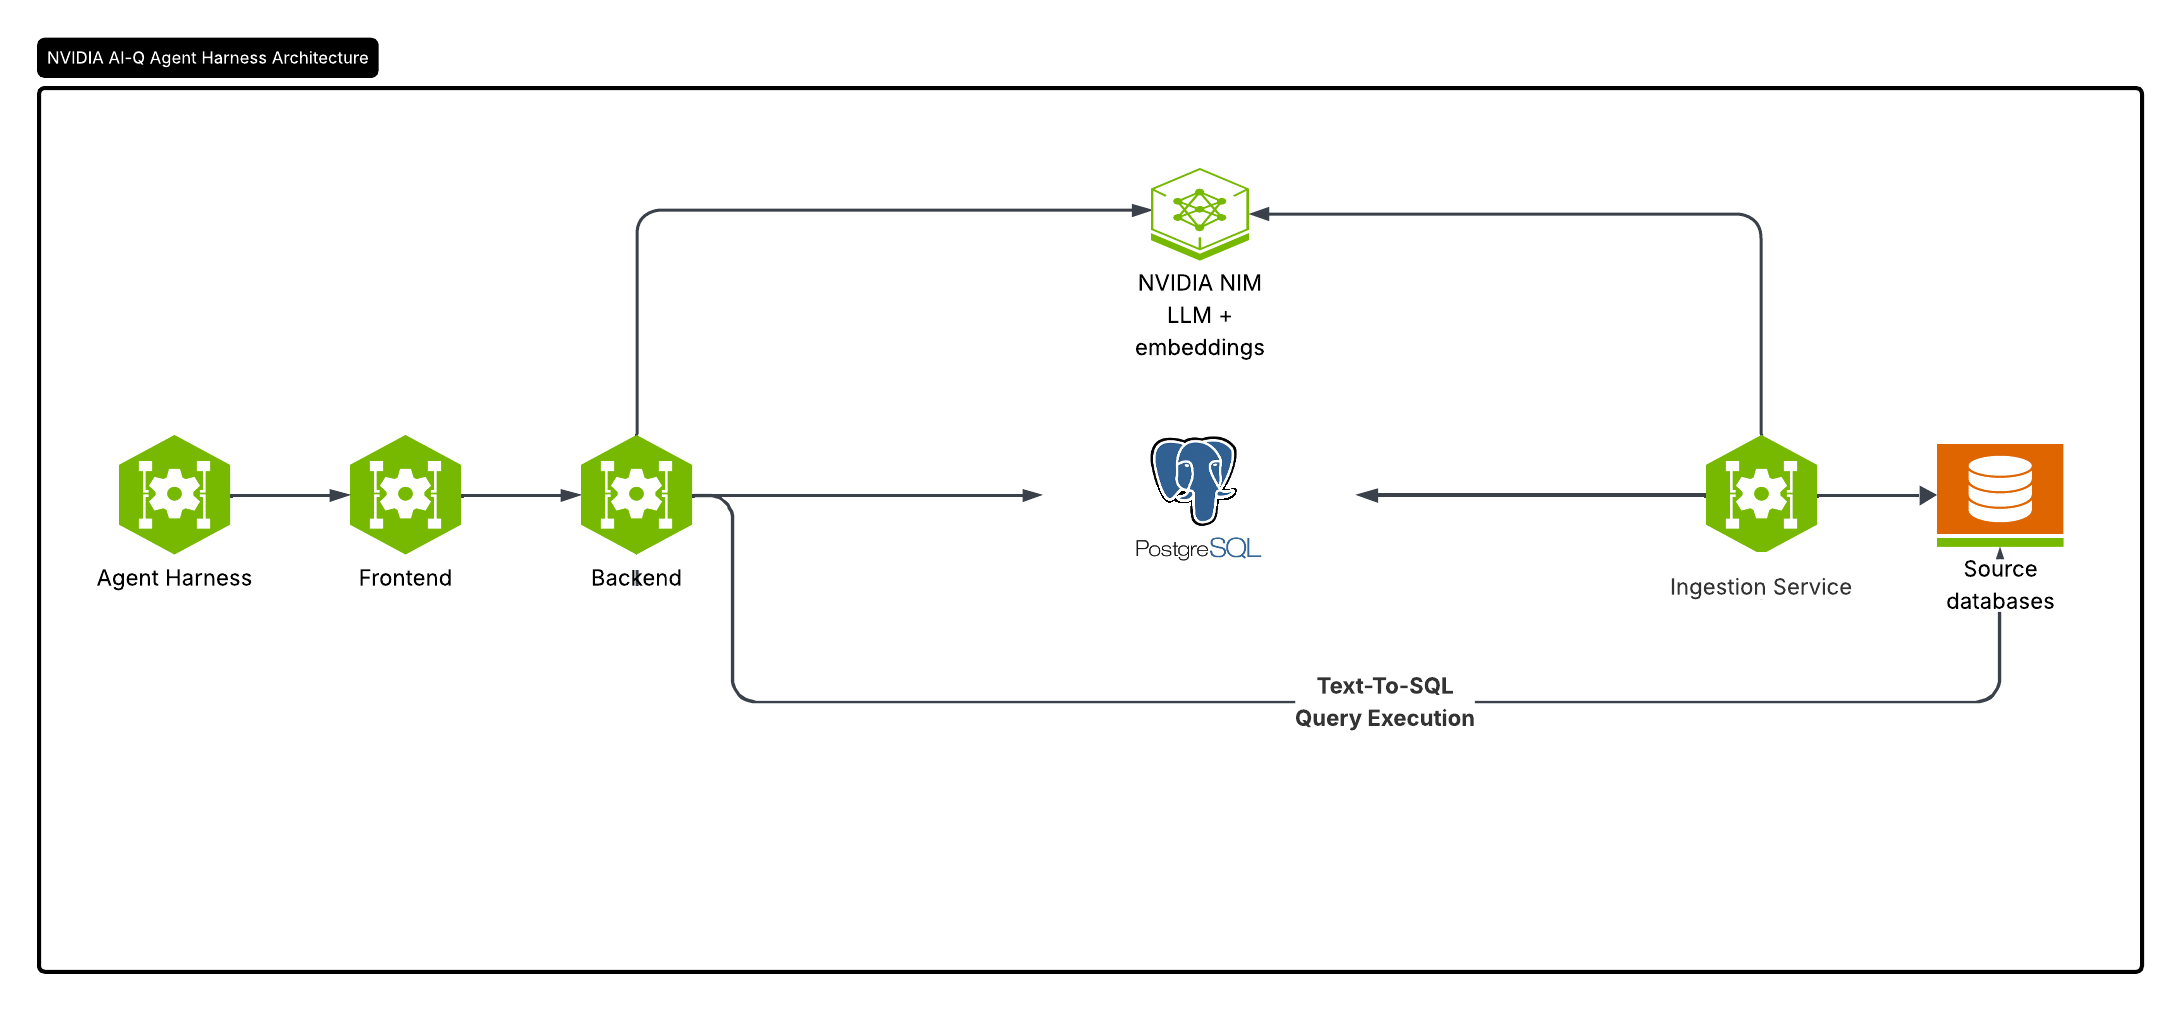
このフレームワークは、FastAPIバックエンド、Next.jsフロントエンド、およびベクトルストレージ用のpgvectorを備えたPostgresデータベースを使用したマルチコンポーネントスタックとして動作します。
信頼性に焦点を当てている一方で、このフレームワークには特定の運用要件と制限があります。ユーザーはSnowflake、Databricks、またはDuckDBなどのソースデータベースの接続文字列を手動で構成し、環境変数を通じてModel Tripletsを管理する必要があります。システムはチャットとデータカタログのためのWeb UIを提供しますが、現在は外部からの貢献を受け付けていないため、その成長はNVIDIAの内部開発に依存します。さらに、このフレームワークはエージェンティックな分析の「信頼性の低さ」を解決することを目指していますが、異種システム間で相反する定義を自動的に調整するために使用される具体的なロジックは、公開リポジトリには完全には詳述されていない内部の実装詳細のままです。システムはModel Context Protocol(MCP)を通じて拡張可能に設計されており、Claude DesktopやCursorのような一般的なエージェントハーネスと統合することが可能です。
証拠: 1. 主要なソース(GitHub - NVIDIA/auto-ontology)は、このフレームワークが企業メタデータから推論レイヤーを構築することで「決定論的なクエリ生成」と「より優れたコンテキスト取得」を可能にすることを確立しています。 2. 主要なソースは、バックエンド用のFastAPI、フロントエンド用のNext.js、および推論のためのNVIDIA NIMとの統合を含む技術スタックについても詳述しています。 3. 主要なソースは、フレームワークが生成されたクエリを認定された定義に対して「検証」し、すべての回答とともにプロバンスを返すことを指定しています。
編集メモ: - evidence_sufficient: true - source_limited: true - submission_only: false - discussion_digest: false - editorial_angle_research: - 質問1: Auto Ontologyは、2つの異なるソースデータベース間の相反するメタデータ定義を具体的にどのように処理しますか? - 回答1: ソースでは「信頼できるビジネス上の意味」を提供するために「システム間での定義を調整する」と記載されていますが、この調整のための具体的なアルゴリズムロジックは提供されたドキュメントには詳述されていません。 - 質問2: 標準的なRAGと比較したAuto Ontologyのtext-to-SQL生成の具体的なパフォーマンスベンチマークは何ですか? - 回答2: ソースではtext-to-SQLベンチマーク(BIRD)に言及し、評価リポジトリへのリンクを提供していますが、主要なドキュメント内に具体的な比較スコアはリストされていません。