コーディングエージェントによってソフトウェア開発のスピードが加速する中、主なボトルネックはコードの記述から、新しいコードがライブ環境で正しく機能するかを検証することへと移行しています。Y Combinatorの支援を受けるスタートアップであるMomenticは、ユーザーがプレーンな英語でユーザーフローを記述できるエージェンティックな品質プラットフォームを提供することでこの課題に対処しています。このプラットフォームは、アプリケーションに対してこれらのテストを実行し、本番環境に到達する前にクリティカルなパスを検証し、リグレッション(退行)を特定します。
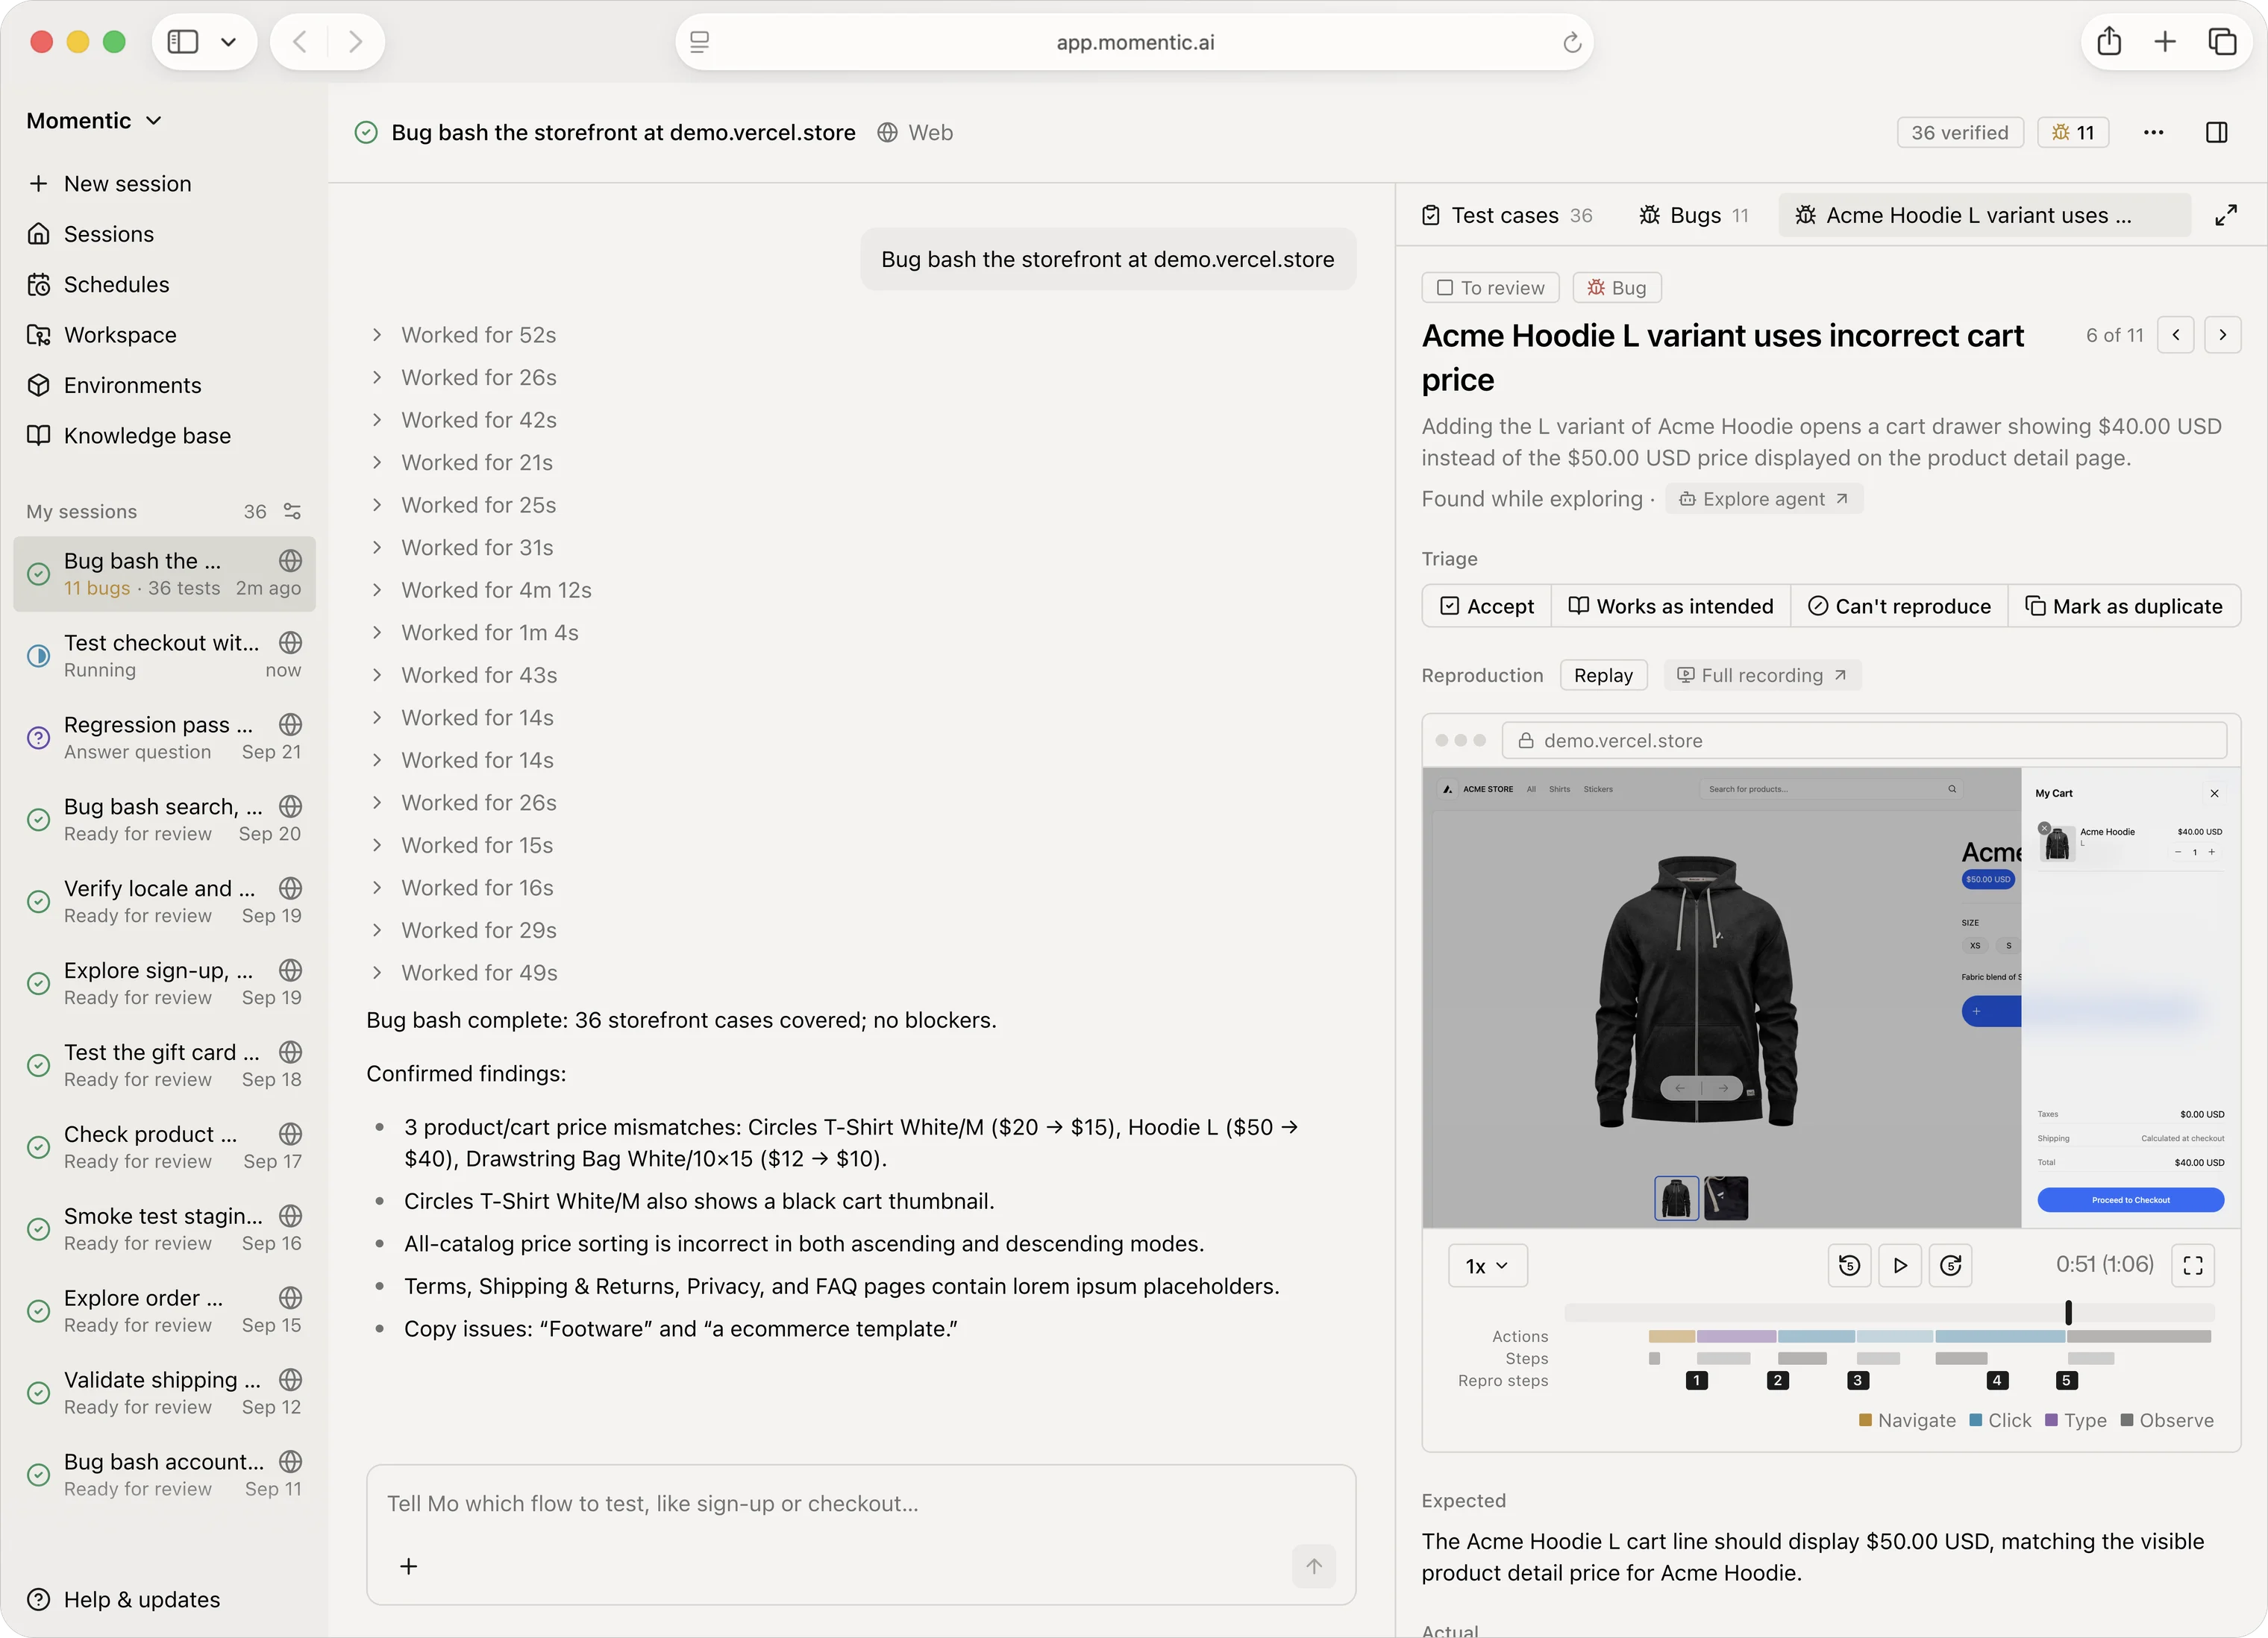
この画像は、ユーザーがフローを記述でき、プラットフォームがリグレッションを特定するエージェンティックな品質プラットフォームを例示しています。
その性能を評価するため、Momenticは「QA Bench」と呼ばれる自社ベンチマークを構築しました。このテストでは、MoをCodex、Claude Code、Devinを含む他の有名なエージェントと対比させ、Gitea、Metabase、Twenty、Saleorという4つの人気のあるオープンソースアプリケーションにわたる1,396件の人手によるラベル付きバグを対象としました。ベンチマーク中、エージェントはアプリケーションのソースコードやインターネットへのアクセスを制限され、ライブUIとのインタラクションに依存することを余儀なくされました。60分間のスイート実行において、Moは269.3件の参照バグを一致させ、次点のCodex(86.3)や最高のClaude Code構成(59.0)を大幅に上回りました。
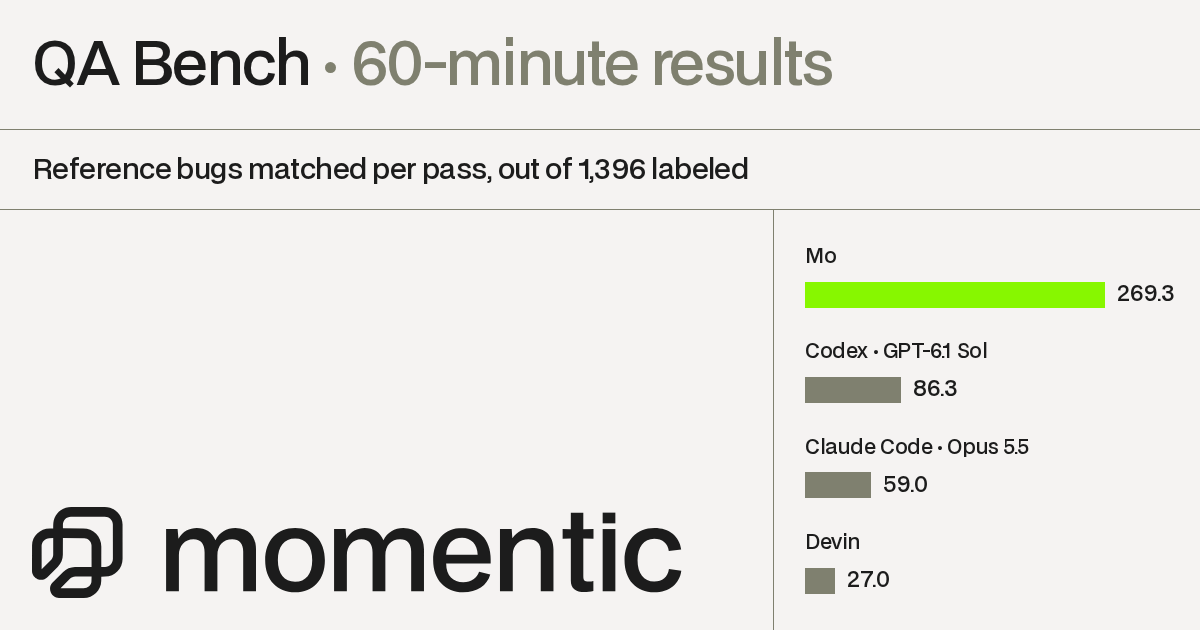
このチャートは、60分間のベンチマークにおける異なるコーディングエージェント間のバグ再現性能の視覚的な比較を提供します。
Moの性能上の優位性は、その特殊なアーキテクチャに由来します。汎用的なコーディングエージェントとは異なり、Moは開発者が製品固有の用語、ビジネスルール、および期待される動作を定義できる「ナレッジベース」を利用します。このコンテキストにより、エージェントはテスト実行中に、より情報に基づいた意思決定を行うことができます。さらに、このプラットフォームは、UIの変更によってテストが破損した際にそれを特定し、テストファイルの修正案を提示する「オートヒーリング」機能を備えています。Moはベンチマークで最高の再現率(19.3%)を達成しましたが、一致したバグあたりのコスト($2.67)は、最も精度の高いCodex構成($0.80)よりも高くなっています。ただし、Claude Code Opus構成($4.09)よりは安価です。
QA BenchはMomenticによって実施された自社評価であるため、その結果はプラットフォーム独自の採点システムの制限を受ける可能性があります。このベンチマークではLLMジャッジを使用してエージェントのレポートをリファレンスセットと照合しており、独立した第三者によるテストと比較してバイアスが生じる可能性があります。さらに、Moは高い再現率を示しているものの、1回のパスでは依然として大部分のラベル付きバグが見つからない状態であり、このエージェントは現時点では網羅的なバグハンティングよりも、優先度の高いリグレッションの特定に適していることを示唆しています。