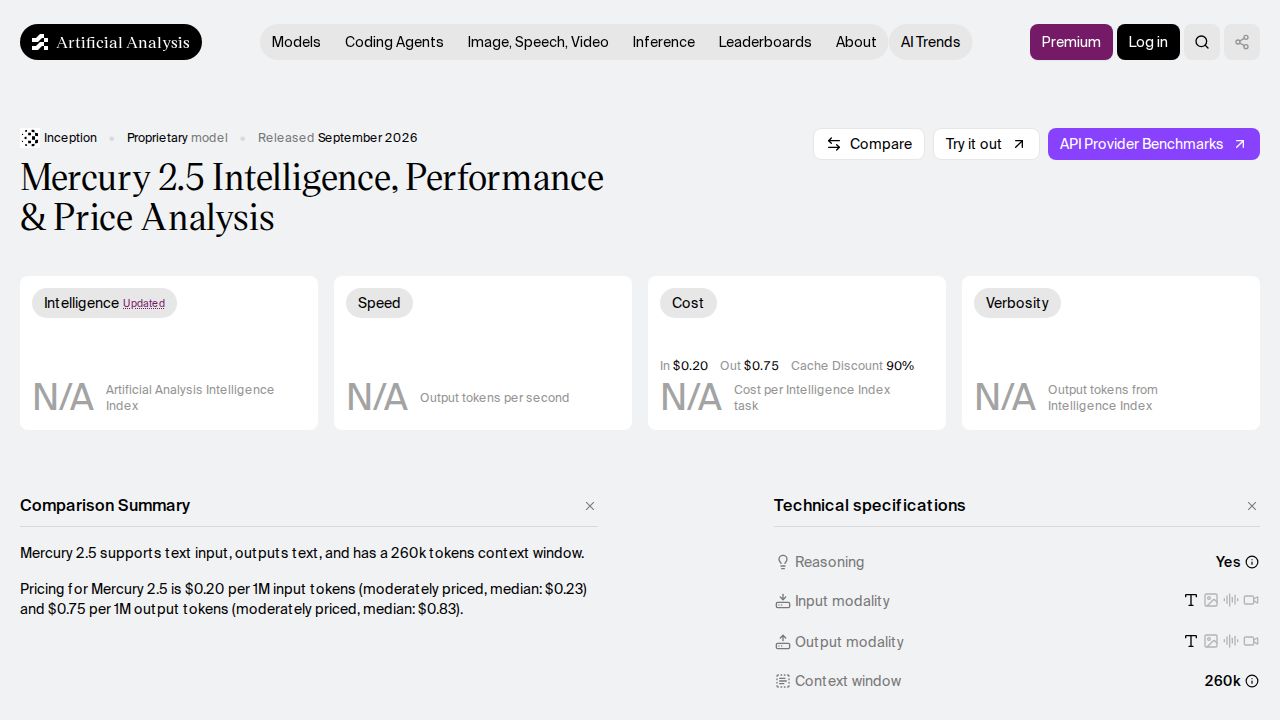
Mercury 2.5は、毎秒770トークンという極めて高い推論速度で注目を集めています。この性能により、リアルタイムアプリケーションにおいて迅速なトークン生成が重要な指標となる大規模言語モデル(LLM)の分野において、高速な選択肢としての地位を確立しました。しかし、このモデルの最大の魅力である「速度」には、認知能力における顕著なトレードオフが伴います。ソースデータによると、Mercury 2.5は知能において「平均以下」と特徴付けられており、GPT-OSS-20Bや様々な14Bパラメータモデルといった、より小型ながら能力の高いモデルよりも性能が劣ることがしばしばあります。
ユーザーや観測者は、正確性よりも速度を優先するモデルの実用的な応用について疑問を投げかけています。あるコメントでは、このモデルの知能は最先端のAI提供モデルよりも大幅に低く、高い速度が推論能力の欠如を補うものではない可能性を示唆しています。また、ツール呼び出しのような複雑なタスクにおけるモデルの苦戦など、具体的な技術的制限も指摘されました。さらに、一部のユーザーはモデルが採用している「diffusion LLM」アプローチに対して懐疑的な見方を示しており、それが知能を犠牲にすることなく速度をさらに向上させることができない状態である「パレートフロンティア」を正しく体現していない可能性を指摘しています。
他の高速な代替モデルと比較すると、Mercury 2.5は厳しい競争に直面しています。例えば、Cerebrasのgpt-oss-120bモデルは毎秒1400トークンの速度に達すると報告されていますが、ツール呼び出しにおいて「壊れている」ことや運用コストが高いことが批判されています。加えて、一部のユーザーはMercury 2.5の価格設定(0.25ドルから0.75ドル)が、より高い知能を維持しながらより安価に提供できるDeepSeek v4 FlashやQwen 3.8-flash-nextといった他のオープンウェイトモデルよりも競争力が低い可能性を指摘しました。これらの要因により、Mercury 2.5が独自のニッチを占めているのか、あるいはその速度が性能の限界によって影を潜めているのかという問いが残されています。