Appleは、キーボードおよびオートコレクトエンジン内において、卑語や機密性の高いコンテンツを管理するために、高度ではあるもののプライベートなシステムを採用しています。このシステムの核となるのはLexicon.frameworkであり、これはシステムの言語データフォルダ内に配置された言語ごとの辞書を管理するプライベートフレームワークです。これらの辞書内の各単語には、2つの32ビットフラグフィールドが関連付けられており、一つは卑語の「階層(tier)」用、もう一つは「トピック」のビットマスク用です。Appleはこれらのフラグに対する公開APIを提供していませんが、プライベートなC関数を介してアクセスすることが可能であり、OSが言語をどのように分類しているかが判明します。
このシステムは、コンテンツを主に3つの階層に区別しています。それは「卑語(vulgar)」(罵り言葉や性のスラング)、「攻撃的(offensive)」(特定の集団に向けられた蔑称)、「機密(sensitive)」(軽い罵り言葉、侮辱、薬物、武器、および身体機能)です。さらに、単語には排泄、身体部位、薬物、政治、宗教など、最大11個のトピックフラグが割り当てられます。例えば、「Trump」という単語は機密階層にフラグが立てられていますが、同時に政治のトピックフラグも保持しています。これらのフラグは独立して機能しており、単語が卑語の階層に割り当てられていなくてもトピックフラグを持つことがあり、これはランキングエンジンに対して、その単語を慎重に扱うよう促すヒントとして機能する可能性があります。
これらのフラグとユーザーの意図のバランスを取るため、macOSは`~/Library/Keyboard/VulgarWordUsage.db`にローカルのSQLiteデータベースを維持しています。このデータベースは、システムによってすでに卑語として特定されている単語の使用状況を追跡し、アプリケーションごと、および受信者ごとの使用回数を記録します。その目的は、キーボードにユーザーの習慣を「学習」させることにあります。例えば、メッセージングアプリで親しい友人に罵り言葉を使う可能性があることを認識しつつ、同僚へのメールを書く際には「クリーン」な代替案を提示するように誘導するのです。しかし、このデータがどのように入力されるかの正確なメカニズムは、ある程度不透明なままです。いくつかのテストでは、標準的なテキスト入力によってデータベースに新しいエントリが生成されなかったことから、記録は特定のアプリや設定に制限されている可能性が示唆されています。
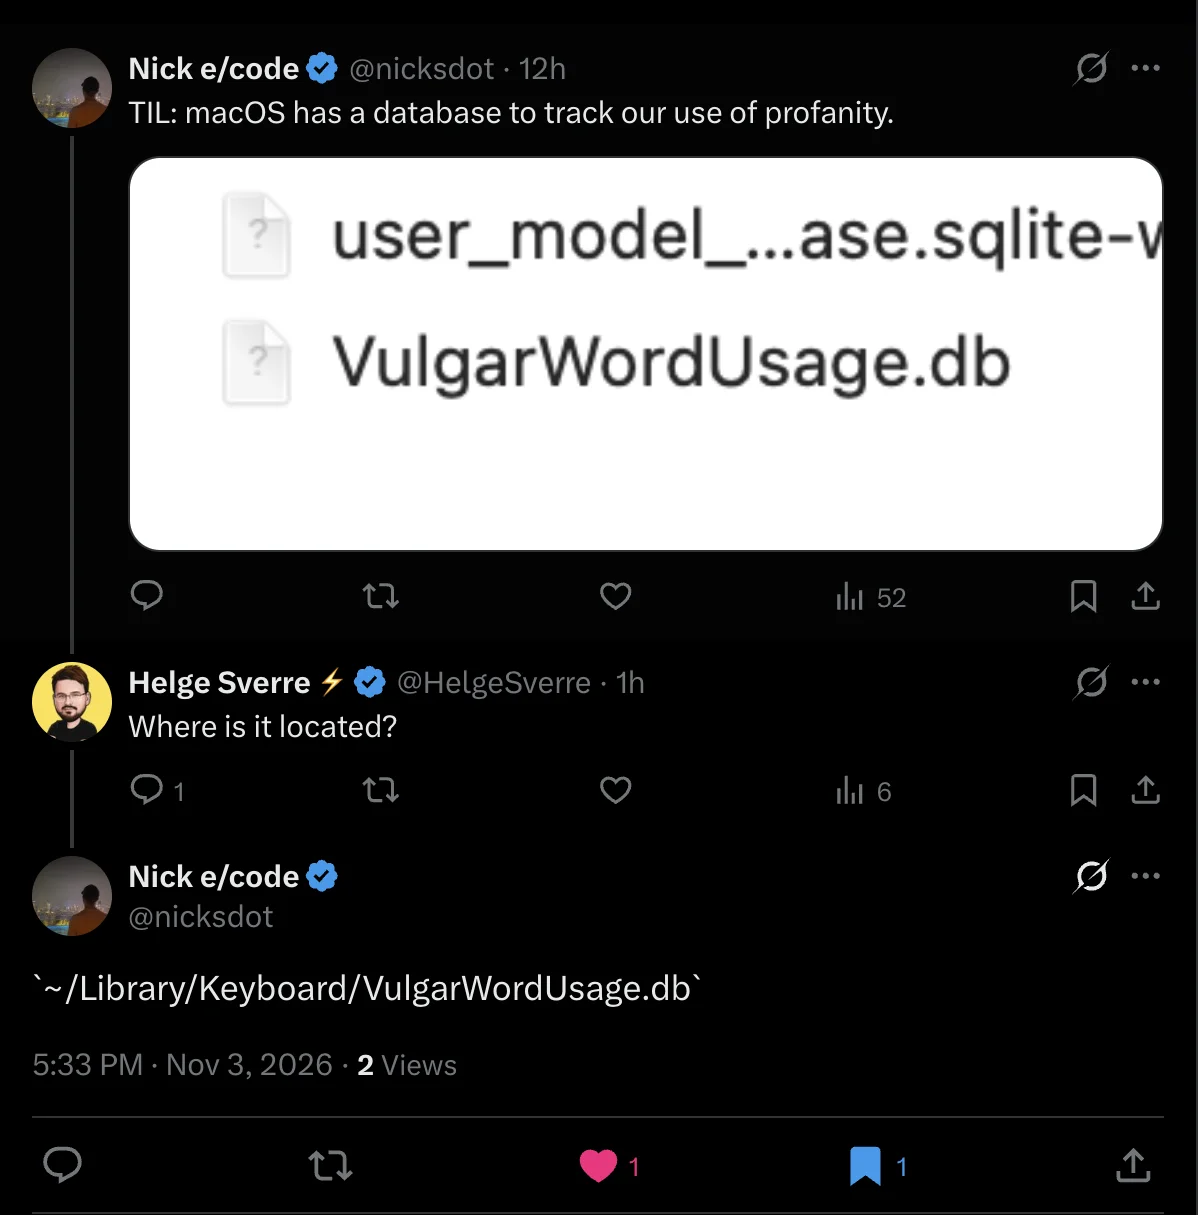
画像は、記事内のローカル単語追跡に関する議論で言及されている特定のファイルパスとデータベース名を示しています。
これらのフレームワークはプライベートであるため、これらの分類を決定するために使用される特定のロジックに関する公式なドキュメントは存在しません。ダンプの結果は、一部のエントリがルールベースではなく、手動で選別されているように見えることを示しています。例えば、「Oedipus」が卑語階層に含まれていたり、「niggardly」が攻撃的階層に含まれていたりするケースです。これは、Appleが純粋なアルゴリズム的アプローチよりも、たとえそれが言語的な奇妙さや、一般的な名前や用語の主観的な分類を招くことになったとしても、キュレートされた「安全な」オートコレクト体験を優先しているというトレードオフを浮き彫りにしています。システムの最終的な目標は、ユーザーが卑語を入力した際に、ユーザーがその特定の文脈でそれを使用するパターンを確立している場合にのみ、キーボードがそれを提案するようにすることです。