OpenAIの開発ペースが加速するにつれ、同社のモノレポは重大なスケーリングの課題に直面しました。Codexやその他のAIツールの統合により、エンジニアはより多くの作業を並行して実行できるようになり、研究ジョブやCI環境からの同時プッシュ、マージ、フェッチが急増しました。これらの需要は最終的に既存のソース管理システムの限界を招き、フェッチの遅延やマージの失敗によって、信頼性が時折90%を下回る事態が発生しました。この問題に対処するため、OpenAIのエンジニアは、人間のエンジニアとAIエージェントの両方が同時にコードベースを操作する「エージェント規模」の作業を処理するために設計された、Gitリポジトリのための新しいバックエンド「Pando」を構築しました。
Pandoはユーザーに対して透明に設計されており、エンジニアが既存のGitワークフローやツールを変更することなくモノレポを支えます。このシステムは、従来のGitサービスの2つの主要な制約を再考することで水平スケーラビリティを実現しています。第一に、ブランチへの更新を独立して調整します。多くの標準的なシステムでは、リポジトリへのすべての書き込みに対して単一の順序が課されるため、あるブランチへのプッシュが、無関係な別のブランチへのプッシュを待つことになります。Pandoはこのボトルネックを取り除き、無関係なブランチを並行して更新できるようにします。第二に、Pandoは異なるクライアント間で「パックファイル」(複数のオブジェクトのためのGitの圧縮形式)を再利用することで、読み取りスループットを最適化します。フェッチのたびに固有のパックファイルを生成する代わりに、サーバーは同じバイトを複数のクライアントに提供し、CPUとディスクI/Oを大幅に削減します。
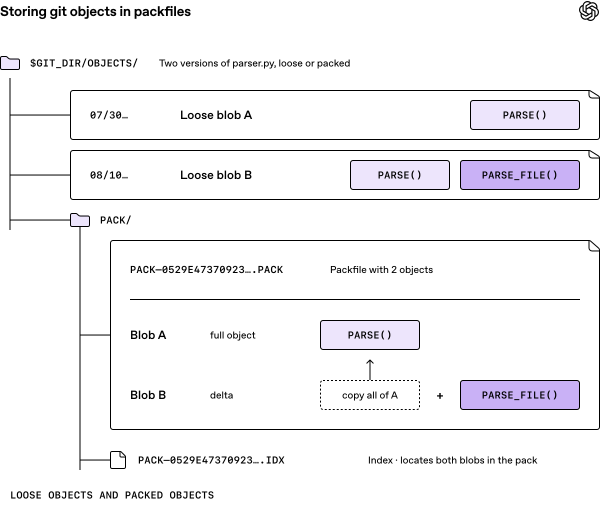
この記事では、Pandoが複数のオブジェクトのためのGitの圧縮形式であるパックファイルを再利用することで、読み取りスループットをどのように最適化するかを説明しています。
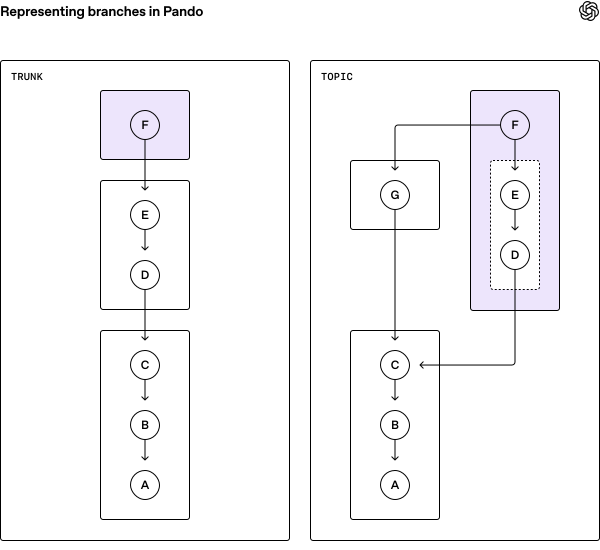
この記事では、Pandoがブランチへの更新を独立して調整することで、従来のGitサービスにおけるボトルネックをどのように取り除くかを説明しています。
このスケールを実現するために、Pandoは「因果一貫性」モデルを採用しており、これにはリポジトリ全体の状態に関する特定のトレードオフが含まれます。Pandoはブランチを独立して調整するため、リポジトリ全体にわたるすべての参照の単一で一貫した時点のスナップショットを提供しません。例えば、クライアントがフルクローンを実行している間に2つの異なるブランチが更新されている場合、それらが技術的に「同時」に更新されたとしても、クライアントは一方のブランチをバージョンA、もう一方をバージョンBとして見る可能性があります。しかし、Pandoは個々の参照に対して直列化可能性を維持し、単一のブランチへの更新が一貫性を保つことを保証します。本番環境において、このアーキテクチャは中央値のプッシュレイテンシを約5倍削減し、現在は1日あたりほぼ1ペタバイトのGitデータを処理しています。このシステムは高いスループットを提供していますが、現在システムを利用しているAIエージェントの具体的な数は公表されていません。