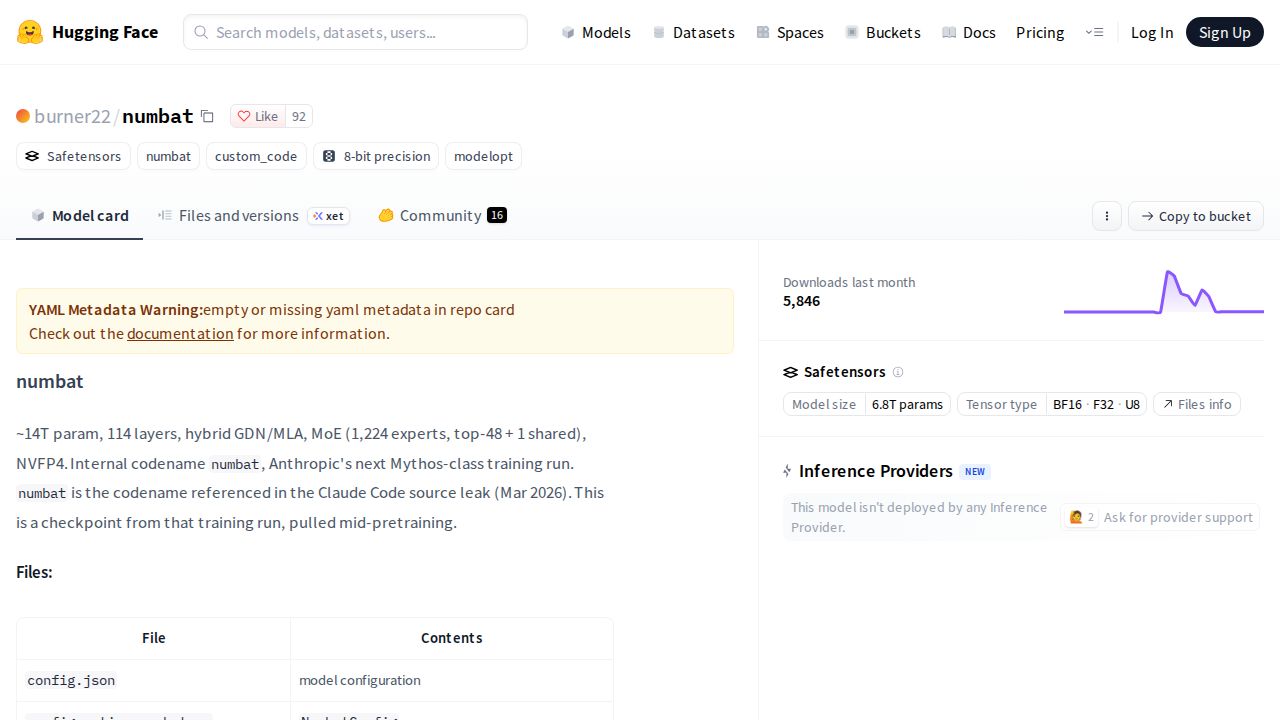
ユーザー「burner22」によるHugging Faceのリポジトリが登場し、そこには「numbat」というコードネームの巨大規模モデルがホストされているとされています。このリポジトリには、Anthropicの次世代Mythosクラスのトレーニング実行と説明されるチェックポイントが含まれています。「numbat」というコードネームは、2026年3月のClaude Codeに関連する以前の情報漏洩で特定されたと主張されており、そこでは設定ファイルのコメントに、開発者に対して「numbat」のローンチ前に特定のセクションを削除するよう指示する内容が含まれていました。
このリポジトリには、合計約7.72 TBに及ぶ772個のテンソルデータシャードを含む、膨大な量の技術データが含まれています。モデルアーキテクチャは、ハイブリッドのGated DeltaNet (GDN) と Multi-head Latent Attention (MLA) スタックとして説明されており、1,224の専門家(experts)を持つMixture-of-Experts (MoE) フィードフォワード層を利用しています。また、リポジトリにはPythonによるリファレンス実装も含まれており、`trust_remote_code=True` を指定して `AutoModelForCausalLM.from_pretrained` メソッドを使用することで、モデルをロードして実行することが可能です。重みは量子化されたNVFP4形式で提供されており、アップローダーは、これが評価チームによってフルトレーニングクラスターではなく、より小さなハードウェアスライスでチェックを実行するために使用されているものであると主張しています。
決定論的なテンソルカウントやシャード間での内部的な一貫性など、ファイルの技術的な整合性は保たれているものの、この流出の真正性はAnthropicによって確認されていません。アップローダーは、これが196万ステップの実行のうちのステップ1,830,000における事前学習の中間チェックポイントであり、ポストトレーニングや人間からのフィードバックによる強化学習(RLHF)を受けていないことを指摘しています。提供されたスクリプトを通じて技術的に実行可能ではありますが、7.72 TBのテンソルデータを処理するには膨大なハードウェアリソースが必要であり、これはモデル開発の未完成で生の状態を表しています。