デモシーンは、ファイルサイズの制限やハードウェアの制約といった厳格な技術的制約の中で、コンピュータグラフィックスやオーディオの限界を追求することに焦点を当てたサブカルチャーです。プラットフォームDatavorousのエンジニアによる最近のプロジェクトでは、プログラミング言語の「生産的」な性質をナビゲートするために機械学習を活用し、この領域を探索しています。Dwitter.netで公開されている140文字のJavaScriptデモであるDweetsの特異なコードゴルフ・構文を言語システムとして扱い、著者は自己回帰モデルを使用して未完成のコードの妥当な続きをサンプリングし、クリエイティブ・コーディングのための「オートコンプリート」を実質的に構築しようと試みました。
これを実現するために、開発者はQwen2.5-Code-7Bをベースモデルとして使用しました。Dweetsは標準的なプログラミングとは異なる数学的な略記やコードゴルフのテクニックに大きく依存しているため、ベースモデルは当初、その構文に苦戦しました。著者はDwitter APIを通じて取得した25,000件のDweetsデータセットに対して継続的な事前学習(CPT)を実施しました。このプロセスにより、モデルの「surprisal(トークンに割り当てられる負の対数確率)」が大幅に減少し、保持されたDweetsのパープレキシティは28.63から8.57へと低下しました。これは、モデルがDwitterエコシステムの特定の慣習や構造を正常に内面化したことを示しています。
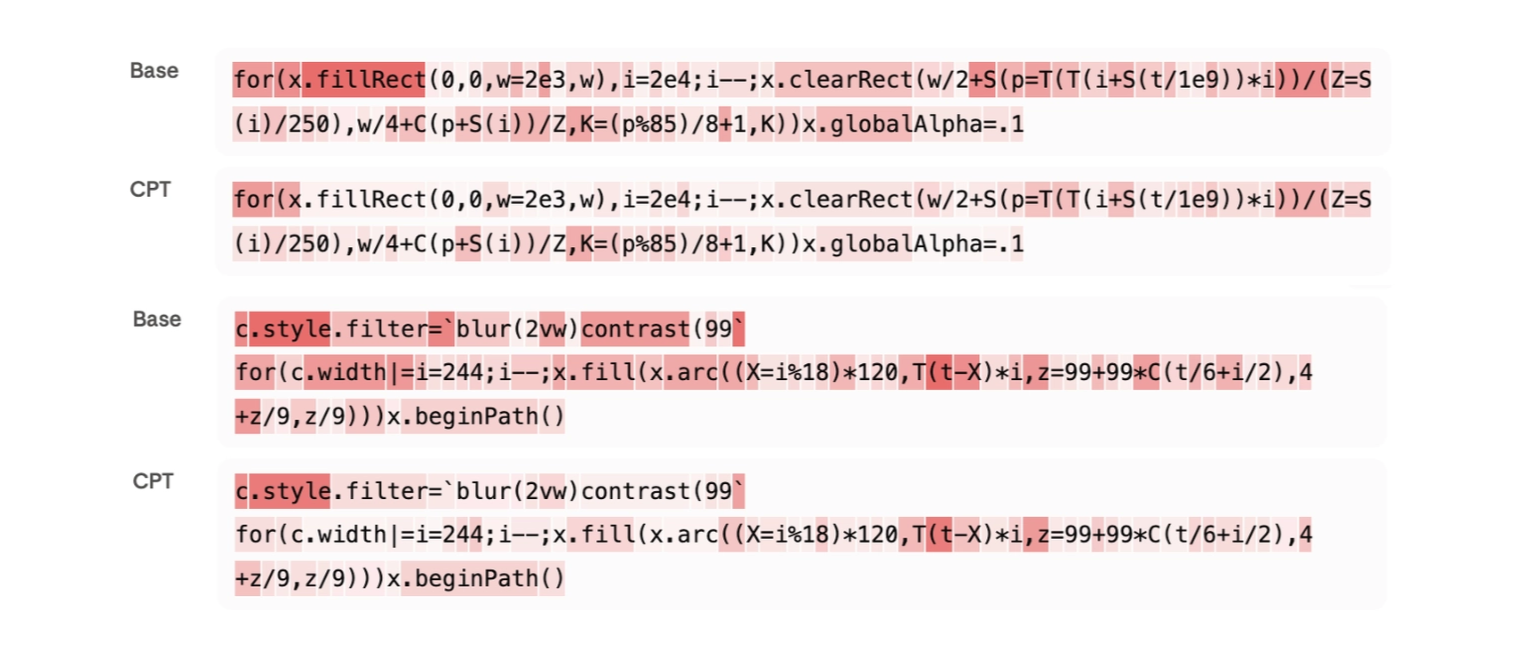
この図は、Dweetsデータセットに対する継続的な事前学習によって達成された、パープレキシティとsurprisalの大幅な減少を例示しています。
単なる構文的な正しさから審美的な品質へと移行するために、著者はカリキュラム学習戦略を導入しました。Dwitterの内部的な「awesomeness」スコアを使用し、トレーニングプロセスにおいて上位ランクのプログラムに段階的に重み付けを行い、最終的にはサンプリング確率の約67%を最も評価の高い上位1,000件のDweetsに割り当てました。これに続いて、GRPOアルゴリズムを用いた人間からのフィードバックによる強化学習(RLHF)が行われました。著者が報酬関数として機能し、約40,000件のアニメーションを手動で検査・ランク付けすることでモデルのポリシーを洗練させました。最終的な成果は、単一のコードの接頭辞から複数の視覚的な続きを生成できるツールであり、デモシーンの空間において異なる芸術的な方向へと分岐し、探索する手段を提供します。
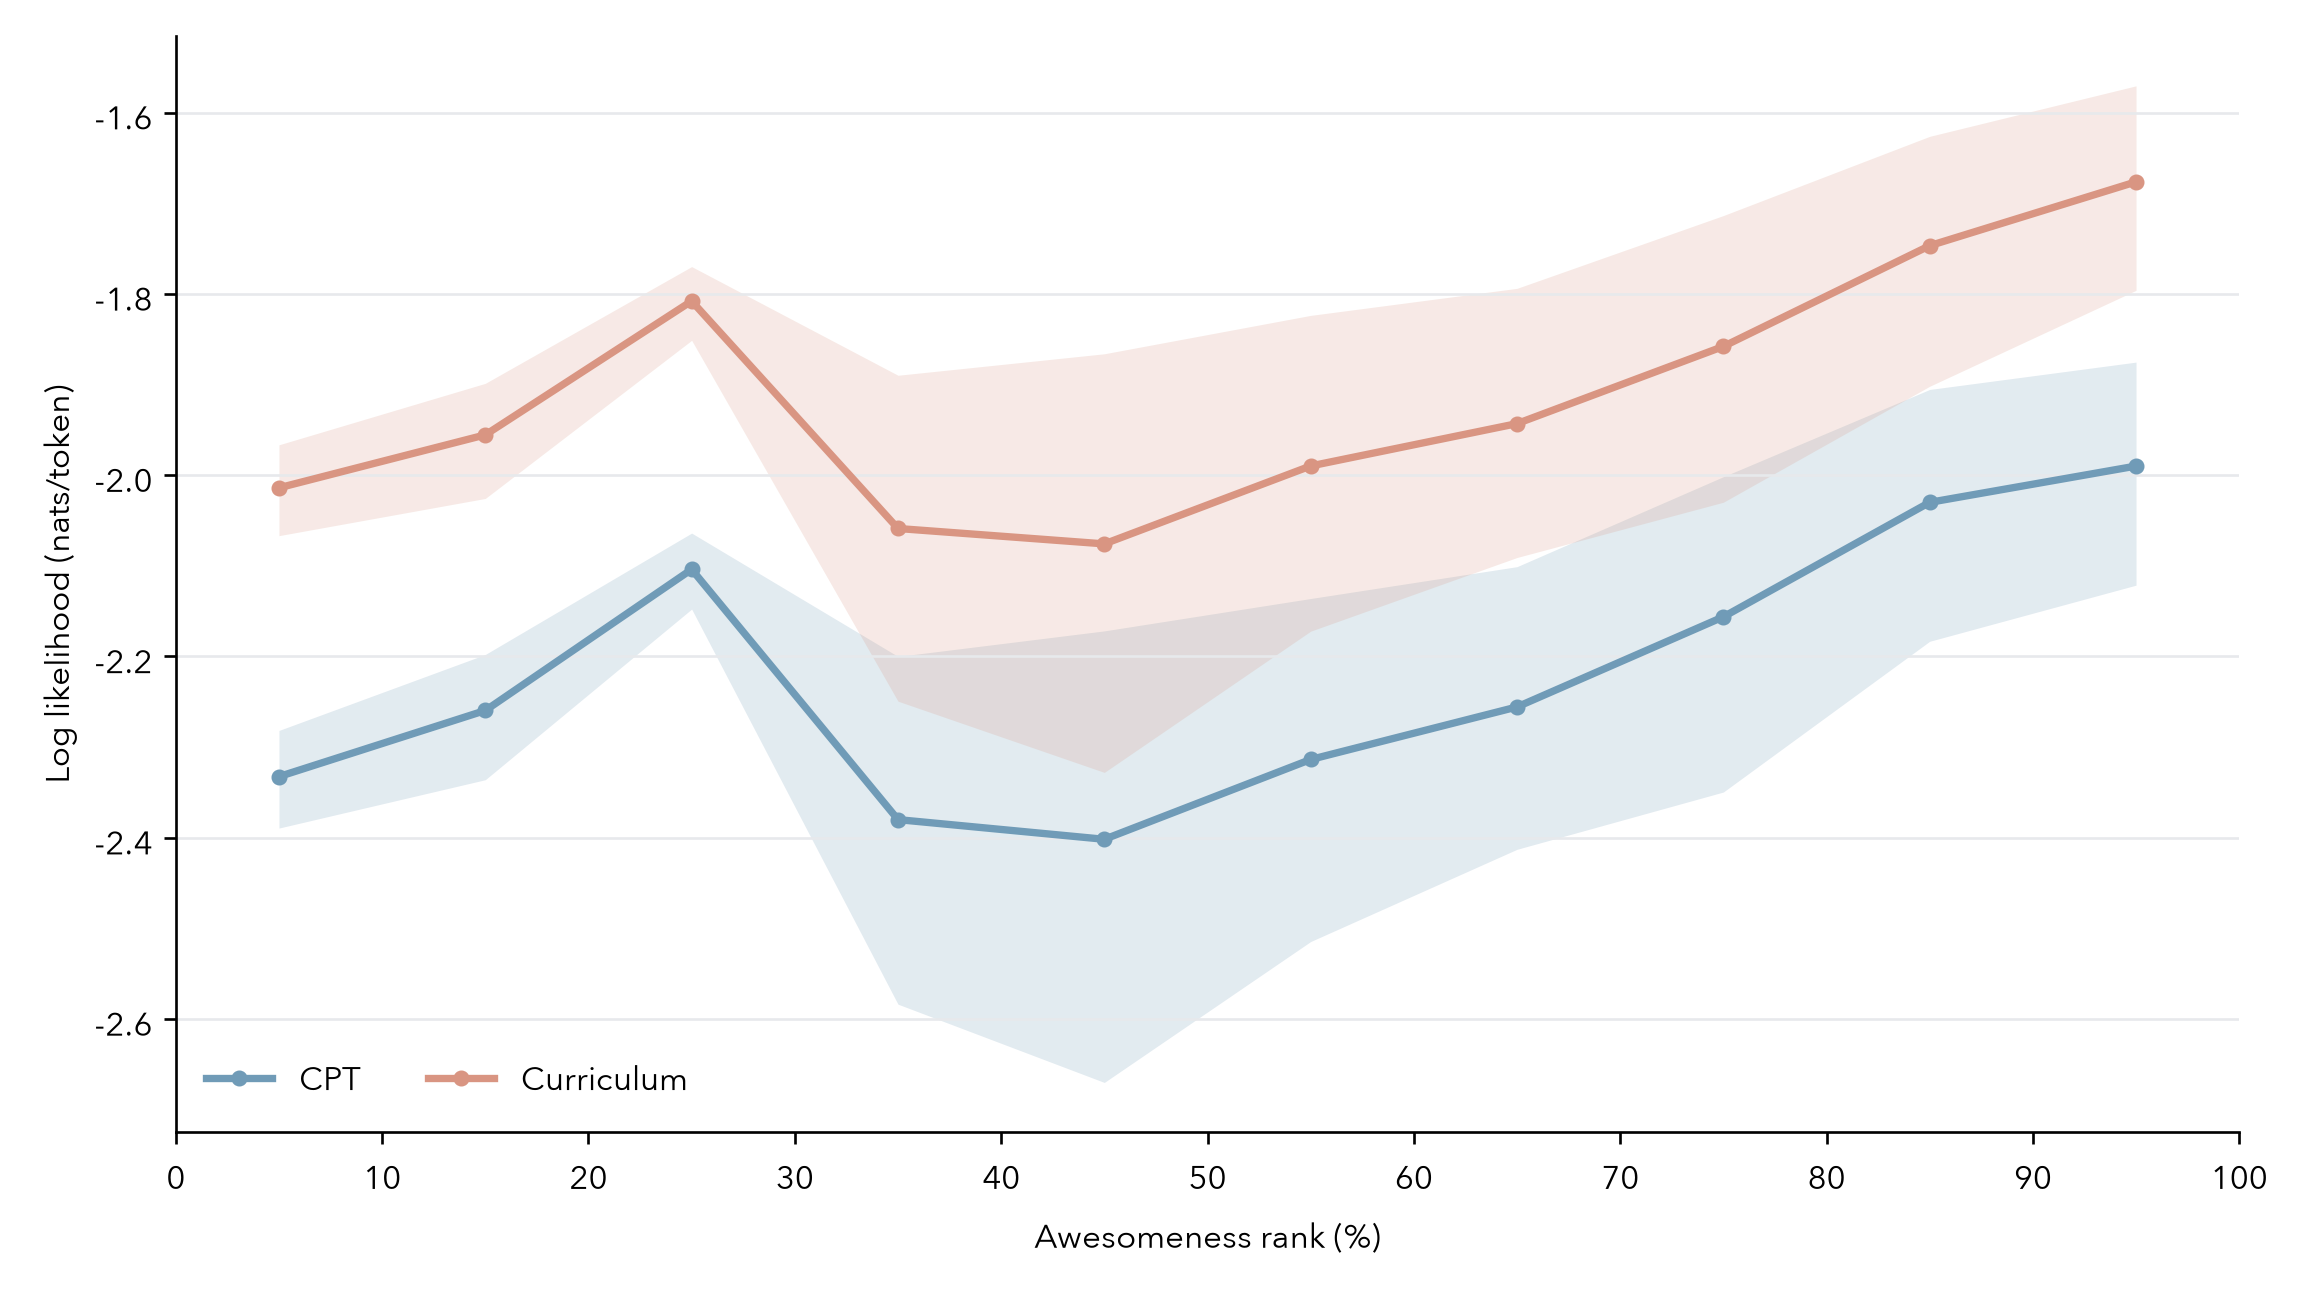
このチャートは、トレーニング戦略がさまざまな人気層にわたって高品質なコードを生成するモデルの能力にどのように影響を与えたかを視覚化しています。
モデルは「美しい」コードの出現確率を向上させることに成功しましたが、著者はその利得がカリキュラム段階では一度も見られなかったawesomenessランクを含むすべてのランクに分散していると指摘しました。このプロジェクトは、純粋に機能的なコード生成から、モデルが創造的なプロセスの共同パートナーとして機能する審美的な合成への移行を強調しています。著者は、さらなる探索のために「Demoscener-7B」モデルと関連するデータセットをHuggingFaceで公開しました。
このアプローチの制限の一つは、報酬関数の主観的な性質です。著者の個人的な好みがRLHFを通じてモデルに注入されましたが、第三者によるブラインドの嗜好テストの結果、モデルの出力は好意的であることが確認されたものの、「正しい」審美眼は常に変化する目標であり続けています。さらに、モデルがDwitterのJavaScript環境の特定の癖に依存しているため、その創造的な出力は現在、その特定のプラットフォームの制約と能力に縛られています。
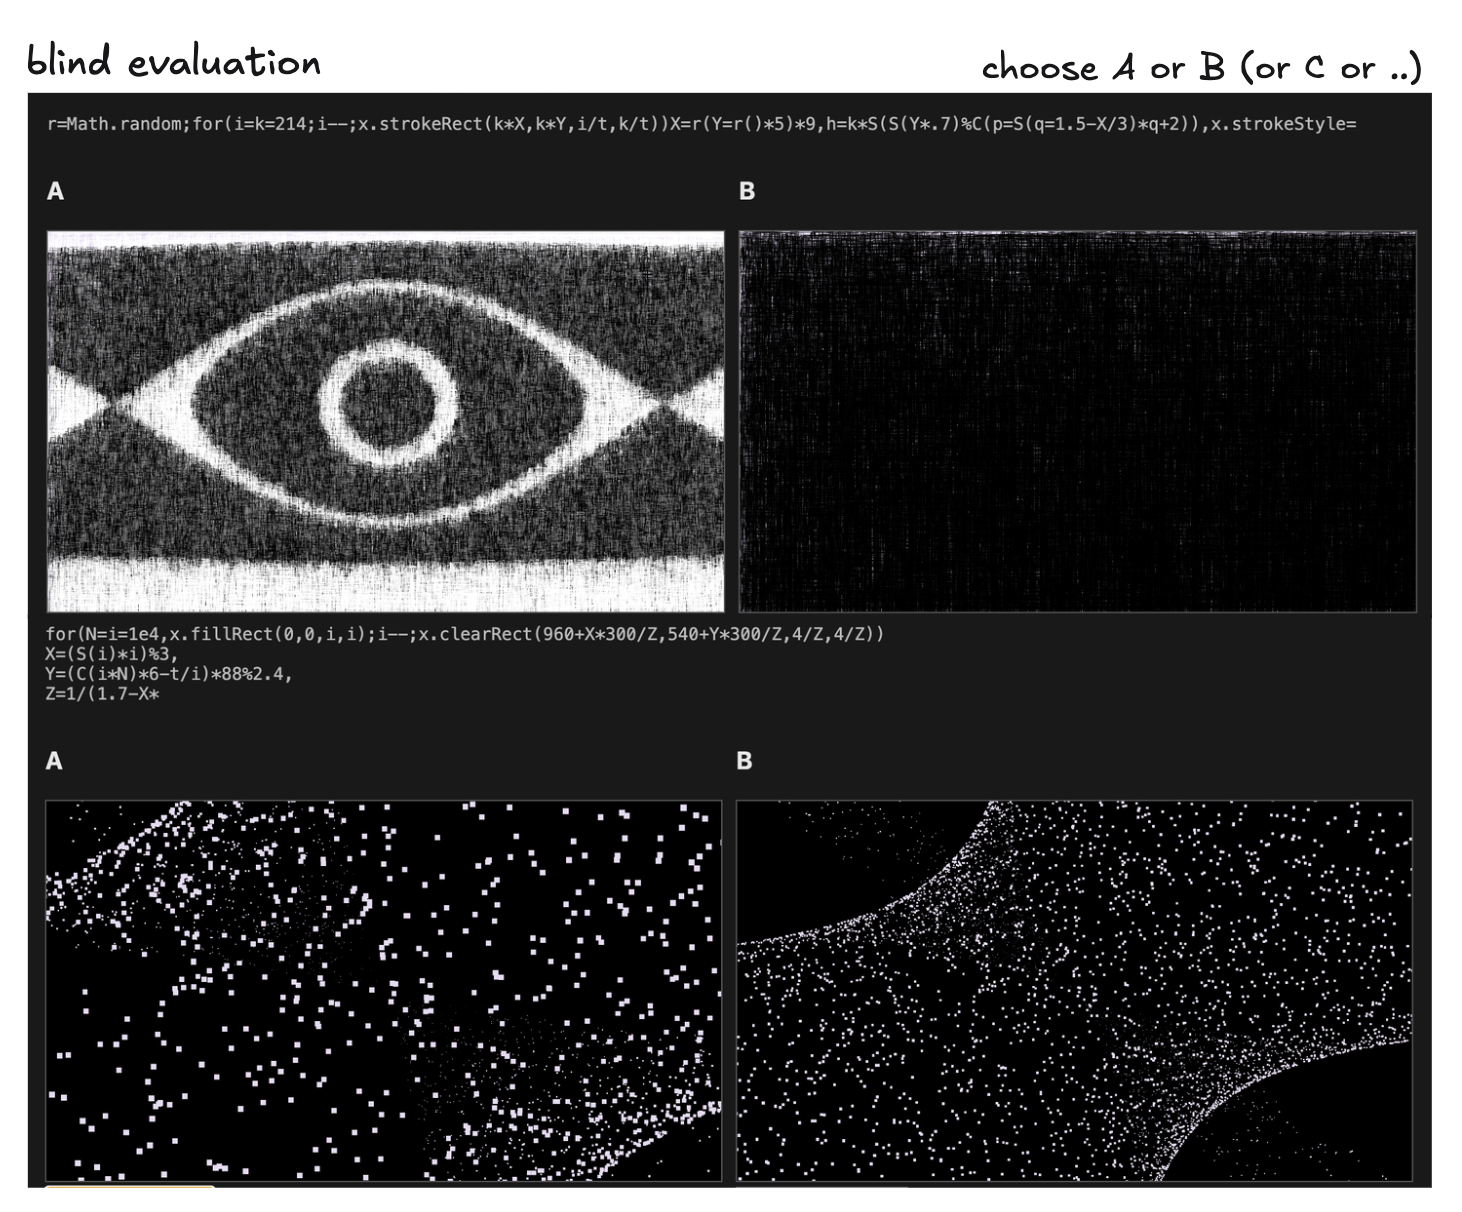
このチャートは、人間によるフィードバックとカリキュラム学習が、モデルを好ましい審美性へと正常に導いたことの証拠を提供しています。
最終的に、このプロジェクトは、特化したデータセットと人間によるフィードバックを組み合わせることで、大規模言語モデルをニッチで高度に制約された創造的領域へと導けることを示しています。コードを生産的な言語として扱うことで、著者は複雑なコードゴルフ・デモを完成させるという技術的課題を、AIが次の可能な視覚的分岐を提案し、人間のクリエイターが最終的な出力をキュレートして洗練する探索的なプロセスへと変貌させました。