『ザ・レジェンド・オブ・ザナドゥ』のファン翻訳の完成には10年以上を要しました。その理由は、ゲームエンジンが実行コードとテキスト文字列を「無秩序に」混在させて構築されており、PCエンジンライブラリの中でも最もハックが困難なタイトルの一つであったためです。2011年に始まったこのプロジェクトでは、英語を一行挿入する前に、ゲームのスクリプトをデコンパイルおよび再コンパイルするための完全に新しいツールを構築する必要がありました。
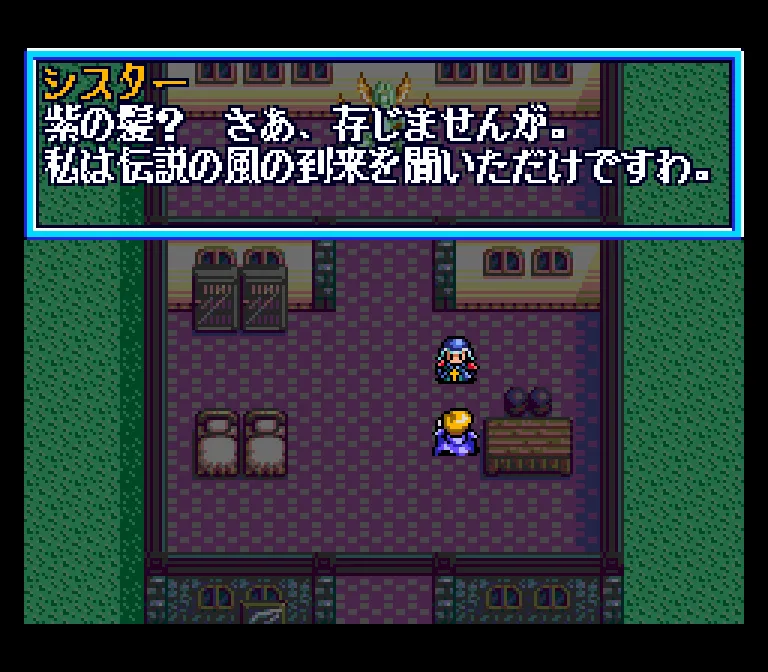
この画像は、15年にわたる翻訳プロジェクトが始まる前のオリジナルのゲームの状態を示しています。
非標準的なエンジンの克服
多くのPCエンジン用RPGがテキストをメモリ上の大きな独立したブロックに保存していたのとは異なり、『ザ・レジェンド・オブ・ザナドゥ』はスクリプトがアセンブリ言語の関数と混在する複雑な構造を使用していました。これは、単にテキストブロックを見つけて置き換えるだけでは、ゲームの実行が壊れてしまうことを意味していました。
HN Digestによる図表(readonlymemo.comの報告数値に基づく。数値は原文のまま表示)。
この問題を解決するため、引退したプログラマーのElmer氏が完全なスクリプトデコンパイラと対応する再コンパイラを開発しました。これらのツールにより、チームは実行コードからスクリプトデータを分離することができ、ゲームエンジンをクラッシュさせることなくテキストを修正することが可能になりました。
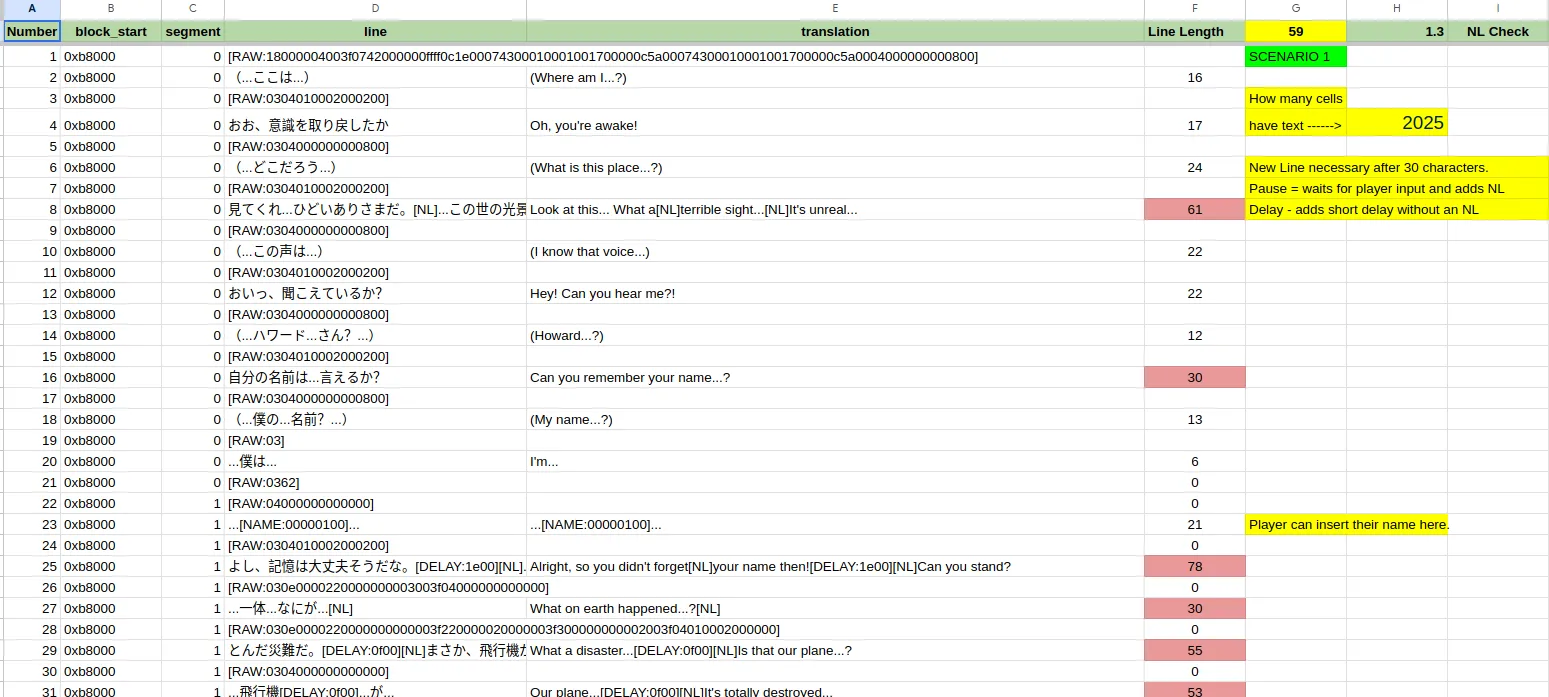
この画像は、実行コードから分離するためにカスタムデコンパイラを必要としたスクリプトデータの視覚的な例を提供しています。
「全体がアセンブラで組み立てられたように見えます。そのため、コードと文字列が無秩序に混在しているのです。」
— Finding Xanadu: Inside a JRPG classic translation 15 years in the making
メモリ管理と圧縮
英語の翻訳は、元の日本語テキストよりも大幅に多くのスペースを必要とすることがよくあります。このプロジェクトでは、一部の英語セグメントが元のスクリプトよりも最大50%も膨大になり、PCエンジンの限られたハードウェアにおいて深刻なメモリ不足を引き起こしました。
Elmer氏は、オリジナルの開発者が使用したものよりも効率的なカスタム圧縮手法(SWD5)を実装することでこの問題に対処しました。ゲームのデータブロックを再圧縮することで、チームは拡張された英語の対話を収容するのに十分な「貴重な」スペースを確保しました。
字幕による回避策
このゲームには、付随するテキストがない音声付きカットシーンが含まれており、翻訳者にとってジレンマを生み出しました。完全な英語吹き替えが理想的な解決策ではありましたが、チームはプロジェクトを完了させるために十分な数のボランティア俳優と調整することが技術的に困難であることを発見しました。
チームは最終的に「ハード」な技術的解決策を選択しました。彼らは、ゲームのVRAMにスプライトを表示するために使用できる未使用のパレットエントリがあることを発見しました。彼らはこれらのエントリを使用して字幕を表示しましたが、これにはテキストが日本語の音声と同期して表示されるように、チームが手動でフレームを数え、カットシーンのタイミングを再調整する必要がありました。