Figmaは、反復的なデザイン作業の細かなニュアンスに対応するため、AI戦略を事後トレーニングの特化へとシフトさせています。最先端のモデルは広範なタスクを実行可能ですが、ボタンの間隔の調整、特定の色の変更、あるいはフィードバックに基づくレイアウトの再構成など、デザイナーが日々行うような小さく検証の難しい編集では苦戦することが多々あります。これを解決するため、Figmaは、Figmaの内部構文やデザインシステム資産を理解するように特別にトレーニングされたファーストパーティの編集モデルを使用するデザインエージェントを開発しました。これにより、エージェントは、デザイナーのワークフローを維持するためにスピードと正確性が極めて重要となるキャンバス上で、直接精密な反復処理を実行できるようになります。
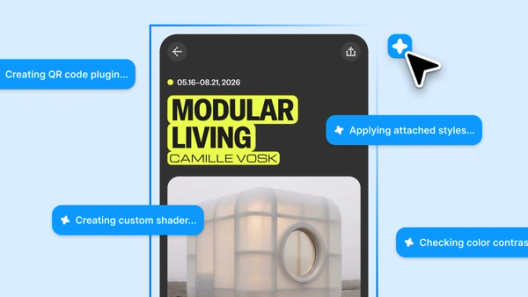
この画像は、間隔や色の調整など、デザインエージェントがキャンバス上で直接精密な反復処理を実行する能力を説明しています。
このアプローチの技術的な核心は、Figmaのネイティブファイル形式を使用した教師あり微調整(SFT)にあります。デザインをネイティブ構造で表現することで、モデルはキャンバスに直接適用可能な変更を生成することを学習します。Figmaは、より大きな「教師」モデルが編集を試行し、それを決定論的なバリデーターと視覚的モデルジャッジがチェックする「自己修復型」生成パイプラインを構築しました。もし編集が、テキストの重なりやアイコンのクリッピングなどのチェックに失敗した場合、パイプラインは評価者のフィードバックを使用して出力を修正します。この手法により、25万件以上の例でトレーニングされた初期のLlama 3.3 70Bモデルは、特定の編集タスクにおいてトップクラスのモデルに匹敵する性能を発揮するようになりました。
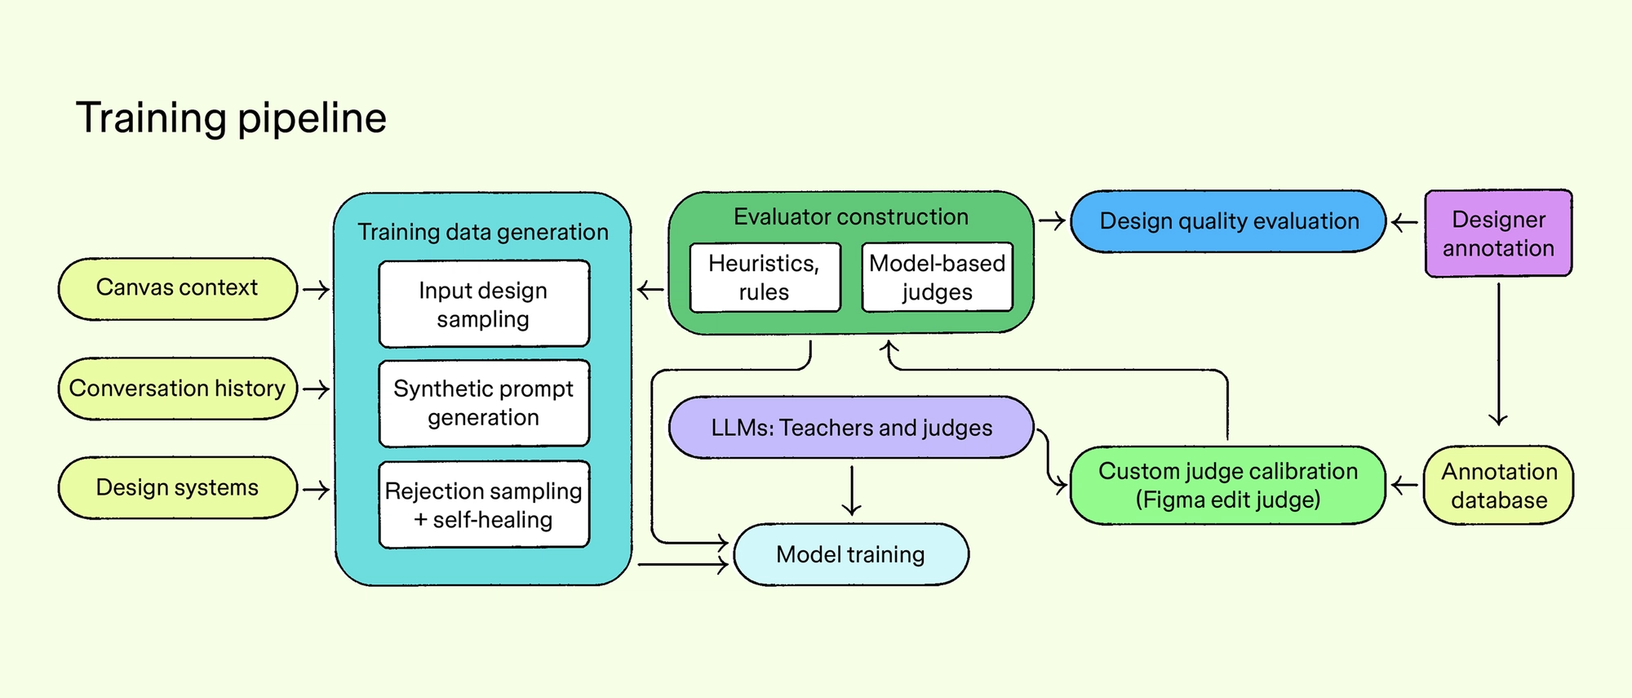
この図は、自己修復型生成パイプラインや評価者の構築を含む、このアプローチの技術的な核心を説明しています。
しかし、FigmaはSFTだけでは限界があり、特に「模倣学習」に関して、モデルが汎用性を犠牲にしてトレーニングデータを過度に模倣してしまう可能性があると指摘しています。これに対抗するため、同社はトレーニングレシピに強化学習(RL)を統合しています。この移行は、トレーニング例の多様性を高め、実際のデザイナーの優先事項を反映した専門家による基準に基づいて報酬モデルを形成することに焦点を当てています。初期の結果は、この特化型アプローチが有効であることを示しています。直接比較テストにおいて、新しいエージェントは以前のプロダクションバージョンを62%の確率で上回るか同等の性能を達成し、同時にメッセージあたりの平均コストを削減し、典型的なタスクの速度を約20%向上させました。
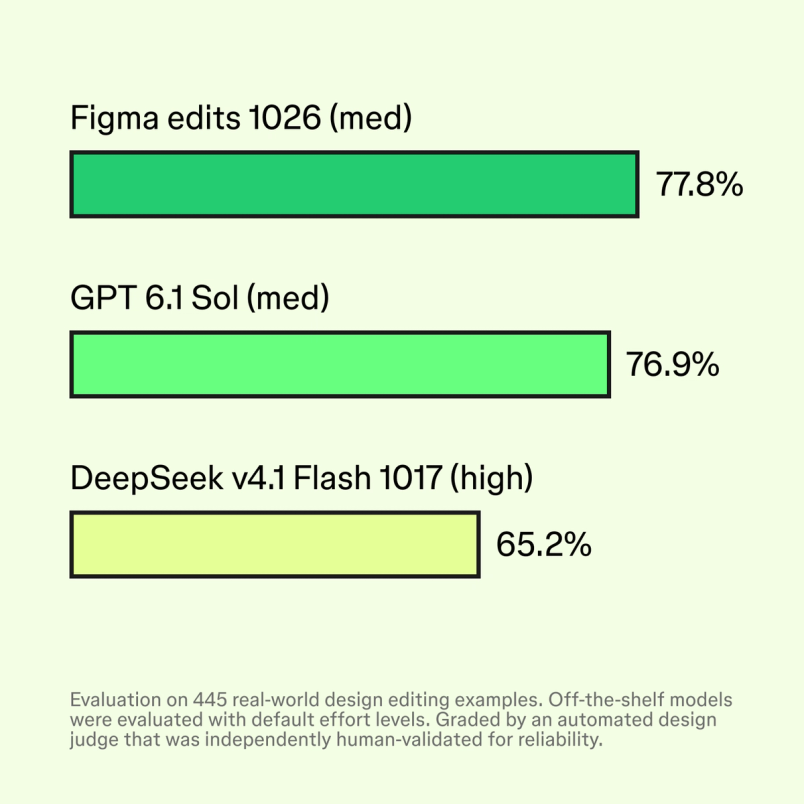
このチャートは、新しいエージェントが直接比較テストにおいて以前のプロダクションバージョンと同等またはそれ以上の性能を達成したという主張を裏付けています。