AIアシスタントは、信頼できそうに見えるものの検証可能な証拠を欠いた統計を頻繁に提供しており、Trakkr Researchはこの現象を「ゾンビ統計」と呼んでいます。これらは、ニュース記事、マーケティング資料、ブログ投稿など、さまざまなウェブページで繰り返されるものの、元の研究に一度もリンクされていない数値のことです。例えば、「営業担当者の44%は一度のフォローアップで諦める」という主張は、複数のAIモデルによって引用される一般的な数値です。しかし、この特定の数値を追跡すると、フリーランスのライターのサンプル記事と販売会社の統計ページで道が途切れており、どちらにもその数値を裏付ける実際の研究は含まれていません。
この調査のために、研究チームはChatGPT、Perplexity、Gemini、Claude、Google AI Overviewsの5つの主要なAIアシスタントによって提供された1,285の統計を分析しました。彼らは元のソースを見つけるために、各引用の軌跡を最大5ページまで追跡しました。その結果、これらの統計のうち、同じ数値を裏付ける研究に到達できたのはわずか40%でした。残りの数値は、行き止まりに終わるか、途中で文脈や値が変化していることが判明したか、あるいは完全に追跡不能でした。特筆すべき点として、ChatGPTは回答あたりの引用数が最も少なく(1.3)、ソースの特定成功率は最も高かった(57%)のに対し、ClaudeやGeminiなどの他のモデルは回答あたりの統計引用数が大幅に多かったものの、ソースの特定成功率は低くなっていました。
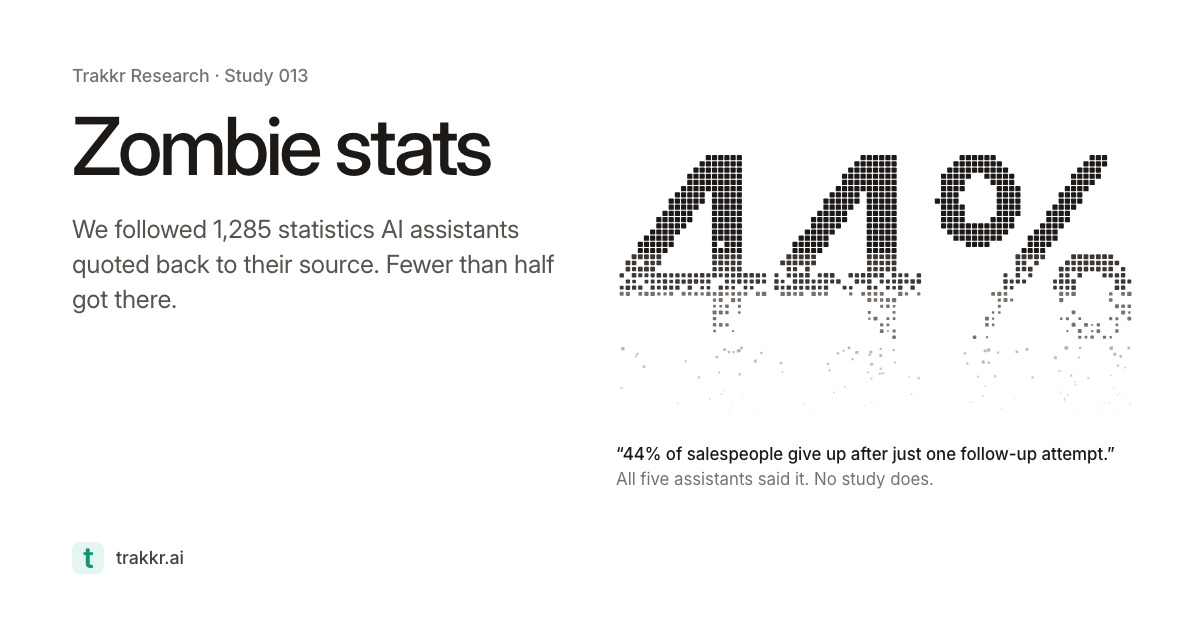
この画像は、数値が一次研究へのリンクなしにウェブページ間で繰り返されるという、第1段落で説明されているゾンビ統計の概念を説明しています。
この研究は、ソースの種類と一次研究を見つけられる可能性との間に重要な相関関係があることを浮き彫りにしています。AIアシスタントが政府のページや調査会社のページを引用した場合、軌跡は61%から62%の確率で一致する研究に到達しました。対照的に、最初の引用が企業のブログであった場合(これは全最初の引用の54%を占めた)、成功率は37%に低下しました。最終的に研究が見つかった場合でも、統計の17%は意味が「ドリフト(逸脱)」しており、研究の年、調査対象となった特定の集団、または測定されている指標に変更が生じていました。これは、AIモデルが一次研究よりも二次的なマーケティングコンテンツから数値を取得して繰り返していることが多く、データの正確性よりも回答の速さを優先している可能性を示唆しています。
この図は、ChatGPT、Claude、Geminiの特定のソース特定成功率と引用数に関する第2段落のデータを裏付けるものです。
この研究の大きな制限の一つは、軌跡の40%が「ロックされている、消去されている、または無反応」なソースで停止しており、それらの統計の真の起源が不明なまま残っていることです。さらに、この研究は、AIモデルが数値を完全に「捏造」することは稀であり、引用されたページ上の数値を正しく特定していることが多い一方で、一次研究の結果と二次的な要約を区別できていないことが頻繁にあることを示しています。これにより、ユーザーは自信を持って引用された回答を受け取るものの、それが実際には多くのソースによって繰り返されているだけで、実際のデータに根ざしていない「ゾンビ」数値であるというリスクが生じています。