多くのソフトウェアシステムは、HTTPメソッド(GET、POST)の識別、ヘッダー名の認識、またはコンパイラのキーワードの解析など、文字列を特定の値にマッピングすることに依存しています。C++において、標準的なアプローチは通常`std::unordered_map`を使用することです。しかし、この手法はキーがコンパイル時に既知である場合でも実行時のコストを伴います。標準的なハッシュテーブルは、文字列全体をハッシュ化し、バケットを選択し、潜在的な衝突に対応するために連結リストを走査する可能性があるため、キーセットが静的な場合には回避可能なオーバーヘッドが発生します。
この問題を解決するために、このライブラリはパーフェクトハッシュ関数を利用します。これは、固定されたキーセットに対して特別に設計された関数であり、2つのキーが同じスロットにマッピングされないことを保証します。このメカニズムは`gperf`ツールと同様の設計に従っており、特定の位置の文字によってインデックス付けされた関連テーブルの小さな値にキーの長さを加算することでスロットを計算します。このプロセスは`constexpr`関数を使用してコンパイル時に実行され、実行時のコストを最小限に抑えます。例えば、キーのルックアップには、スロットを決定するための数回のロードとビット演算(AND)が含まれ、その後に単一の比較が行われます。これにより、プロービングや衝突チェーンの走査の必要性が排除されます。
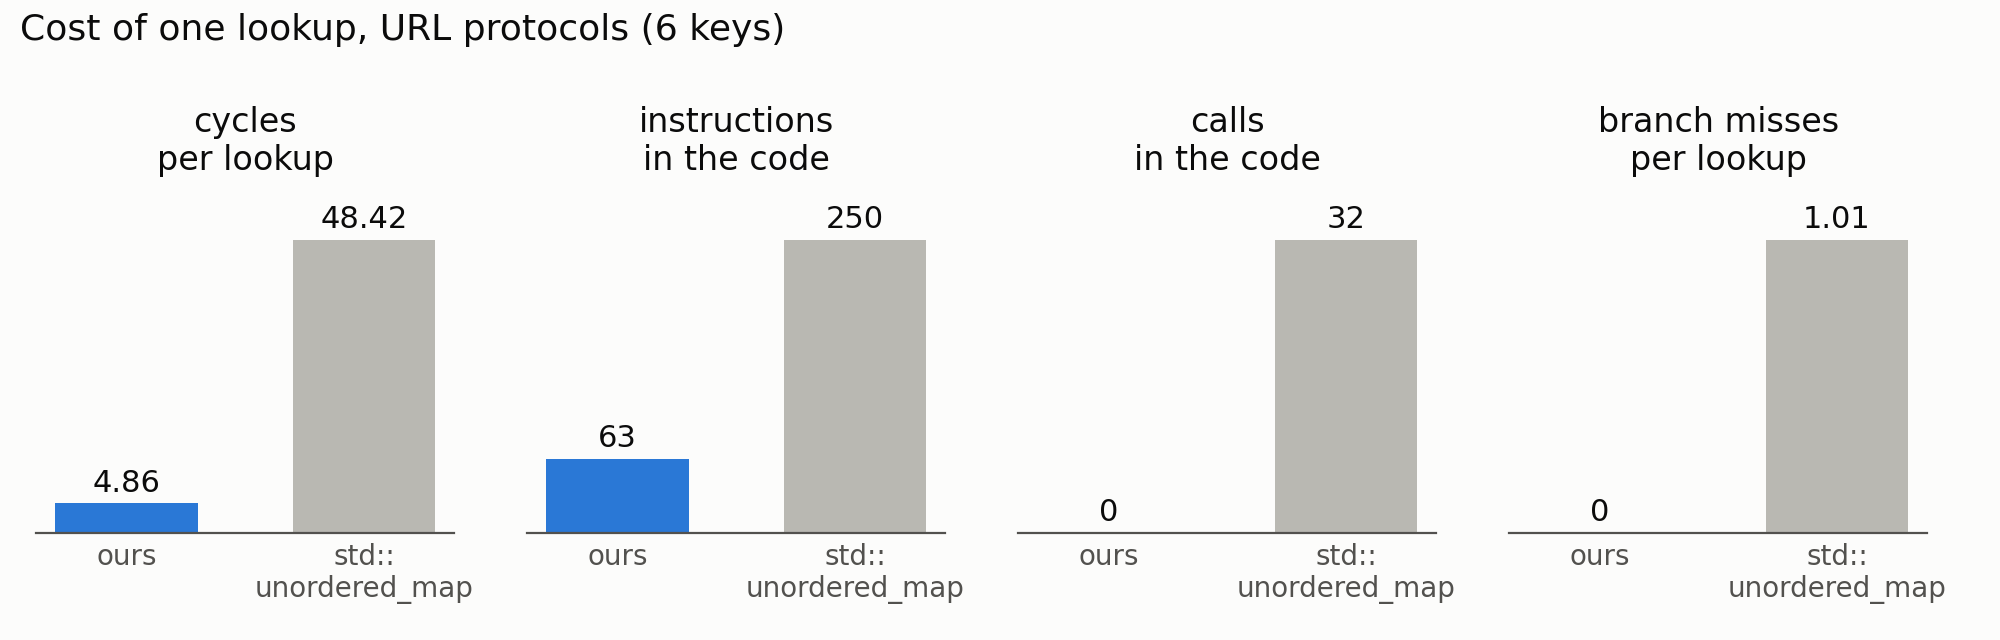
この視覚資料は、数回のロードとビット演算のみを含むルックアッププロセスの最小限の実行時コストを説明しています。
ハッシング以外にも、このライブラリはSIMD(Single Instruction, Multiple Data)命令を使用して文字列比較を最適化しています。複数の分岐を伴いながらバイトをループで処理する代わりに、システムはキーを16バイトのレジスタにロードし、シャッフル命令(ARM NEONの`tbl`など)を使用してキーの末尾以降のバイトをゼロにします。これにより、単一のベクトル比較でわずか数命令でキー全体を検証できます。Apple M3 Maxでのベンチマークでは、このライブラリはHTTPヘッダーに対して約1.3 nsのルックアップ時間を達成しており、`std::unordered_map`よりも最大13倍高速です。このアプローチは既知のキーに対して非常に効率的ですが、キーセットに変更があるたびにパーフェクトハッシュ関数を再計算する必要があるため、実行時にキーの追加や削除が行われる動的なセットにはあまり適していません。
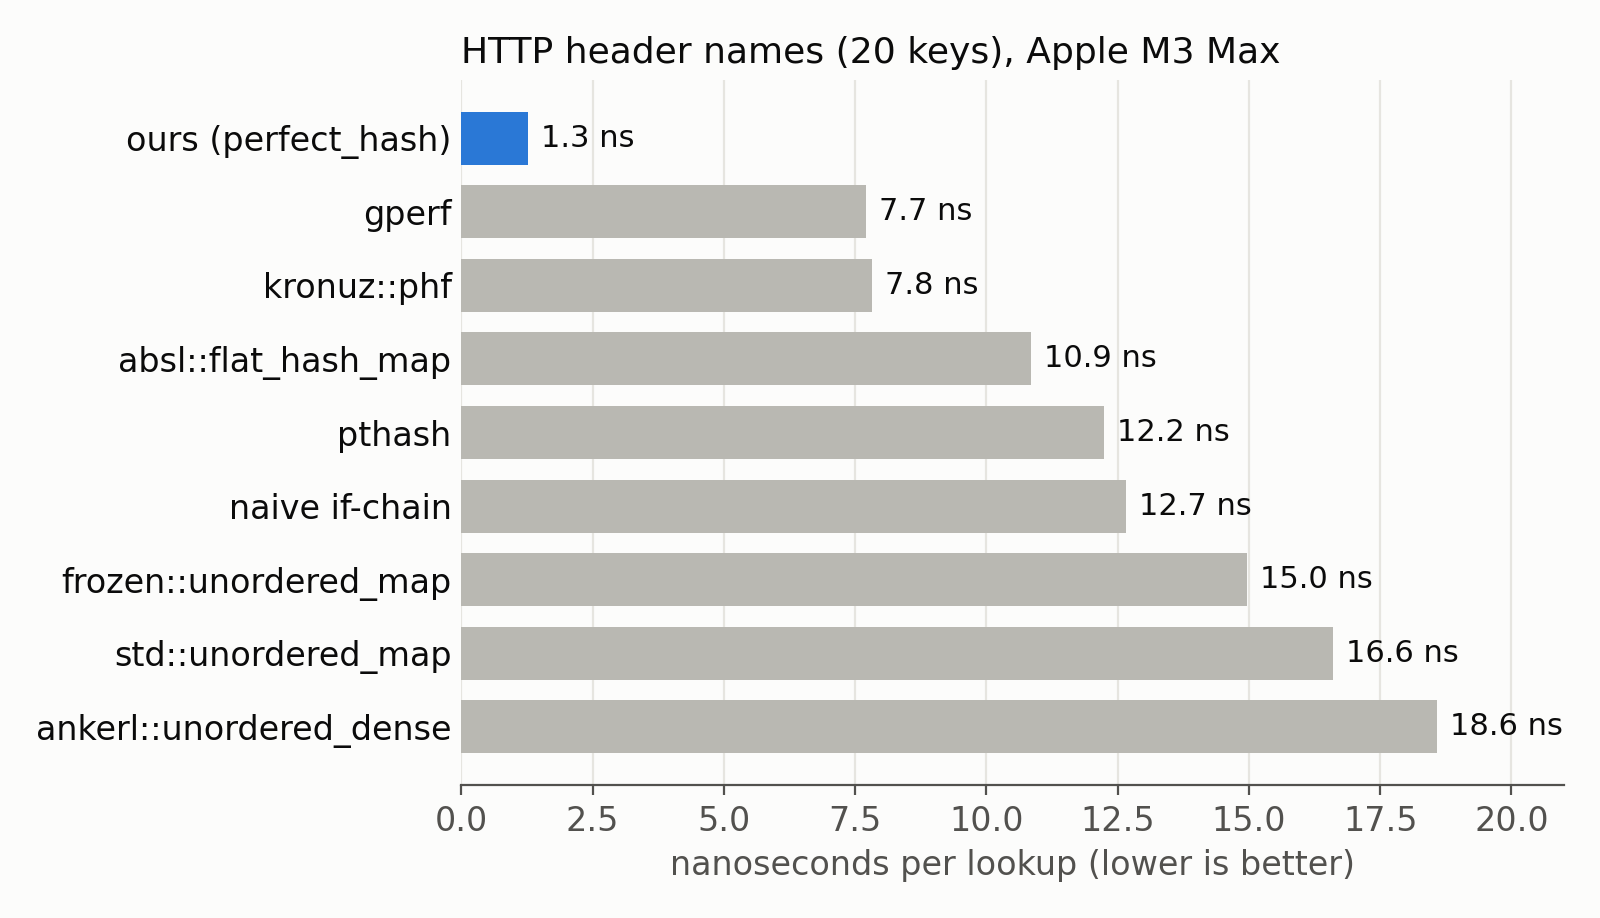
このチャートは、一般的なHTTPヘッダーに対して、標準的な実装よりもパーフェクトハッシュライブラリが大幅な速度優位性を持っていることを示しています。
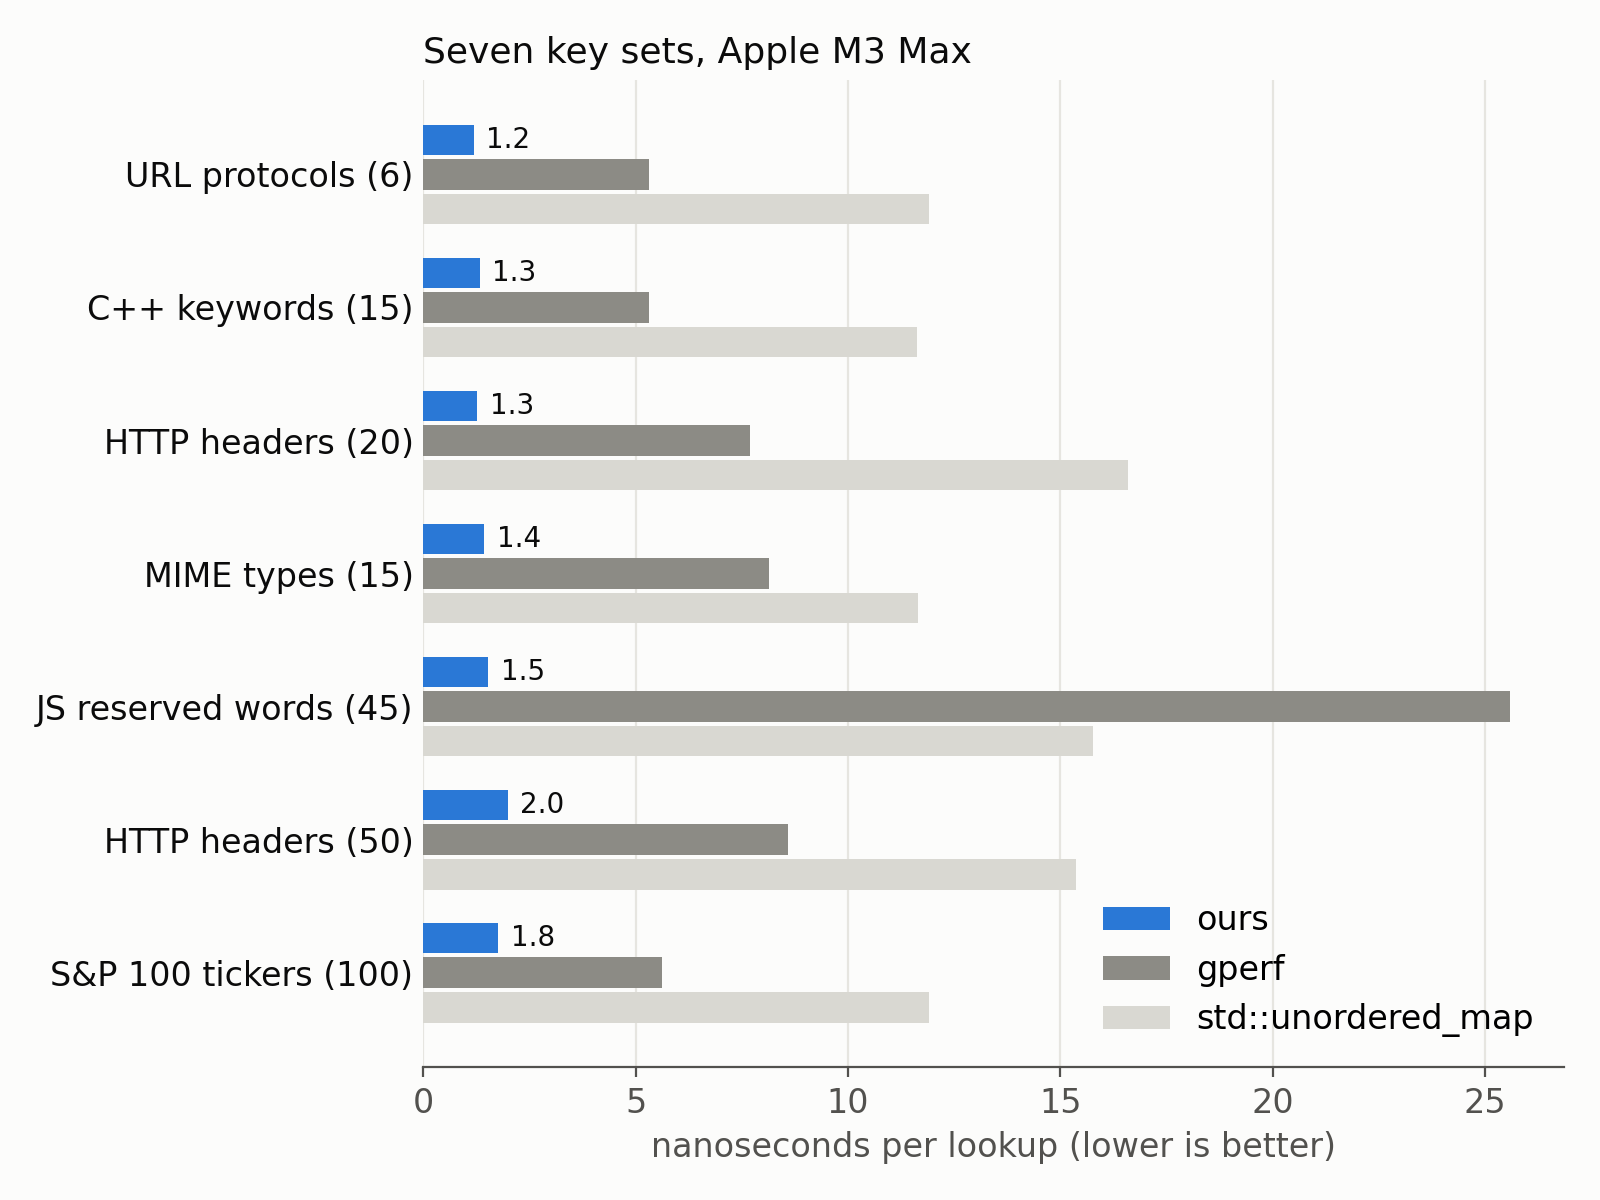
この図は、異なる種類の静的なキーセットに対するライブラリの効率性を実証し、その高速な性能を強調しています。