AI画像生成の展望は、初期の敵対的生成ネットワーク(GANs)から高度なマルチモーダルシステムへと急速に進化しました。初期のモデルは、人間の解剖学的構造や読み取り可能なテキストといった特定の詳細の描写に苦労していましたが、現代のイテレーションではこれらの問題の大部分が解決されています。例えば、手の描写の難しさは、モデルが手を構造的な構成要素としてではなく、テクスチャとして学習した結果であることが多々ありました。同様に、モデルが単なる単語ベースのトークンではなく、個々の文字にアクセスできるようにされたことで、テキストのレンダリングは大幅に改善されました。今日、この分野における主な違いは、より高速で再現性が高いことが多い拡散モデルと、同じアーキテクチャ内で言語と画像を処理することで優れた指示追従性とネイティブなテキストレンダリングを提供するマルチモーダルモデルの間にあります。
開発者やクリエイターにとって、適切なツールの選択はプロジェクトの具体的な要件に依存します。FluxやSDXLのような拡散モデルは、ローカルでの実行、バッチ処理、および「シード」(生成を開始するために使用される初期のランダムノイズ)を通じた一貫した結果を得るために好まれることが多いです。対照的に、ChatGPTやGeminiに統合されているようなマルチモーダルモデルは、対話的な編集や複雑なレイアウトの指示に優れています。しかし、これらのモデルは特定の出力寸法やシードに対する制御が制限されることがよくあります。制作における重要な実践的教訓は、ユーザーはコンテンツよりも「キャンバス」に対して対価を支払っていることが多いということです。同じサイズの単純な木製のテーブルと複雑な油絵は、通常、生成クレジットや計算時間の面で同じコストがかかります。
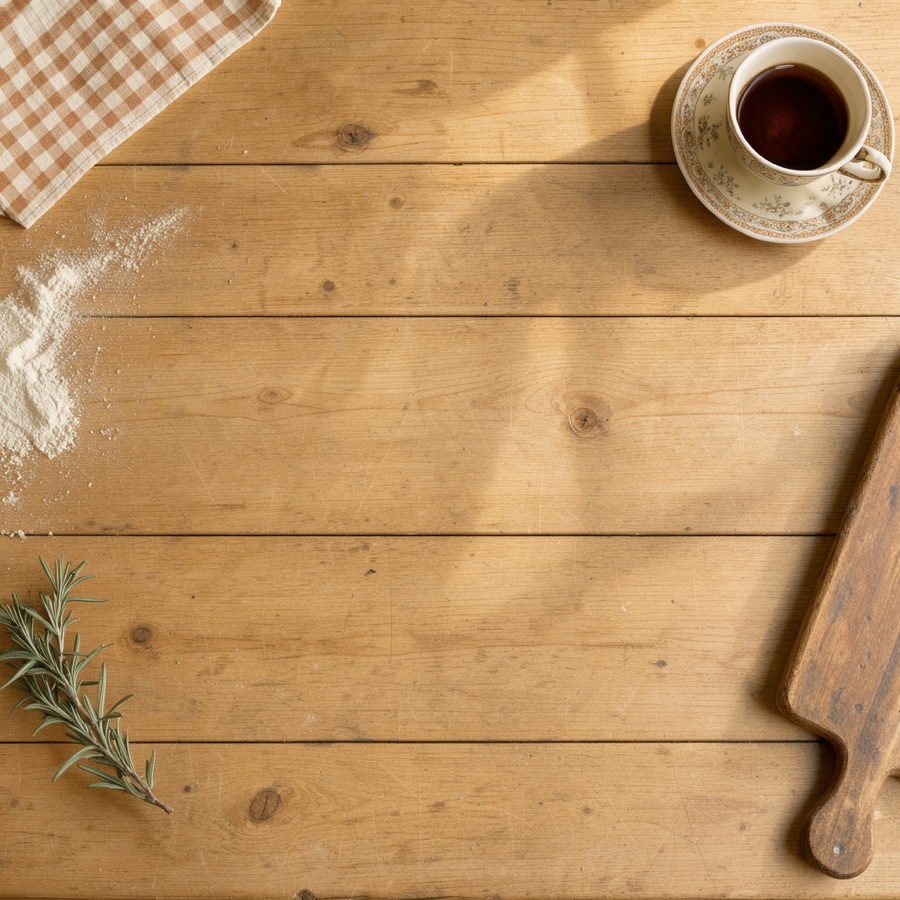
この画像は拡散モデルの出力の実践的な例であり、特定のシードとモデル選択を通じて達成可能な一貫した結果を示しています。
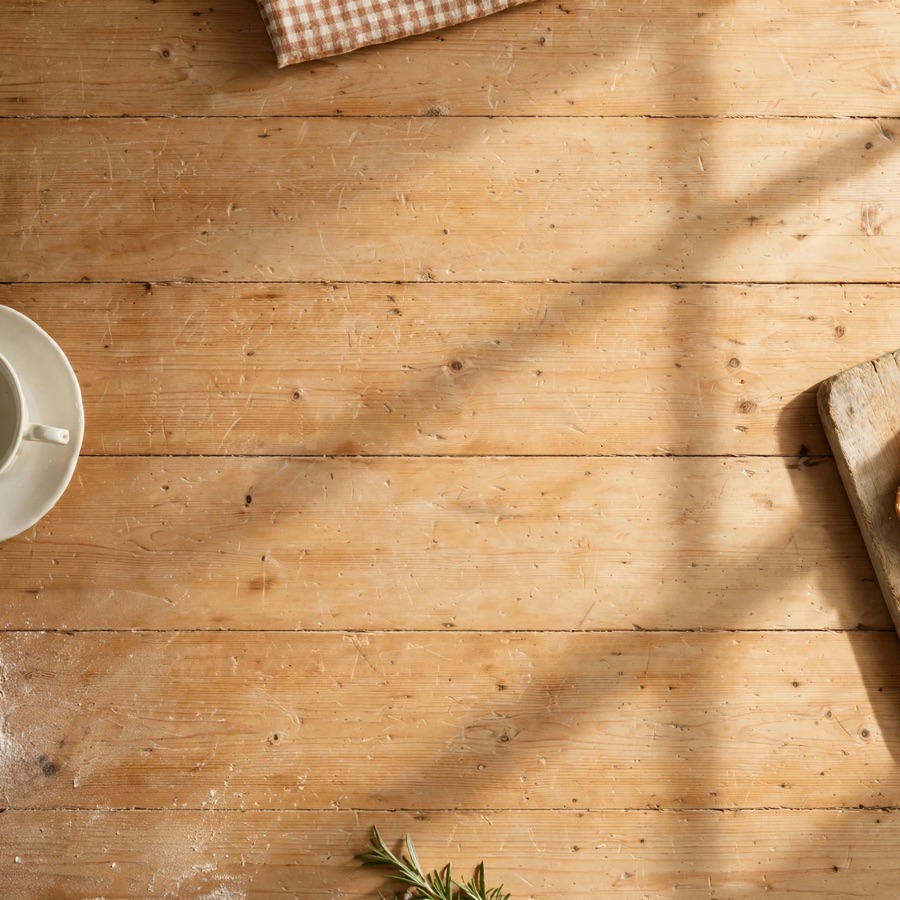
この画像はFLUXモデルとの直接的な比較を提供し、マルチモーダルモデルがキッチンテーブルという同じプロンプトをどのように解釈するかを示しています。
画像生成をプロダクションコードに統合するには、開発者が失敗や一貫性を処理する方法を変える必要があります。画像生成は「低速で失敗する可能性のあるジョブ」であるため、出力を非同期タスクとして扱うのが最善です。開発者は、APIが急速に変化し、モデルが頻繁に廃止または更新されることを考慮し、さまざまなプロバイダーの前に薄いインターフェースを置くことが推奨されます。UIデザインや特定のレイアウトのような高精度なタスクに対しては、ハイブリッドなアプローチが最も効果的であることが多いです。つまり、アセットのクリエイティブな生成にはAIを使用し、サイズ、透明度、パレットの適用といった正確な要件の処理には従来のコードを使用します。これにより、AIの「感性」と標準的なソフトウェアエンジニアリングの「精密さ」のバランスが保たれます。
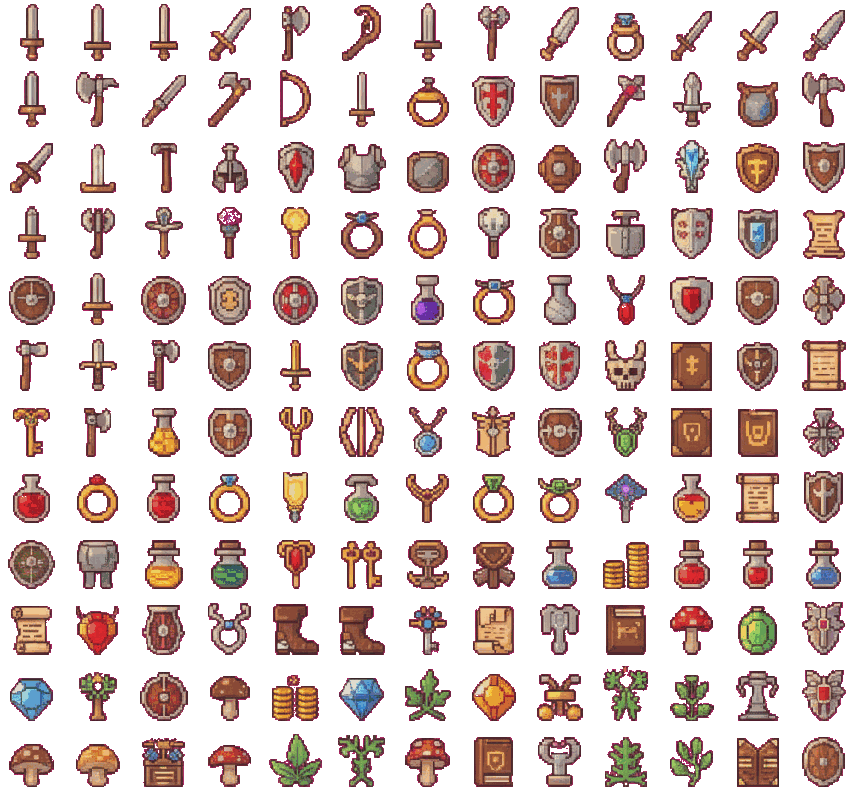
この画像は、クリエイティブな生成にはAIを使用し、正確なサイズと透明度には従来のコードを使用するハイブリッドアプローチを説明しています。
標準的な生成モデルに代わる新興の選択肢の一つとして、特にピクセルアートのようなスタイルにおいて、プロシージャルグラフィックスがあります。この手法は、完全なビットマップを生成する代わりに、LLMを使用してシーンを再現するための単純な描画命令のシーケンスを生成します。このアプローチは、グリッドのずれ、一貫性のないパレットの選択、高周波ノイズといった一般的な生成の問題を回避でき、純粋な拡散モデルの予測不可能性を伴わずに特定の美的目標を達成するための異なる道を提供します。
この画像は、記事で標準的な生成モデルよりもプロシージャルグラフィックスのユースケースとして議論しているピクセルアートの特定の美学を説明しています。
コストとアクセシビリティもエコシステム全体で大きく異なります。APIベースの生成価格は、モデルやプロバイダーによって、1枚あたり数分の一セントから15セント以上まで幅があります。ローカルでの実行はこれらのコストを排除しますが、Stable Diffusionのようなモデルには、少なくとも7GBのビデオメモリを持つGPUなどの重要なハードウェアを必要とします。最終的に、最も効果的なパイプラインは、AIのクリエイティブな強みと従来のコードの決定論的な信頼性を組み合わせ、洗練された実用的な結果を生み出すものです。