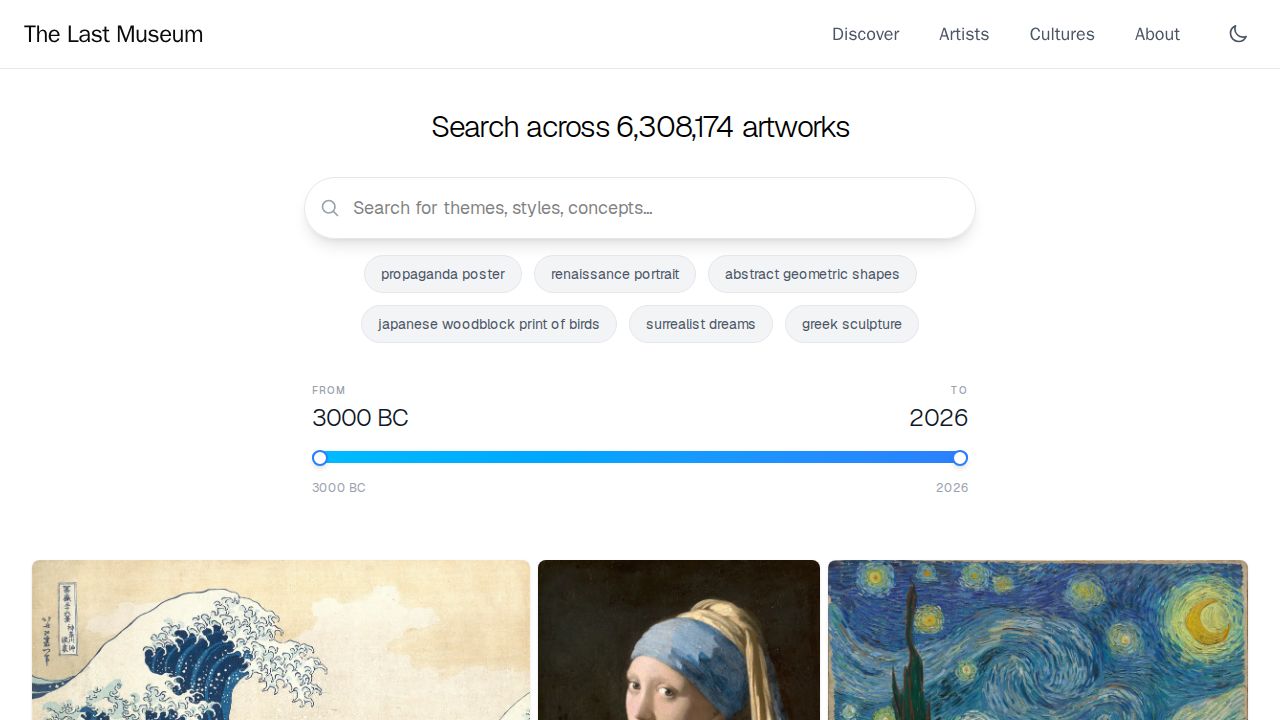
The Last Museumは、主要な美術館から収集された580万点以上の膨大な芸術作品のレポジトリにおいて、セマンティック検索を促進するために設計されたプロジェクトです。特定のメタデータやキーワード一致に依存する従来の美術館データベースとは異なり、このプラットフォームは人工知能を活用してクエリの概念的な文脈を理解します。これにより、ユーザーはテーマ、スタイル、または抽象的な記述に基づいて芸術作品を発見することができ、人類の集合的な芸術的成果の検索可能なインデックスを効果的に構築します。
プロジェクトに関する技術的な議論では、Gemmaファミリーなどの埋め込みモデル(embedding models)を使用してこれらの作品を処理およびインデックス化することが強調されています。これらのモデルは情報を高次元のベクトルに変換し、システムが概念空間における近接性に基づいて「類似した」アイテムを特定できるようにします。しかし、ユーザーはこのアプローチにおける実用的な課題を指摘しています。例えば、特定の歴史的人物やテーマに関する一部のクエリでは、審美的に類似しているものの文脈的に不正確な結果が返されることがあり、芸術的な意図のニュアンスを現在の埋め込みモデルが完璧に捉えることは難しい可能性を示唆しています。
このプロジェクトは美術史と対話するための斬新な方法を提供していますが、データの品質とユーザーエクスペリエンスに関する障害に直面しています。コメントでは、美術館のメタデータは詳細な説明から「テラコッタの壺」のような短いラベルまで一貫していないことが多く、それが基礎となる埋め込みの正確性に影響を与える可能性があることが指摘されています。さらに、堅牢なフィルタリングシステムがなければ、膨大な結果の量がナビゲーションを困難にする可能性があります。また、このようなツールの役割についても継続的な議論があります。アートをより身近にすることで人間の創造性を高める手段と見る人もいれば、デジタルインデックスは物理的な美術館展示のキュレーションされた解釈的な体験に取って代わることはできないと主張する人もいます。
さらに、このプロジェクトの範囲には複雑な著作権状況のナビゲートが含まれます。ユーザーからは、研究者や愛好家が法的に使用を許可されている作品を特定するのを助けるために、パブリックドメインフィルターの追加が必要であるとの提案が出ています。プロジェクトが進化するにつれ、膨大なデータセットの規模と、個々の芸術作品の独自の歴史を尊重する正確で文脈を意識した結果の必要性をどのようにバランスさせるかが注目されます。
最終的に、The Last Museumは「インテリジェント」な発見への移行を象徴しています。手動によるカタログ作成の限界から脱却することで、本来なら隠れたままになっていた作品間のつながりを表面化しようとしています。それが芸術発見の主要なツールとなることに成功するかどうかは、検索の正確性を洗練させ、数百万の項目に対してより管理しやすいインターフェースを提供できるかどうかにかかっています。
議論された主要な技術的および概念的なポイントは以下の通りです: - 逐語的な検索ではなく、概念的な検索を促進するための埋め込みモデルの使用。 - 検索の信頼性に影響を与える、一貫性のない美術館メタデータの課題。 - 自動化された発見と、伝統的な美術館のキュレーションされた体験との間のトレードオフ。 - パブリックドメインの作品と保護されたコンテンツを区別するための著作権フィルターの必要性。 - 関連する歴史的文脈を表面化することで、AIが人間の創造性をサポートする可能性。
証拠: - 580万点の芸術作品に対するセマンティック検索というプロジェクトの主な目標は、一次ソースによって確立されています(primary)。 - 現在の埋め込みモデルの限界と、一貫性のないメタデータの影響に関する議論は、Hacker Newsのスレッド(hn-50194522)に記録されています。
編集ノート: - この記事は、芸術におけるセマンティック検索の技術的および概念的な影響に焦点を当てています。 - ユーザーのフィードバックで強調された、AI駆動による発見の限界について言及しています。 - キーワード検索とセマンティック埋め込みの違いを明確にしています。
editorial.evidence_sufficient: true}],